音声AIの300ms
人はなぜAIとの会話に違和感を覚えるのか
音声AI レイテンシ 設計 | 話し終えてから最初の音までを縮める
Zenn累計32,000+ views · 4言語で30冊以上出版 · Kindle 6カ国で販売中
📖 無料で読める章
買う前に3章をその場で読めます。気に入ったらKindleで続きを。
01 前書き: 0.3秒の壁
 AIに話しかけたあとの沈黙。本書は0.3秒を、この間が違和感に変わり始める目安として扱う
「こんにちは」
ユウはできるだけ自然に話しかけた。音声AIプロダクトの初回デモ。6ヶ月の開発期間を経て、ついに投資家の前でプレゼンする日が来た。
沈黙。
1秒。2秒。
「フリーズしました?」
投資家の表情が変わった瞬間を、ユウは忘れない。
AIはちゃんと答えた。「こんにちは、何かお手伝いできることはありますか?」音声合成も自然だった。レスポンスの内容も完璧だった。でも、遅すぎた。
その日の夜、オフィスに残ったユウの前にMacBookの画面があった。Googleスプレッドシートに計測結果が並んでいる。
1.8秒。2.1秒。1.9秒。
どのテストケースも、1.5秒を超えていた。
「これじゃ会話にならない」
独り言が、静かなオフィスに響いた。
その瞬間から、ユウの 300ms への挑戦が始まった。
本書は、音声AIエンジニア ユウとUXデザイナー ミサキが、人間らしい会話を目指して遅延と格闘する物語と、その背景にある技術の解説でできています。ユウとミサキは架空の人物で、二人が測った1.8秒や350msといった値は、物語の中の二人の実測値です。一般論として示す数字とは分けて書き、一般論の数字には出典の名前を添えます。書誌とURLは各章末と巻末の参考文献に載せています。
本書の内容には、著者がWebRTCを用いたリアルタイム通信プロダクトの開発に長年携わり、さらにAIとの会話プロダクトを設計・構築した際に得た現場の知見を随所に盛り込んでいます。OpenAI Realtime API、Gemini Live API、Pipecat、LiveKitなどの技術情報やベンダー比較は、2026年3月の執筆時点の情報を元にし、2026年9月の改訂で出典を確認し直しました。この領域の仕様や数値は変わりやすいので、採用の前には最新の公式情報を確かめてください。
人間同士の会話では、相手が話し終わってから自分が話し始めるまでの間は、200ミリ秒前後に集まります(第1章)。一方、2025年に発表されたターンテイキング研究のサーベイ(Castillo-Lópezら)は、先行研究を引いて、現在の音声対話エージェントは700〜1000ミリ秒の間を空けてから話し始める、と述べています。多くのシステムは、沈黙が一定時間(例えば700ミリ秒)続くのを待ってから、相手が話し終えたと判断するからです。人間の3〜5倍。本書は、この差を音声AIの「違和感」の中心にあるものと見ています。
本書では、ユウとミサキの軌跡を辿りながら、著者の実務経験と最新の技術動向を交えて、音声AIにおけるレイテンシを以下の観点から体系的に解説します。
- 人間の会話はどのくらいの速さで回っているのか (第1章)
- 何秒を超えると体験が崩壊するのか (第2〜4章)
- なぜ遅延が生まれるのか (第5〜6章)
- どうすれば速くできるのか (第7章)
- 速くできないとき、どう誤魔化すのか (第8章)
- 「遮らない」と「遅れない」をどう両立するのか (第9章)
- 既存の音声アシスタントから何を学べるか (第10章)
- エッジAIで300msの壁を越える方法 (第11章)
- ここまでの知見を、実装時に使うチェックリストにする (第12章)
本書に登場する主な数字は以下の通りです。数字の出どころは3種類あります。研究で観測された値、ベンダーの公表値、そして本書の設計目安です。表の「種類」の列で区別しています。
| 数字 | 意味 | 種類 |
|---|---|---|
| 200ms前後 | 人間同士の会話で、話者が交替するときの間(「はい/いいえ」で答える質問への返答で調べた値) | 研究で観測された値。Stiversら 2009(第1章) |
| 300ms | 雑談のテンポを保つための目標 | 本書の設計目安(第4章) |
| 400ms | ドハティの閾値。1982年の端末作業の研究で、応答がこれより速いと生産性が上がると報告された | 研究で報告された値。Doherty and Thadhani 1982(第2章) |
| 500ms | ユーザーが被せて話し始めやすくなる線 | 本書の設計目安。根拠はVapi、AssemblyAIの説明(第4章) |
| 800ms | 会話の破綻が目立ち始める線 | 本書の設計目安。根拠はRetell AIの比較記事ほか(第4章) |
| 1.5秒 | 体験が急速に劣化しうる線 | ベンダーの説明。Cresta(第4章) |
| 4秒 | VR内の対話エージェントの実験(遅延1.5秒/4.0秒/6.5秒の3条件)で、4秒を超えると体験の評価が下がった | 研究で観測された値。Maslychら 2025(第2章) |
本書の主指標は「ユーザーが話し終えてから、最初の音が聞こえるまで」(E2E / TTFA)です。起点はユーザーの声が実際に止まった時点で、システムが「話し終えた」と判定するまでの待ち時間もこの区間に含めます。設計目安の数字は、この区間を自分のシステムで測って当てはめてください。
0.3秒は、本書が設計の目標として置く数字です。この短い時間に、話し終えたかどうかの判定、音声認識、言語モデル、音声合成、ネットワークの往復、再生の開始までを収める方法を、ユウとミサキと一緒に探していきます。
読み終えたときには、自分のシステムの遅延を区間ごとに測り、どこから削るか、削りきれない分をどう埋めるかを決められるようになっているはずです。ユウたちと同じ遠回りをせずに済むよう、彼らのつまずきも隠さずに書きました。
この続きはKindleで →02 第1章: 人間の会話は200msで回っている
ミサキがコーヒーカップを置く音が、静まり返ったオフィスに響いた。
 静まり返ったオフィスに、カップを置く小さな音だけが広がる
「ユウ、提案があるんだけど」
前日のデモ失敗からまだ立ち直れずにいるユウを見かねて、ミサキは口を開いた。
「人間同士の会話を録音して分析してみない?AIと何が違うのか、数字で見てみよう」
「データがないと始まらないよね。今日の昼間、私たちの会話も録音させて」
世界共通の「間」
人間の会話のリズムには、言語をまたいで共通する部分があります。
2009年、Max Planck Institute for Psycholinguisticsを中心とするTanya Stiversらの研究チームは、10言語(英語、日本語、デンマーク語、オランダ語、イタリア語、韓国語、ラオ語、ツェルタル語、イェリ・ドニェ語、ǂĀkhoe Haiǁom語)の自然な会話の記録を集め、話者交代(ターンテイキング)のタイミングを比べました。条件をそろえるため、調べたのは「はい/いいえ」で答えられる質問と、その返答の間です。
結果ははっきりしていました。 どの言語でも、返答までの間の最頻値は0〜200msの範囲に入っていました。 全データの平均は約208msです(Stiversら 2009)。
200ms。0.2秒です。
その日の夜、ユウが自分たちの会話を解析したとき、驚きとともに現実を受け入れざるを得なかった。「やっぱり200msだ。俺たちのAIは2秒。10倍遅い」
言語による差もあります。言語ごとの平均は、最も短い日本語で約7ms、最も長いデンマーク語で約469msでした。それでも、どの言語でも話者の重なりを避け、沈黙を短くしようとする傾向は共通していました。Stiversらは、言語間の差が実際より大きく感じられるのは、人が小さな時間差にも敏感だからだろう、と論じています。
200msの意味
一方で、言葉を話し出すには時間がかかります。絵を見てその名前を言う実験課題では、言い始めるまでに平均約600ms、名詞を2つ言うなら740〜800msかかると見積もられています(Levinson and Torreira 2015 のまとめ)。自然な会話で測った値ではありませんが、会話の間の3倍以上です。
相手の発話が終わってから準備を始めたのでは、200msで話し始めることはできません。相手が話し終わる 前に 、返答の準備を始めている必要があります。
Levinsonらは、聞き手は相手の発話がまだ続いているうちに、相手の言いたいことが見えた時点で自分の返答を組み立て始めている、と論じています。予測しながら聞き、先に準備しておくというモデルです。本書では、これを 聞きながら考える 並列処理と呼びます。これは第7章で解説するストリーミング設計の着想源でもあります。
「人間は並列処理してるのか」ユウが呟いた。「俺たちのAIは逐次処理。聞く、考える、話すを一個ずつやってる。そりゃ遅いわけだ」
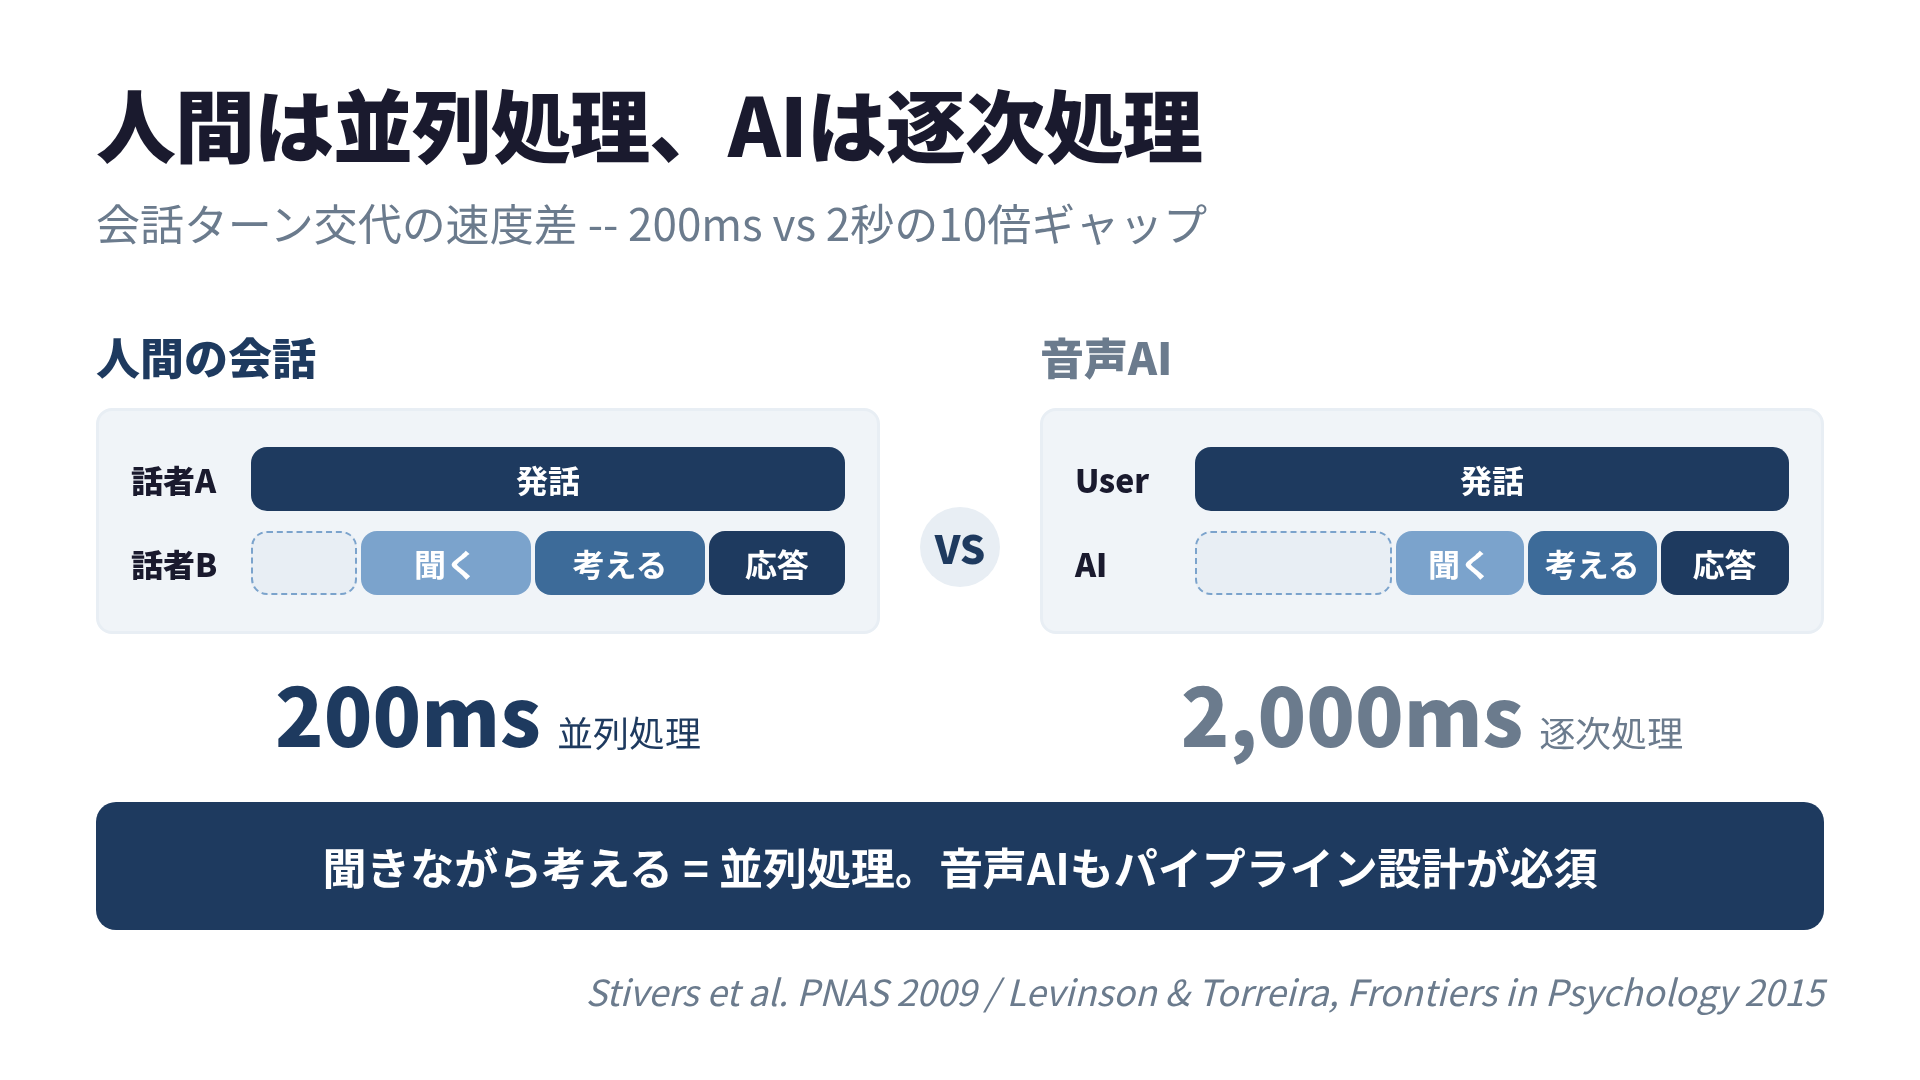 人間は相手の発話中に返答を準備し、200ms前後で話し始める。ユウたちの逐次処理のAIは、発話が終わってから動き出し、約2秒かかっていた
200msより長い間
すべての話者交代が200msで起きるわけではありません。Stiversらのデータでも、言語ごとの平均には数百msの幅がありました。
音声AIの文脈では、Speechmaticsの機械学習エンジニアAaron Ngがブログ記事で、人間の会話でターン間の典型的な間は約600msだ、と書いています。この長さの間は、聞き手が話の内容を受け止めているという、思慮深く丁寧な印象を与えうる、という見方です。同じ記事は、話し終えてから200msで返す音声エージェントは技術的には見事でも自然には聞こえない、とも述べています。研究論文ではなく、1社のエンジニアの見解として読んでください。測り方や対象とした会話の種類は書かれておらず、Stiversらの最頻値と並べて比べられる数字でもありません。
では、間がどこまで長くなると聞き手は不安になるのか。本書が参照した資料には、この境目を1つの数字で示したものはありません。会話の内容、相手との関係、文化、そしてシステムが「話し終わった」とどう判定するかで変わるからです。音声AIでの目安は、第4章で「3つの崖」として整理します。
音声AIへのインプリケーション
この研究から、音声AIの設計者が知るべきことは3つあります。
1. 200msは人間同士の会話の基準点
少なくとも「はい/いいえ」で答える質問への返答では、間の最頻値は言語を問わず0〜200msに集まります。話し始める準備に600ms以上かかることを考えると、予測と事前の準備があって初めて出せる速さです。音声AIが「自然な会話」を目指すなら、この基準点との距離が1つの物差しになります。
2. 聞きながら考える設計が要る
200ms級の速さを狙うなら、ユーザーの発話を処理しながら応答を準備するパイプライン設計が必要です。発話が完全に終わってから処理を開始する逐次処理では、間に合いません。ただし、先に準備を始めるほど、ユーザーの話がまだ続くのに先走る誤りも起きやすくなります。どこまで先読みするかは、用途とターン終了判定の精度との兼ね合いで決めます(第9章)。
3. 間を埋める手はあるが、条件付き
200msで返せないとき、フィラー(「そうですね」「えーと」)で間を埋める手があります。ただし、ユーザーがまだ話し続けるつもりだった場合、フィラーは割り込みになります。発話が終わったという確信が持てるときに使い、効果は用途ごとにユーザー評価で確かめてください(第8章、第9章)。
翌朝、ミサキはユウのデスクに印刷した資料の束を置いた。「Jakob Nielsenの古い記事見つけた。これ、ヤバいよ」
この続きはKindleで →参考文献
- Stivers, T. et al. “Universals and cultural variation in turn-taking in conversation.” PNAS, 2009.
- Levinson, S. C. and Torreira, F. “Timing in turn-taking and its implications for processing models of language.” Frontiers in Psychology, 2015.
- Speechmatics. “Your AI Assistant Keeps Cutting You Off. I’m Fixing That.” 2025.
03 第2章: Nielsenの3閾値を音声UIに翻訳する
朝9時のMTGルーム。ミサキは印刷した記事をテーブルに広げていた。
「ユウ、Jakob Nielsenって知ってる?UX界の大御所よ。この話、元は1993年の本なんだけど、今でも通用する」
昨日の200msショックでまだ混乱しているユウの前に、ミサキは数字の表を示した。
「100ms、1秒、10秒の3つの壁がある。うちは1秒超えちゃってるから、“体験が途切れる”ゾーンにいる」
ユウが目を細めた。「これ、音声UIにも当てはまるの?」
「それを確かめたいの」
GUIの古典を音声に適用する
1993年、ヤコブ・ニールセンは著書『Usability Engineering』で、UIの応答時間に関する3つの閾値を整理しました。同書第5章の抜粋が、Nielsen Norman Groupの記事「Response Times: The 3 Important Limits」として公開されていて(2014年に追記あり)、30年以上経った今でも、UXデザインの基礎として広く参照されています。
| 閾値 | GUI での意味 |
|---|---|
| 0.1秒(100ms) | 操作が瞬時に反映された感覚。直接操作している実感 |
| 1秒 | ユーザーの思考フローが維持される限界。遅延は感じるが集中は途切れない |
| 10秒 | ユーザーの注意が完全に離れる。タスク放棄のリスク |
これらの数字は、コンピューターの性能ではなく人間の認知特性に基づいています。Nielsenは、応答時間についての基本的な助言は1968年のMillerや1991年のCardらの頃からほぼ同じだ、と整理しています。
音声UIでは閾値が「縮む」
GUIでは1秒の遅延が許容されます。ユーザーは画面を見ながらローディングインジケーターを確認できるからです。
音声UIでは事情が異なります。
音声は、言ったそばから消えていきます。
テキストチャットであれば、1秒待っても画面上に「入力中…」の表示があり、その間に前のメッセージを読み返すこともできます。音声だけのUIには、画面に残り続ける表示がありません。聞き返すことはできても、待っている間に目で確かめられる手がかりがないのです。沈黙は、ただの沈黙です。
「そうか」ユウが頷いた。「画面がないから、手がかりがない。音だけの世界は厳しいな」
そこで本書では、GUIの閾値を音声UI向けに次のように読み替えて、設計の目安にします。GUIの閾値を音声に当てはめ直して確かめた研究があるわけではありません。本書の仮説として読んでください。
| GUI | 音声UI(本書の目安) | 理由 |
|---|---|---|
| 0.1秒 | 変わらず | 瞬時と感じる限界は、音声でも同じと仮定する |
| 1秒 | 300-500ms | 視覚フィードバックがないため、沈黙が長く感じられやすい |
| 10秒 | 4秒 | 進捗表示や画面の履歴に頼れず、待っていることを確かめる手段が少ない |
4秒には、実験の裏付けが1つあります。Maslychらは ACM CUI 2025 で、VR空間の中で、LLMを使った対話エージェントと自由に会話する実験を報告しました。応答の遅れを1.5秒、4.0秒、6.5秒の3段階に変え、フィラーの有無と組み合わせて54人に評価してもらっています。著者らは、 4秒を超える遅延は体験の質を下げる と結論づけ、自然なフィラー(「うーん」などの言葉と、考えるしぐさを組み合わせた間つなぎ)は4.0秒と6.5秒の条件で応答時間の感じ方を改善した、と報告しています。4秒ちょうどを境目として測ったわけではなく、1.5秒、4.0秒、6.5秒の3条件を比べた結論です。
ただし、身体を持つエージェントとの実験なので、音声だけのUIにそのまま当てはまるとは限りません。フィラーも言葉としぐさを組み合わせた条件で、声だけのフィラーの効果を単独で測ってはいません。最も短い条件が1.5秒なので、1秒より短い範囲についても何も言っていません。本書では4秒を「これより前に、何らかの手を打っておく線」として使います。
ミサキがホワイトボードに数字を書き出した。「目標が見えた」とユウが呟いた。「300msから500msの間で、何らかの反応を返す。それが音声UIの生命線だ」
もう1つの基準線、ドハティの閾値
1982年、IBMのWalter J. DohertyとAhrvind J. Thadhaniは、社内の技術報告書で、コンピューターの応答時間が0.4秒以内であれば、ユーザーの生産性が大幅に向上することを報告しました。これが「ドハティの閾値」です。
ドハティの閾値は、400ms以内の応答なら、ユーザーは操作と反応を途切れのない1つの流れとして感じ、 「待っている」という意識が生まれにくい 、という形で広く紹介されています。待ち時間の感じ方そのものは、第3章で扱います。
もともとは端末作業の生産性を調べた数字で、音声の「ユーザーが話し終えてから、最初の音が聞こえるまで」を測ったものではありません。本書では、この区間で最初の反応を返す目安として400msを借ります。話し終わってから400ms以内に何らかの反応(フィラーでも可)が聞こえれば、「聞こえている」という手がかりをユーザーに渡せる、というのが本書の仮説です。400msで足りるか、短すぎるかは、自分のサービスのユーザーテストで確かめてください。
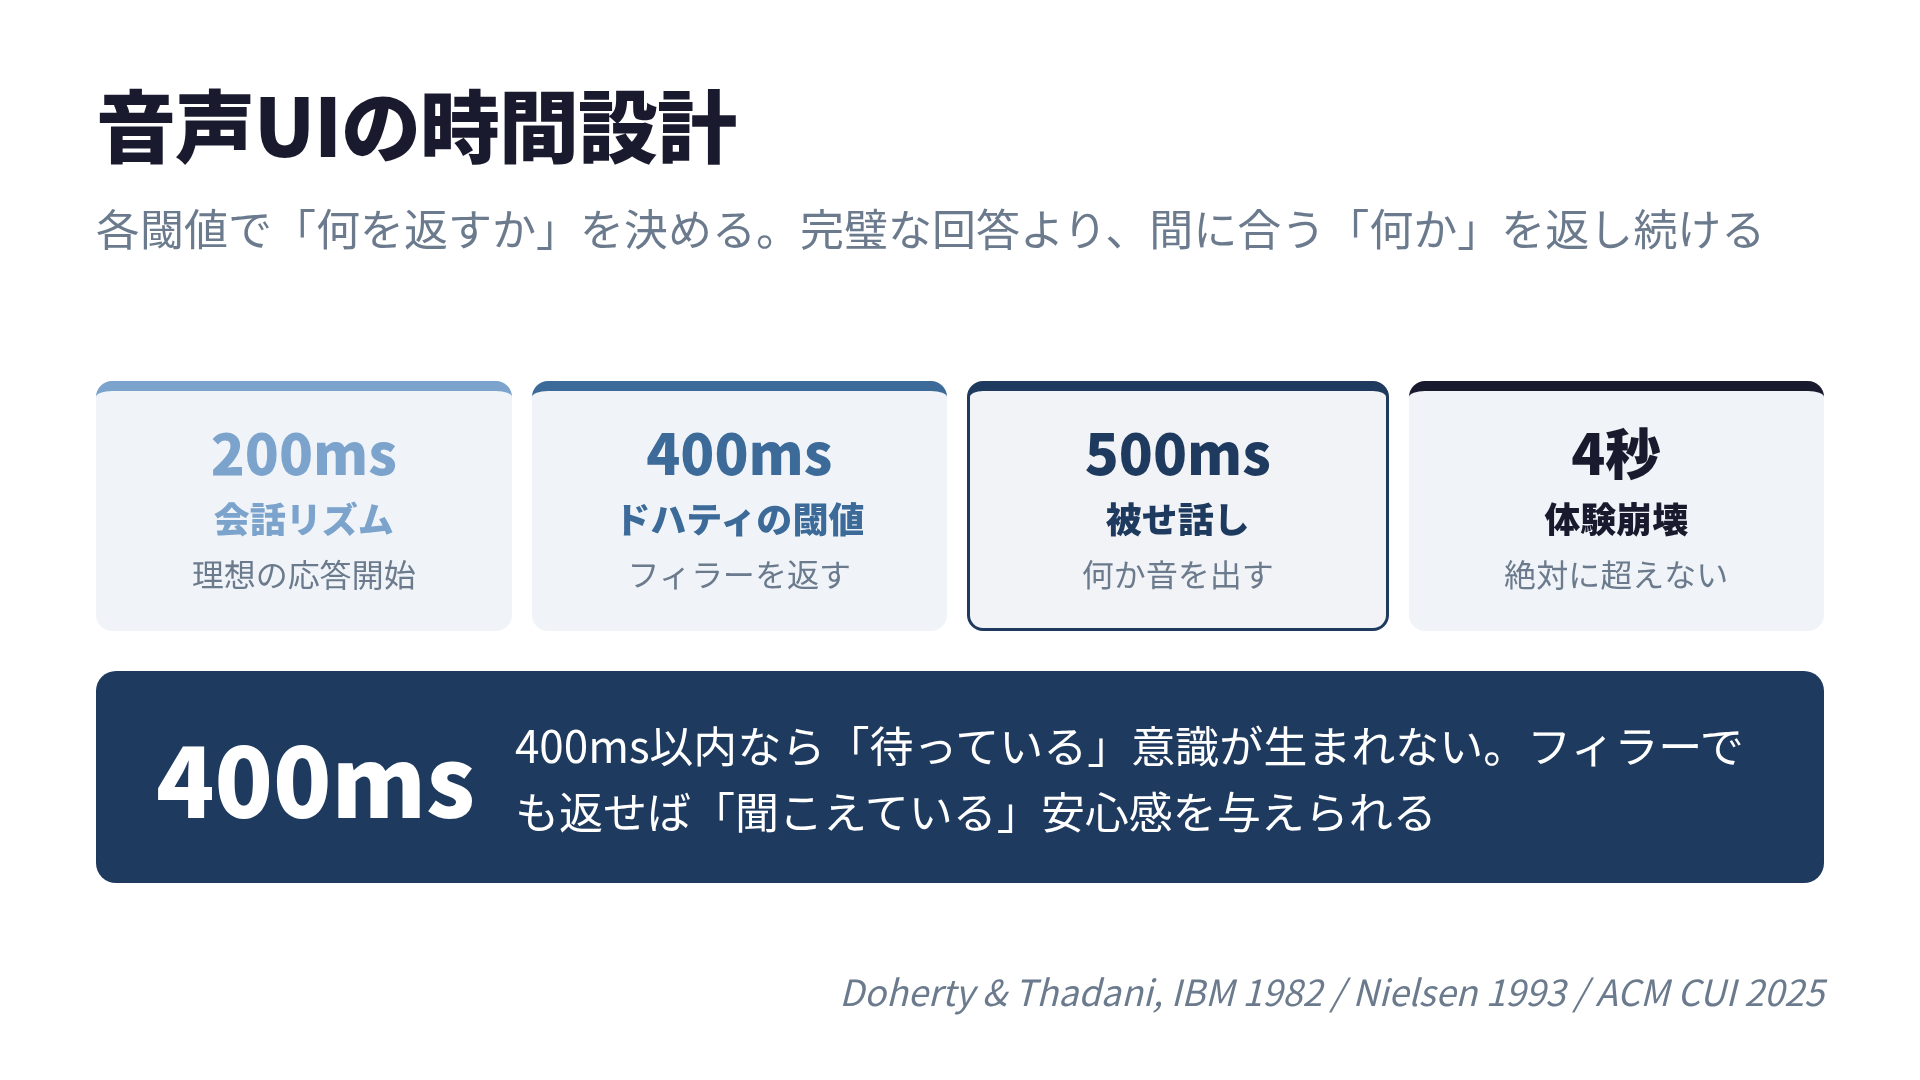 主な4つの目安(200ms、400ms、500ms、4秒)ごとに、何を返すかを決める。数字は本書の設計目安
まとめ: 音声UIの時間設計
次の表の数字は、本書の主指標「ユーザーが話し終えてから、最初の音が聞こえるまで」に当てはめる設計目安です。元の研究が測った区間(GUIの処理が終わるまで、端末が応答するまで、など)とは違うので、どれもユーザーテストで確かめる前提の仮説として使ってください。
| 閾値 | 音声AIでの意味 | 設計指針 |
|---|---|---|
| 100ms | 瞬時の反応(Nielsen) | 音声入力の受信確認(ビープ音等) |
| 200ms | 人間同士の会話リズム(第1章) | 理想的な応答開始タイミング |
| 400ms | ドハティの閾値 | フィラーか最初の音声を返す |
| 500ms | ユーザーが待ちきれずに話し始め、AIの応答と重なりやすくなる線(第4章) | ここまでに何か音を出す |
| 1秒 | Nielsenの「思考の流れが途切れない限界」をそのまま借りた警戒線 | 本題の回答がまだなら、処理中であることを伝える |
| 4秒 | VR内のエージェントの実験で、体験の評価が下がった線 | それより前にフィラーや途中経過で手を打つ |
300-500msは最初の反応を返す目標、1秒はそれでも本題の回答が始まらないときの警戒線、という役割分担です。音声AIの時間設計とは、これらの閾値を意識しながら「どの段階で、何を返すか」を決めることです。完璧な回答を待って全部返す設計では、ほぼ確実に1秒を超えます。
たとえば400msまでに相づちで受け取ったことを伝え、1秒を超えそうなら「調べています」と処理中であることを伝え、回答は準備できた部分から話し始める。 各閾値に間に合う「何か」を返し続ける のが、本書の時間設計の考え方です。
「でも、理論だけじゃダメ」ミサキがペンを置いた。「実際にユーザーがどう感じるか、テストしてみよう」
この続きはKindleで →参考文献
- Nielsen, J. “Response Times: The 3 Important Limits.” Nielsen Norman Group, 1993 (2014追記).
- Doherty, W. J. and Thadhani, A. J. “The Economic Value of Rapid Response Time.” IBM Technical Report GE20-0752-0, 1982.
- Maslych, M. et al. “Mitigating Response Delays in Free-Form Conversations with LLM-powered Intelligent Virtual Agents.” CUI ‘25 (ACM), 2025.
本書の概要
音声AIのレイテンシ設計。人の会話は約200msで回る。300/500/800msを目安に、525msのカスケードをストリーミングと知覚ハックで縮める。
この本でできるようになること
- Nielsenの応答時間の閾値やドハティの閾値を、音声UIの設計目安に置き換えて考えられる
- 「話し終えてから最初の音が聞こえるまで」を主指標に、STT・LLM・TTSの各段の時間を分けて測れる
- 文単位のストリーミングで、全文を待たずに最初の音を早める設計が分かる
- フィラーや先行生成など、遅延を消さずに待ち時間を短く感じさせる手法を選べる
- VADの誤判定を理解し、ターン検出モデルで「遮らない」と「遅れない」を両立させる考え方が分かる
対象読者
- 【音声AI開発者】カスケードパイプラインの遅延に悩んでいる人
- 【WebRTCエンジニア】既存のVoIP/SIPの知見をAI音声に応用したい人
- 【UX設計者】会話の自然さを数字で設計したい人
- 【プロダクト責任者】音声AI製品の「間」の違和感を説明し、改善の優先順位を決めたい人
- 【リサーチ志向】会話研究・応答時間の研究・音声AIの実装をつなげて読みたい人
この本で解決できる悩み
- 音声AIを実装したが「会話のキャッチボール感」が出ない
- 遅いのは分かるが、どの段が何msかかっているか分からない
- Pipecat・LiveKit・Deepgram、それぞれ何を担当するのか整理できていない
- TTSを速くしても、体感があまり変わらない
- AIがユーザーの話に割り込んだり、逆に返事が遅れたりする
- ユーザーから「会話が機械的」と言われるが、改善の手がかりがない
この本の立ち位置
- 実装寄り (Pipecat / LiveKit / Deepgram などの具体スタック)
- 音声特化 (テキストのチャットボットではなく、話して答える音声AI)
- 中級者向け (STT / LLM / TTS の基本を知っている前提)
- 横断型 (会話研究・心理学・UX・実装・エッジAIを1冊で)
なぜこの本か
- 300ms・500ms・800msを「本書の設計目安」として示し、研究で観測された値・ベンダーの公表値と区別して書く
- 主指標を「話し終えてから最初の音が聞こえるまで」に置き、各段の数字はその内訳として扱う
- ストリーミング設計と知覚ハックを同じ本で扱い、どちらで何ms縮むかを分けて考える
- エッジとクラウドを組み合わせた構成を、積み上げ約450-900msという試算つきで検討する
- 物語 (ユウとミサキの開発記) と解説を交互に進め、各章に図解と参考文献を付ける
他のAI本との違い
| 比較対象 | 本書の違い |
|---|---|
| 汎用のAI実装書 | 音声特化。テキストチャットとは別の、最初の音までの時間を設計の中心に置く。 |
| WebRTC / SIP の解説書 | 通信プロトコルだけでなく、STT・LLM・TTSの推論を含めた、話し終えてから最初の音までを扱う。 |
| 各ベンダーのドキュメント (Pipecat / LiveKit など) | 1社の視点ではなく、複数のスタックを役割ごとに整理し、公表値の読み方もあわせて扱う。 |
目次
- 01 前書き: 0.3秒の壁 無料公開
- 02 第1章: 人間の会話は200msで回っている 無料公開
- 2-1 世界共通の「間」
- 2-2 200msの意味
- 2-3 200msより長い間
- 2-4 音声AIへのインプリケーション
- 03 第2章: Nielsenの3閾値を音声UIに翻訳する 無料公開
- 3-1 GUIの古典を音声に適用する
- 3-2 音声UIでは閾値が「縮む」
- 3-3 もう1つの基準線、ドハティの閾値
- 04 第3章: 待ち時間の心理学 人は「遅い」をどう感じるか
- 05 第4章: 300ms、500ms、800msの3つの崖
- 06 第5章: レイテンシの解剖 遅延はどこで生まれるか
- 07 第6章: 話し終えてから最初の音が聞こえるまで
- 08 第7章: ストリーミング設計 処理を重ねて時間を縮める
- 09 第8章: 知覚ハック 待たせても気づかせない
- 10 第9章: ターンテイキング 「遮らない」と「遅れない」の両立
- 11 第10章: Alexa / Siri / Google Assistantの教訓
- 12 第11章: エッジAIで300msを実現する
- 13 第12章: 設計原則 音声AIのUXチェックリスト
- 14 あとがき: 0.3秒が変える未来 無料公開
人と話していて、相手の返事が一瞬遅れると「あれ?」と思います。AIと話していても同じで、画面のないやり取りでは、その間がそのまま体験になります。
人の会話では、相手が話し終えてから200ms前後で次の人が話し始めます。本書はそこから、300ms・500ms・800msを設計の目安に置き、「話し終えてから最初の音が聞こえるまで」を縮める方法を、ストリーミング設計・知覚ハック・ターン検出・エッジAIの順に解説します。数字は、研究で観測された値・ベンダーの公表値・本書の設計目安を分けて書いています。
第2版(2026年9月)では、全章の出典を見直して参考文献にURLを付け、図解と場面イラストを加えました。
シリーズ・関連書籍
課題から探す
本書が扱う領域と隣り合う課題を、記事と本の地図から辿れます。無料の記事だけで解決するなら、そこで終わって構いません。