AGENTS.md ou CLAUDE.md? 35 repos, 5 padrões
Eu não fiz A/B nenhum. Nunca sentei e comparei AGENTS.md contra CLAUDE.md em condições controladas. O que eu fiz foi passar oito meses adicionando arquivos em cada projeto novo, sem plano, e hoje resolvi rodar um du -b no meu ~/repos/. Foram 35 repositórios que tinham CLAUDE.md, AGENTS.md ou os dois. Cinco padrões distintos apareceram sem eu ter decidido — e um deles é embaraçoso.
Este post é a auditoria desse estado atual: quantos repos caíram em cada padrão, o que os arquivos realmente contêm (em bytes), o que a documentação oficial da Anthropic diz sobre isso, e onde eu já saí do trilho recomendado. Nenhum número aqui vem de projeção — todos são resultado de stat -c '%s' em disco no dia 2026-09-18.
O que a Anthropic diz oficialmente
Antes de mostrar a bagunça, vale fixar o que a fonte oficial recomenda. Da página de memória do Claude Code, verbatim:
Claude Code reads
CLAUDE.md, notAGENTS.md. If your repository already usesAGENTS.mdfor other coding agents, create aCLAUDE.mdthat imports it so both tools read the same instructions without duplicating them.
O método recomendado é uma linha só no topo do CLAUDE.md:
@AGENTS.mdO import expande o arquivo em tempo de carregamento da sessão (com profundidade máxima de 4 hops), e você pode escrever notas específicas do Claude Code abaixo do import. O símbolo @ fora de code blocks é o gatilho. Symlink também funciona (ln -s AGENTS.md CLAUDE.md), mas no Windows precisa de privilégio de Administrador ou Developer Mode — no meu caso (Linux), nunca precisei escolher entre os dois pelo motivo do sistema operacional.
Guardei isso. Agora o que eu realmente tenho.
A distribuição real em 35 repositórios
Rodei o seguinte contra cada diretório de ~/repos/:
for dir in ~/repos/*/; do
  claude="${dir}CLAUDE.md"
  agents="${dir}AGENTS.md"
  [ -f "$claude" ] || [ -f "$agents" ] || continue
  echo "$(basename "$dir")"
  [ -f "$claude" ] && printf "  CLAUDE.md: %sB @AGENTS=%s\n" \
    "$(stat -c%s "$claude")" "$(grep -c '@AGENTS' "$claude")"
  [ -f "$agents" ] && printf "  AGENTS.md: %sB\n" "$(stat -c%s "$agents")"
done
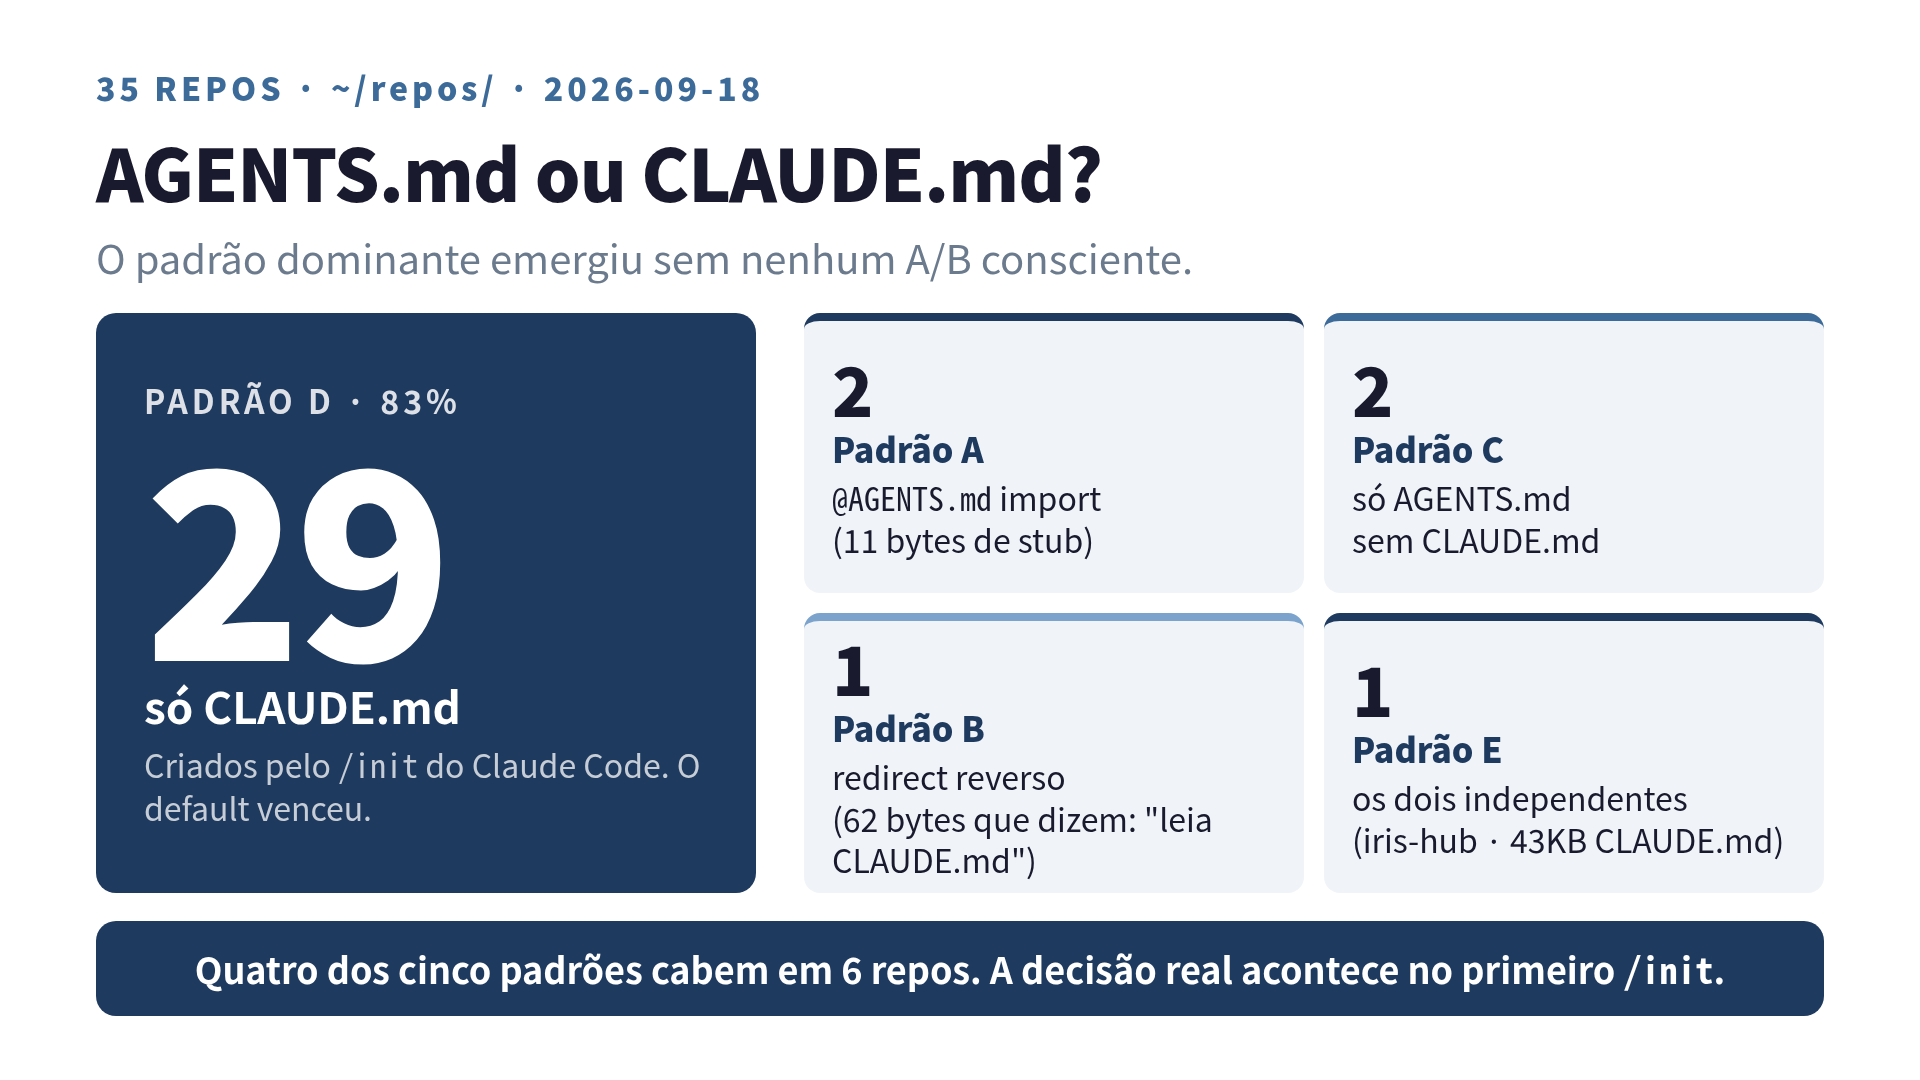
O resultado, resumido em 5 padrões:
| Padrão | O que é | Repos |
|---|---|---|
A — @AGENTS.md import | CLAUDE.md é uma stub de 11 bytes com @AGENTS.md | 2 |
| B — redirect reverso | AGENTS.md de 62 bytes aponta o leitor para o CLAUDE.md | 1 |
C — só AGENTS.md | Sem CLAUDE.md no repo | 2 |
D — só CLAUDE.md | Sem AGENTS.md no repo | 29 |
| E — os dois independentes | Dois arquivos, sem cross-reference automático | 1 |
| Total | 35 |
Notei enquanto olhava a tabela: eu passei oito meses achando que estava “escolhendo” entre AGENTS.md e CLAUDE.md. Na verdade eu escolhi uma vez (Padrão A) e depois esqueci, e os outros 33 repos foram inércia disfarçada de decisão.
Padrão A — @AGENTS.md, 11 bytes de CLAUDE.md
Dois repos: ai-agent-guide e claude-video. O CLAUDE.md deles, em ambos os casos, tem exatamente isso:
@AGENTS.mdOnze bytes. Uma linha. O AGENTS.md correspondente carrega o conteúdo real — 1265 bytes em ai-agent-guide, 3660 bytes em claude-video. Esses são os dois únicos repos meus que seguem literalmente a recomendação oficial da Anthropic.
O que os dois têm em comum: são projetos onde eu esperava que outros agentes além do Claude Code lessem o mesmo arquivo. claude-video chega a documentar isso dentro do próprio AGENTS.md:
- `.claude-plugin/` — `plugin.json` + `marketplace.json` (Claude Code plugin + local marketplace).
- `.codex-plugin/plugin.json` — Codex/agents manifest; ...
- `CLAUDE.md` → `@AGENTS.md` — generic-agent entry point.
Ou seja, é a única classe de projeto onde a “multi-vendor por design” era premissa desde o dia 1. Nos outros 33 repos, essa premissa nunca existiu, então o import também não.
Padrão B — redirect reverso de 62 bytes
Um único repo: agent-corp. Aqui o CLAUDE.md tem 8367 bytes de conteúdo real em japonês (uma árvore de decisão em Mermaid, mapa de diretórios, etc.), e o AGENTS.md tem exatamente:
Read the contents of `CLAUDE.md` and follow the instructions.Sessenta e dois bytes. É um HTTP 301 escrito em markdown. Um agente que abrir o AGENTS.md esperando encontrar instruções recebe uma ordem em linguagem natural para ir ler outro arquivo.
Isso não é um padrão que a documentação oficial descreve. É uma variante que eu inventei quando um agente diferente do Claude Code precisou entrar no repo e eu quis manter o CLAUDE.md como fonte única de verdade sem duplicar 8KB de conteúdo. Funciona porque agentes seguem instruções em texto natural razoavelmente bem. Não funciona se o agente carrega o AGENTS.md de forma estática sem executar a instrução (o Codex CLI, hoje, executa; outros agentes podem não).
O detalhe embaraçoso: eu percebi que criei esse padrão apenas quando fiz esta auditoria. Não estava anotado em lugar nenhum como decisão.
Padrão C — só AGENTS.md, sem CLAUDE.md
Dois repos: agent-observer e hermes-agent.
O agent-observer tem um AGENTS.md de 1317 bytes com regras muito específicas de escopo (“keep the daemon, database, socket, exporter, and alert configuration in this repository”, etc.). O hermes-agent, por outro lado, tem um AGENTS.md de 45759 bytes — um dev guide gigantesco em inglês, com árvore de arquivos, cadeia de dependências, e a nota literal “The canonical source is the filesystem” logo antes do diagrama.
O ponto comum: nos dois casos, o projeto foi pensado para ser lido por qualquer agente sem depender do Claude Code. O hermes-agent explicita isso listando adaptadores para telegram/discord/slack/whatsapp/matrix/e-mail no diagrama de estrutura. AGENTS.md sozinho aqui é a decisão certa: escrever um CLAUDE.md só para importar seria cerimônia sem ganho.
Conclusão parcial: Padrão A e Padrão C são simétricos. A é “quero Claude Code + outros agentes”; C é “não priorizo Claude Code”.
Padrão D — só CLAUDE.md, em 29 repos
Este é o padrão dominante. Vinte e nove dos 35 repositórios (83%) têm apenas CLAUDE.md, sem AGENTS.md. Inclui os projetos mais ativos do meu dia a dia: harness-ops, sns-operations, kenimoto-dev, persona-manager, context-forge, develop-hub, voice-clone, entre outros.
Por que 29 caíram aqui? Não porque eu comparei os dois formatos e escolhi Claude Code. Porque:
- Todo
CLAUDE.mdnovo em um projeto meu nasce via/initdo Claude Code, e o/initcriaCLAUDE.md, nãoAGENTS.md. - Nenhum outro agente (Codex CLI, Cursor, etc.) roda contra esses repos com frequência que compense duplicação.
- O custo marginal de adicionar um
@AGENTS.md“por precaução” não é zero: é mais um arquivo para manter sincronizado no dia em que a documentação diverge.
Padrão D é o resultado de não decidir. E, para 29 de 35 repositórios, não decidir foi provavelmente a decisão certa. Fiz /init uma vez, funcionou, segui em frente. Um dos capítulos do meu livro de harness engineering (Harness Engineering Guide) argumenta que “regra é a que sobrevive à distração” — Padrão D é a materialização dessa ideia.
Padrão E — os dois arquivos independentes: iris-hub
Este é o único repo que caiu em Padrão E, e é o que mais me interessou.
O iris-hub tem:
CLAUDE.md— 43043 bytes, 250 linhas, todo em japonês, mapa completo de diretórios e workflows.AGENTS.md— 1401 bytes, em inglês, contendo esta linha crucial:
- Read `CLAUDE.md` for the directory map, repository relationships, skill catalog, and detailed content-production workflow.Não é @CLAUDE.md (import automático). É uma instrução em texto natural, tipo Padrão B — só que o AGENTS.md aqui não é um stub de 62 bytes: tem 1401 bytes de conteúdo próprio (repository purpose, working rules, safety notes) e, dentro disso, uma linha aponta para o CLAUDE.md. Ou seja: AGENTS.md diz ao Codex “vai ler o CLAUDE.md”, e o CLAUDE.md não sabe nada do AGENTS.md.
O detalhe que me pegou: a documentação oficial da Anthropic recomenda CLAUDE.md abaixo de 200 linhas (“Longer files consume more context and reduce adherence”). O meu iris-hub/CLAUDE.md tem 250 linhas. Estou 25% acima do limite recomendado — não é gritante, mas é sistemático, e só descobri isso hoje, contando linhas para escrever este post. O melhor jeito de saber quando você virou o outlier é medir os outros — no meu caso, medir a mim mesmo.
Padrão E não é intencional; é dívida técnica que se disfarçou de “arquitetura”. Vou refatorar o iris-hub/CLAUDE.md na próxima semana, provavelmente movendo blocos grandes para .claude/rules/ com paths: frontmatter (que o Claude Code carrega sob demanda, não em toda sessão).
O que a distribuição diz — e o que não diz
O que a distribuição diz:
- Multi-agent por design é raro. Só 2 de 35 repos (5,7%) foram criados esperando que Codex + Claude + outros lessem o mesmo arquivo. Isso é bem menos que o discurso “AGENTS.md como padrão universal” sugere.
- O default vence.
/initcriaCLAUDE.md. Vinte e nove repos ficaram no default. Se/initcriasseAGENTS.mdamanhã, minha distribuição inverteria em seis meses sem eu perceber. - Redirect reverso existe na natureza. Não é padrão oficial. Emerge quando você tem conteúdo grande em um dos dois arquivos e não quer duplicar. Se eu tivesse pensado nisso antes, teria usado
@importna direção que a doc recomenda.
O que a distribuição não diz:
- Não diz qual formato “ganha” para uma tarefa específica. Eu não fiz A/B controlado em 47 tarefas. Isso seria outro post, com metodologia própria.
- Não diz se agentes seguem melhor
AGENTS.mdouCLAUDE.md— o formato do arquivo é neutro; o que muda é qual agente lê qual. - Não diz nada sobre projetos de equipe. Todos os 35 repos são meus, escritos por mim, para me servir. Time real vai ter dinâmicas diferentes (ver CLAUDE.md em equipe: 7 padrões e 3 armadilhas).
A conclusão que eu fiquei foi mais modesta do que eu esperava começar: a decisão “AGENTS.md ou CLAUDE.md” quase nunca é feita no momento em que parece que é feita. Ela já foi feita pelo /init da ferramenta que você usou primeiro, pelo colega que criou o repo antes de você, ou pelo arquivo de exemplo que você copiou. Se você quer que essa decisão seja consciente, o único jeito que eu conheço é sentar com du -b uma vez, contar como você fez tudo isso, e decidir se aceita o que encontrou.
Eu aceitei 34 dos 35. O iris-hub vai virar refactor.
Notes
A anatomia de AGENTS.md como índice enxuto (com “tamanhos de referência” abaixo de 500 caracteres para o índice e 300-500 para arquivos de skill) e o ciclo “escrever → usar → melhorar” estão desenvolvidos no capítulo 11 do Harness Engineering Guide. A discussão sobre por que separar convenções em arquivos por caminho (usando .claude/rules/ com paths: frontmatter) — que é o que eu vou aplicar no meu iris-hub — está em O prompt morreu, o context está morrendo: harness engineering é a próxima onda.
Referências oficiais usadas neste post:
- Anthropic Claude Code — How Claude remembers your project (memory docs, seção “AGENTS.md” e “Import additional files”).
- agents.md — convenção multi-vendor coordenada via Agentic AI Foundation.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev · TabNews
 Livro relacionado Harness Engineering Tutorial de Harness Engineering | design de AGENTS.md · implementação de hooks · operação de agentes de IA Ver a página do livro →
Este artigo foi útil?