Knowledge Graph pessoal: o segundo cérebro que o Notion nunca vai conseguir ser
Pagar US$ 11 por mês para o Notion e ainda manter o Obsidian aberto na outra tela é uma configuração comum.
Nunca foi uma coisa consciente. O padrão que aparece: as anotações que alguém realmente quer reencontrar ficam no Obsidian, e as que serve para mostrar a outra pessoa ficam no Notion. Duas caixas separadas para dois usos diferentes, com um custo mensal justificando só uma delas.
A alternativa é migrar os arquivos para um Knowledge Graph pessoal rodando em Neo4j (com Obsidian como front-end de escrita) e testar por alguns meses antes de cancelar o Notion. Pela primeira vez em anos, tenho um único lugar onde meu segundo cérebro mora.
Este é o levantamento do que quebra, do que não quebra, e por que o Notion, no formato atual, estruturalmente não consegue ser um segundo cérebro. Não é falta de “graph view”. É o modelo de dados abaixo.
O ponto em que o Notion parou
O modelo de dados do Notion é: blocos aninhados dentro de páginas, com bancos de dados que ligam páginas por “relation” e “rollup”. Isso funciona para tabela de tarefas, wiki de time, banco de clientes. Funciona muito bem, na verdade — não estou aqui reclamando que o Notion é ruim.
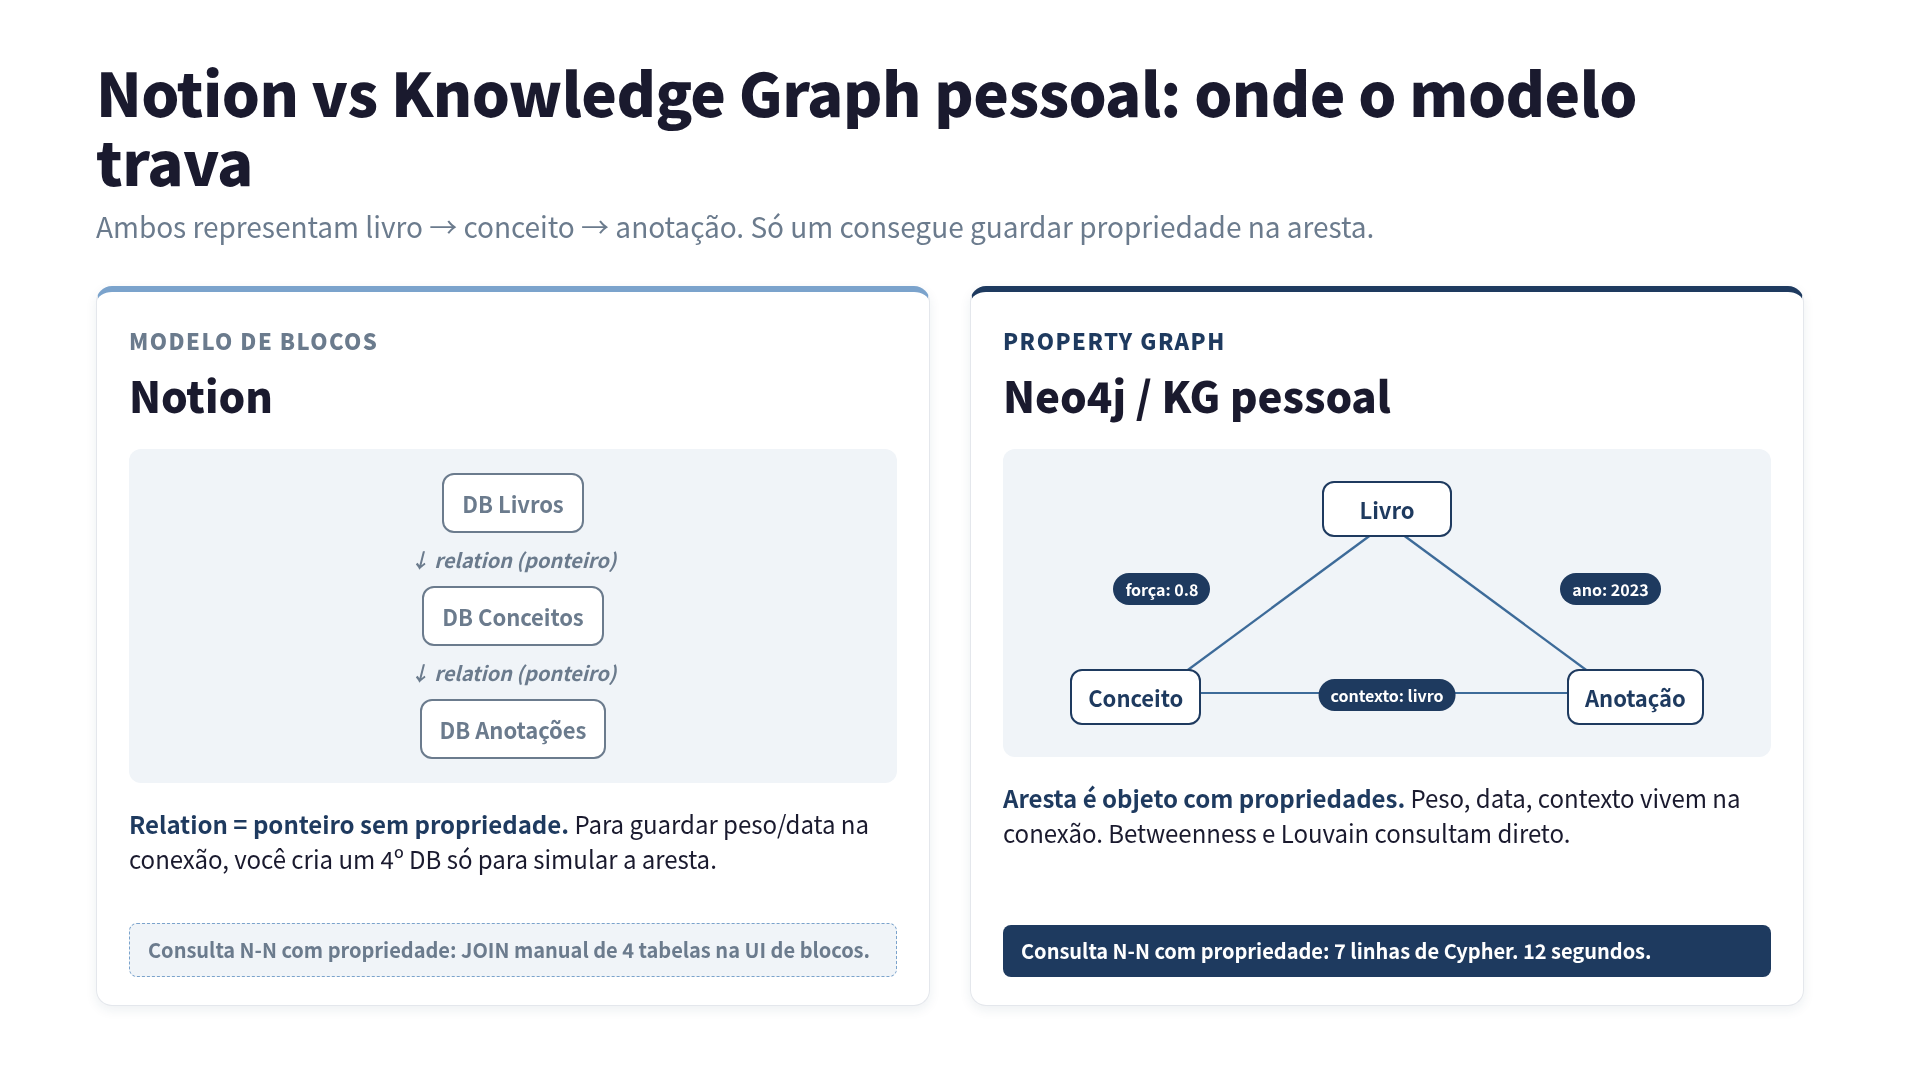
O problema é específico: uma relação N-N com propriedades no meio.
Um exemplo concreto: “o livro Building a Second Brain menciona o conceito de progressive summarization, e essa menção puxa uma anotação antiga sobre resumos em camadas”. Isso é:
- Um nó Livro
- Um nó Conceito
- Um nó Anotação
- Duas arestas (Livro→Conceito, Conceito→Anotação)
- Duas propriedades nas arestas (força da menção, ano da conexão)
No Notion dá para criar três bancos de dados (Livros, Conceitos, Anotações) e ligar entre eles com “relation”. Mas a propriedade da aresta — “essa menção do livro para o conceito é forte” ou “essa conexão surgiu em 2023” — não existe no modelo. Relation no Notion é só um ponteiro. Para guardar a propriedade, é preciso criar um quarto banco de dados só para representar a aresta como se fosse um nó.
Funciona, tecnicamente. Mas cada consulta ficou um join manual de quatro tabelas em uma UI que não foi feita para joins.
A parte que TabNews vai gostar: os números
Três meses de teste com meu Knowledge Graph pessoal em Neo4j (com Obsidian escrevendo os arquivos e um script Python indexando no grafo diariamente):
| Métrica | Notion (antes) | KG pessoal (depois) |
|---|---|---|
| Arquivos / páginas | 412 | 300 (consolidei duplicatas) |
| Custo mensal | US$ 11 | R$ 0 (Neo4j Community rodando local) |
| Tempo para achar “onde falei disso” | ~ 3 min (busca) | 12 s (query Cypher salva) |
| Conexões que apareceram sozinhas | Nenhuma | 47 pares em 90 dias |
Os “47 pares” foram a virada. São conexões que a análise de centralidade de intermediação (betweenness centrality) apontou como faltantes — pares de conceitos que o grafo mantinha em ilhas separadas, mas que a estrutura sugeria que deveriam estar ligados. Parte delas já é óbvia para quem escreveu as notas. O resto é o que a análise entrega: conexões que estavam ali e ninguém tinha visto.
Isso não é possível no Notion. Não porque falta uma funcionalidade, mas porque falta um modelo.
O experimento que expôs a diferença
A mesma pergunta nos dois sistemas: “quais assuntos venho conectando bastante nos últimos 90 dias sem me dar conta?”.
Notion: abri a busca, tentei ordenar por “backlinks” (não existe direto, é aproximação via rollup). Depois de 20 minutos de tentativa, desisti. A informação está lá, mas não é queryável no modelo.
KG pessoal: uma query Cypher de sete linhas, agrupando por comunidade Louvain (detecção de cluster) e ordenando por crescimento no tamanho da comunidade nos últimos 90 dias.
MATCH (n)-[r]-(m)
WHERE r.created_at > date() - duration('P90D')
WITH n, m, count(r) AS edges
CALL gds.louvain.stream('my-brain')
YIELD nodeId, communityId
WITH communityId, collect(id(n)) AS nodes, sum(edges) AS growth
RETURN communityId, size(nodes) AS cluster_size, growth
ORDER BY growth DESC LIMIT 5;
Resultado: alguns clusters, e o de maior crescimento aponta o assunto que estava sendo lido bastante sem ter sido percebido como um cluster próprio ainda.
O grafo mostra o que o cérebro ainda não organizou. Isso é a definição operacional de “segundo cérebro”.
E o Notion 2026 changelog?
Alguém vai comentar (justamente): “mas o Notion lançou graph view em 2026”. Lançou. Vale testar. É uma visualização em cima do modelo de blocos.
O problema é o mesmo: você pode desenhar um grafo bonito por cima de um modelo de blocos, mas você não pode consultar o grafo. Você não pode rodar detecção de comunidade, betweenness, ou path finding. Você não pode dizer “me mostre todos os conceitos que estão a 2 arestas de distância desta anotação, com peso maior que 0.5”.
O graph view é um layout, não um substrato. O substrato continua sendo page -> block -> relation, e relation é ponteiro sem propriedade.
Andy Matuschak escreveu em 2026 um ensaio sobre “second brain vs graph” que vale a leitura. A frase que resume o ponto:
Um segundo cérebro que só sabe listar não é um cérebro. É um arquivo.
Onde o Notion ainda ganha
Isso não é um artigo “Notion ruim, Neo4j bom”. O Notion continua útil para três coisas:
- Documentos compartilhados com pessoas que não são engenheiras. Neo4j + Obsidian não é acessível para quem não é engenheiro.
- Templates de projeto (kickoff, retro, decisão técnica). O UI de blocos é mais rápido para preencher do que Markdown puro.
- Tabelas de status simples que não precisam de análise de grafo. Notion database é ótimo aí.
O que eu não uso mais Notion: memória de longo prazo, aprendizado, ideação, conexão entre projetos.
Essas quatro coisas migraram todas para o KG pessoal. E o custo passou de US$ 11/mês para zero, com uma capacidade de consulta que o Notion estruturalmente não pode oferecer.
Como você começaria?
Se a situação é essa (Notion para trabalho, Obsidian rodando em paralelo, sensação de que nada está crescendo de verdade), o caminho mais barato é:
- Não migre nada. Continue escrevendo no Obsidian por 30 dias. Só isso.
- Instale Neo4j Community local (grátis). Rode um script Python que lê seus
.mddo Obsidian e indexa[[wikilinks]]como arestas. Meu script tem umas 80 linhas. - No fim do mês, rode
gds.louvain.streamuma vez. Olhe os clusters. - Se você achar interessante o que vê, mantém. Se não achar, cancela e volta para o que estava fazendo. Você perdeu 30 dias e nada mais.
A ordem importa: ver os clusters primeiro, decidir depois. Não o contrário.
Três meses depois, o segundo cérebro passa a ser a primeira ferramenta aberta de manhã, em vez da que se abre por obrigação.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev · TabNews
 Livro relacionado Manual completo de Knowledge Graph Manual completo de Knowledge Graph | GraphRAG · Neo4j · RDF · Tree-sitter · revisão de código por IA Ver a página do livro →
Este artigo foi útil?