CLAUDE.md: el autor escribe 2 líneas, tú 100
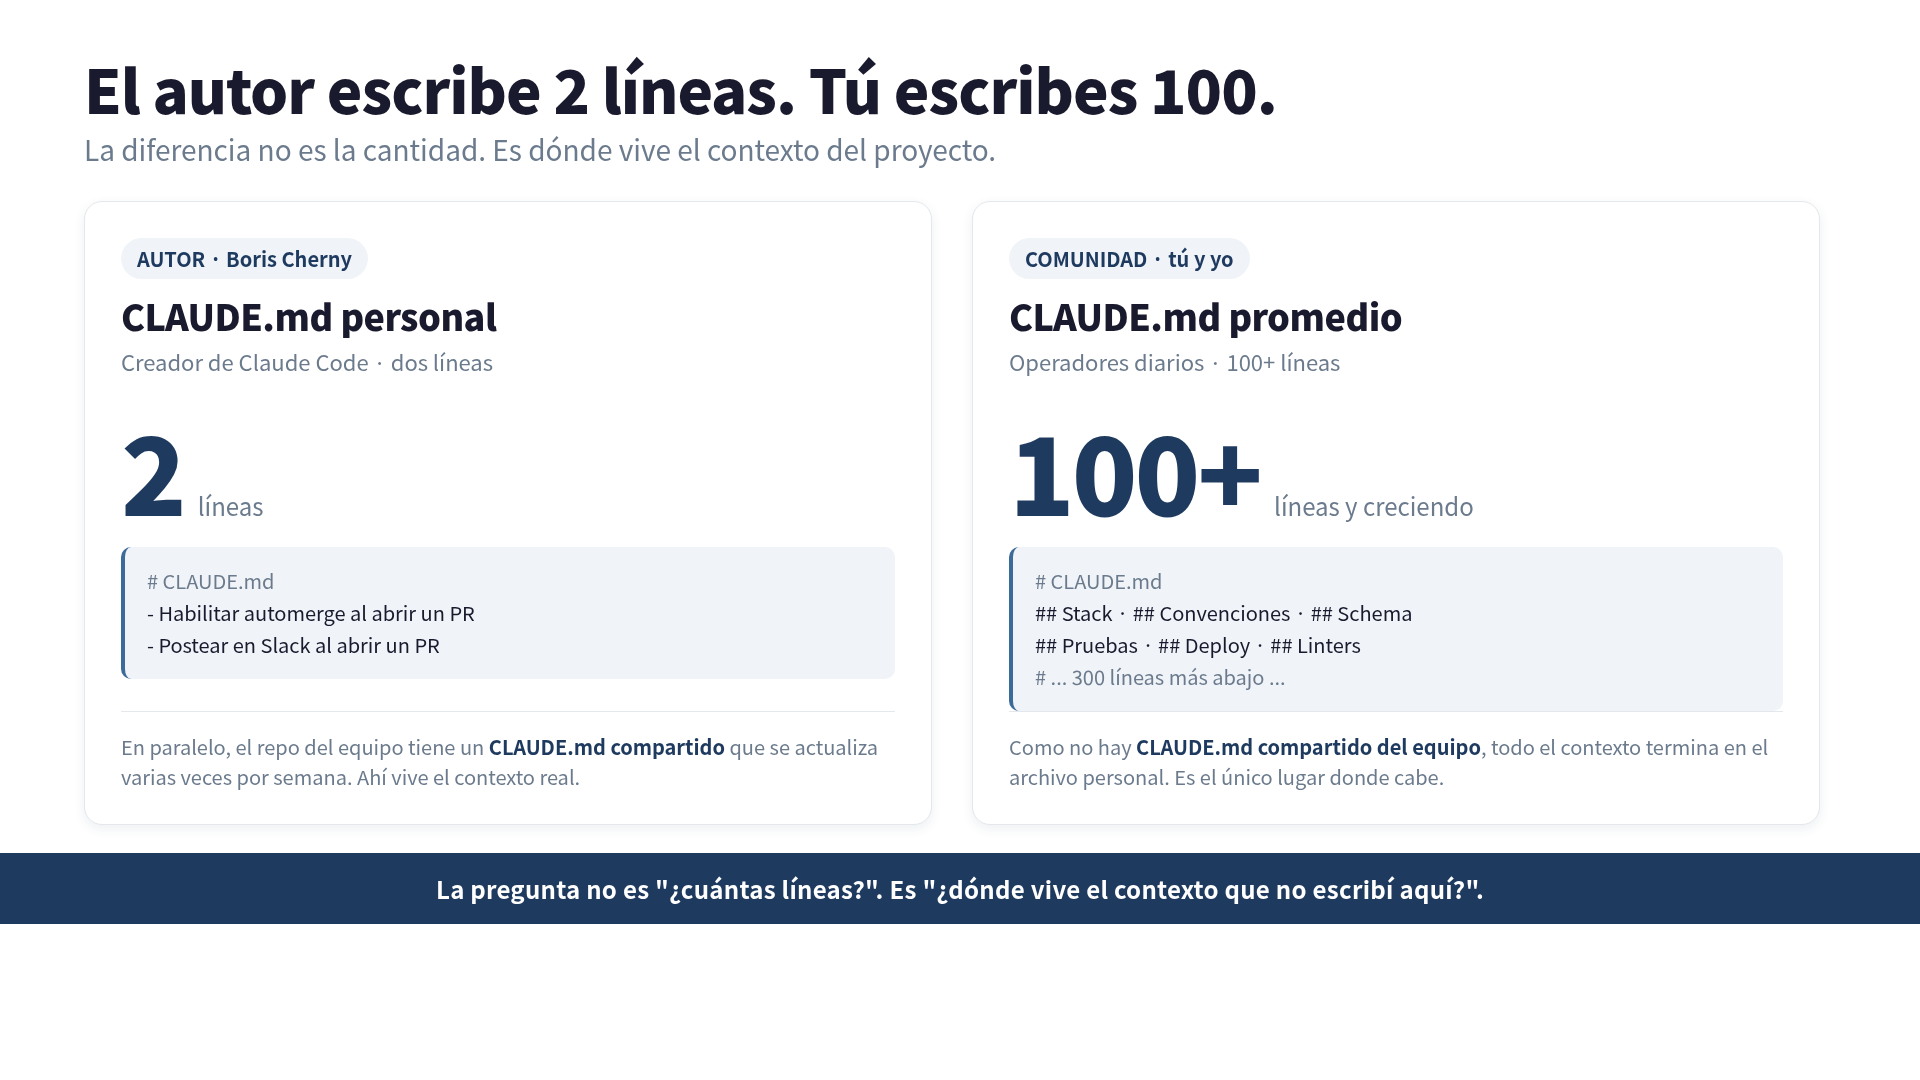
Boris Cherny, el creador de Claude Code, tiene un CLAUDE.md personal que ocupa dos líneas. Dos. Sin convenciones de código, sin descripción de arquitectura, sin estrategia de pruebas:
# CLAUDE.md
- Habilitar automerge al abrir un PR
- Postear en el canal interno de Slack al abrir un PR
Mientras tanto, los que usamos Claude Code a diario escribimos archivos de 100, 300 o incluso 500 líneas. Toda la stack, todas las convenciones, el schema del DB, la estrategia de pruebas, el procedimiento de deploy. Un documento gigante lleno de todo lo imaginable.
¿Quién tiene razón?
Por qué Boris puede vivir con dos líneas
La respuesta aparece cuando uno lee el repositorio del propio Claude Code. Al lado del CLAUDE.md personal de dos líneas, hay otro CLAUDE.md compartido por el equipo en la raíz del repo, que se actualiza varias veces por semana. El archivo personal de Boris queda corto porque el compartido ya cubre el contexto del equipo.
En otras palabras, el consejo “el CLAUDE.md debe ser corto” se malinterpreta con facilidad. Más preciso: tu CLAUDE.md personal puede ser corto, pero el contexto del proyecto tiene que vivir en algún lugar. Si trabajas sola o solo en un repositorio, ese “algún lugar” eres tú.
El problema del CLAUDE.md inflado
El CLAUDE.md es la única pieza de contexto que sobrevive al /clear. Es la memoria de largo plazo del proyecto. Y como toda memoria de largo plazo que crece sin curaduría, se infla hasta volverse estorbo.
Un CLAUDE.md inflado tiene tres problemas concretos:
- El modelo empieza a ignorar instrucciones. Los LLMs pesan más el inicio y el final de la entrada. Las reglas enterradas en medio de un CLAUDE.md gigante tienen más probabilidad de pasar desapercibidas.
- Las instrucciones viejas chocan con las nuevas. Una línea dice “usa Jest para pruebas” y, cincuenta commits después, otra dice “las pruebas se migraron a Vitest”. El modelo recibe las dos y adivina.
- La ventana de contexto se consume antes de empezar. Un CLAUDE.md de 1000 líneas se carga entero al abrir la sesión. Esa fracción de contexto ya no está disponible para la tarea real.
El consejo de Boris sobre esto es brutalmente simple:
Si el CLAUDE.md se hace muy largo, bórralo y comienza de nuevo. Si el modelo se desvía, lo vas empujando de vuelta de a poco. A medida que los modelos mejoran, hay que agregar menos.
Siete principios para no inflarlo
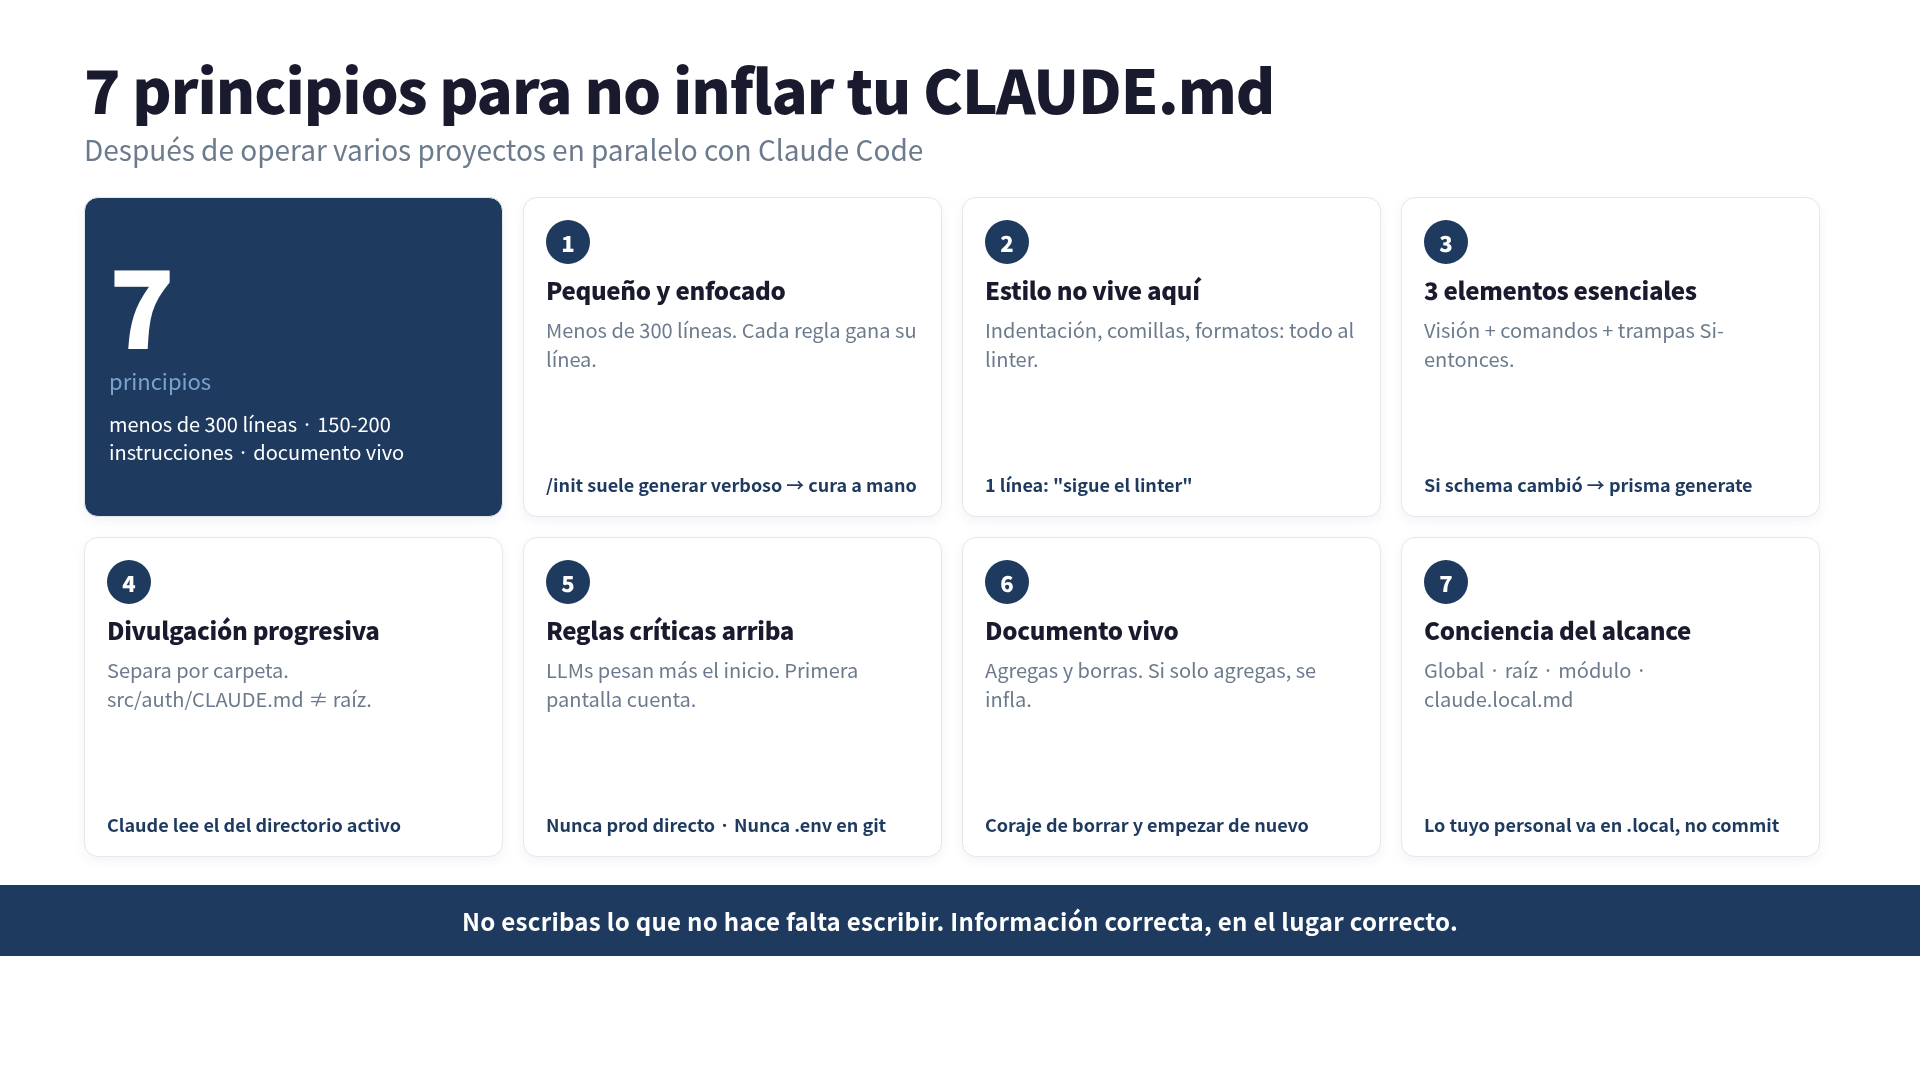
Después de operar harness-ops por meses con varios CLAUDE.md en paralelo, me quedaron siete principios que repito cada vez que un archivo cruza las 200 líneas.
1. Pequeño y enfocado
Menos de 300 líneas, 150 a 200 instrucciones máximo. El /init automático genera algo verboso; cúralo a mano después.
2. El estilo de código no vive aquí
Dos espacios de indentación, comillas simples, punto y coma: todo eso se delega a .prettierrc y .eslintrc. Una sola línea en el CLAUDE.md: “sigue las reglas del linter/formatter”. Si quieres que el modelo haga prettier, esa responsabilidad vive en el linter y el CLAUDE.md no tiene por qué duplicarla.
3. Tres elementos esenciales
Como mínimo, el CLAUDE.md necesita tres bloques:
- Visión general del proyecto en una o dos líneas (stack + propósito).
- Comandos comunes (
npm run dev,npm test, migraciones, deploy). - Trampas específicas del proyecto escritas en formato Si X, entonces Y:
- Si el schema de Prisma cambió → entonces corre
npx prisma generate. - Si se agregó una variable de entorno → entonces actualiza
.env.example.
- Si el schema de Prisma cambió → entonces corre
Las trampas son el elemento que vale oro. Son el conocimiento tácito del proyecto que ningún linter captura.
4. Divulgación progresiva
No cargues todo. Separa en archivos específicos por carpeta y referéncialos desde el CLAUDE.md raíz:
Ver docs/api-spec.md para la especificación detallada de la API.
Ver docs/testing-strategy.md para la estrategia de pruebas.
Claude Code carga automáticamente el CLAUDE.md del directorio en que está trabajando. Al tocar src/auth/, lee src/auth/CLAUDE.md. Al tocar src/payment/, lee src/payment/CLAUDE.md. Información correcta en el momento correcto.
5. Las reglas críticas van arriba
Los LLMs pesan más el inicio y el final. Las dos o tres reglas que no puedes darte el lujo de que el modelo olvide, van en la primera pantalla del archivo:
# CLAUDE.md

- Nunca conectar al DB de producción directamente. Usar siempre staging.
- Nunca commitear archivos .env.
6. Documento vivo, no fósil
El CLAUDE.md no se escribe una vez y se olvida. Cuando el modelo repite el mismo error, agregas una línea. Cuando el proyecto cambia, actualizas. Pero si solo agregas, se infla. Revísalo cada tanto y borra las reglas que ya no aplican. Boris dice “ten el coraje de borrar y empezar de nuevo”. Es un buen consejo, incómodo.
7. Conciencia del alcance
La ubicación del archivo define quién lo lee:
~/.claude/CLAUDE.md          # Global (todos los proyectos)
~/project/CLAUDE.md           # Raíz del proyecto (equipo)
~/project/src/auth/CLAUDE.md  # Específico del módulo
~/project/claude.local.md     # Tus preferencias personales (en .gitignore)
Las reglas del equipo van en el raíz. Lo tuyo personal va en claude.local.md. Esta separación evita el conflicto incómodo de “quiero esta regla, pero no es para el equipo”.
La pregunta real: qué cuenta como contexto
El diseño del CLAUDE.md termina de hacer sentido cuando uno acepta la pregunta que lo motiva: ¿qué cuenta como contexto?
Contexto es la información que el modelo necesita para tomar decisiones correctas. Y lo que necesita depende del momento:
- Para captar el panorama → la descripción de la arquitectura.
- Para arreglar un bug específico → las trampas de ese módulo.
- Para escribir pruebas → la estrategia de pruebas y la configuración del test runner.
- Para hacer deploy → el procedimiento de deploy y las variables de entorno.
Darle toda la información de una vez satura la ventana de contexto y entierra lo que importa. Darle solo lo necesario, cuando es necesario: esa es la ingeniería de contexto. El CLAUDE.md es el primer artefacto para practicarla.
Volviendo a Boris
El CLAUDE.md de dos líneas de Boris es un caso extremo, pero la dirección está bien. No escribas lo que no hace falta escribir. Pon la información necesaria en el lugar correcto, con la granularidad correcta. Esa es la esencia.
Si tu CLAUDE.md ya pasó las 300 líneas, no es por descuido. Es porque falta la curaduría. Es más fácil agregar una línea que borrar diez.
Lecturas relacionadas
Si quieres el enfoque complementario —no “qué dejar fuera del CLAUDE.md”, sino “qué 7 archivos poner al lado del CLAUDE.md para contexto completo”— lo cubrí en 7 archivos de Claude Code: checklist de context engineering en 5 minutos.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev
 Libro relacionado Practical Claude Code Claude Code desde cero hasta producción — CLAUDE.md, Plan Mode y workflows de equipo, desde un año de uso real Ver la página del libro →
¿Te resultó útil este artículo?