Postmortem blameless: 3 señales de teatro
El equipo hace postmortem blameless. Lo dice en la plantilla, lo dice el líder al abrir la reunión, lo dice el documento final. Nadie es culpado. La pipeline falló, el sistema no estaba preparado, el proceso tiene espacios de mejora. Todos asienten, nadie se incomoda, se escribe el documento, se cierra el incidente.
Dos semanas después, otro equipo reporta exactamente el mismo problema.
Esta es la señal más clara de que el postmortem blameless se convirtió en teatro. Hay otras dos. Juntas forman el patrón que Amy Edmondson describió en 1999 cuando distinguió la seguridad psicológica real de su versión decorativa: ambientes donde parece seguro hablar, pero donde en realidad nada que incomode llega a la mesa.
Este post trata las 3 señales de que tu postmortem blameless perdió el blameless y se quedó con el documento.
Qué dice la teoría, en un párrafo
Amy Edmondson publicó en 1999 el estudio Psychological Safety and Learning Behavior in Work Teams en Administrative Science Quarterly. La seguridad psicológica, en su definición, es la creencia compartida de que el equipo es seguro para tomar riesgos interpersonales: preguntar lo que no sabes, reportar errores, discrepar con el líder, pedir ayuda. En 2015 Google publicó los resultados de Project Aristotle, el análisis de 180 equipos (115 de ingeniería y 65 de ventas), y encontró que la seguridad psicológica era el factor más común entre los equipos de alto desempeño, por encima del talento individual y de la remuneración.
El postmortem blameless (sin culpar) es la práctica que materializa eso en el día a día de un equipo de SRE: cuando ocurre un incidente, el enfoque está en qué pasó y cómo evitarlo, no en de quién es la culpa. La idea viene del trabajo de John Allspaw en Etsy alrededor de 2012 y fue formalizada en el libro Site Reliability Engineering de Google.
La teoría es sólida. Lo que falla es la implementación. “Blameless” se vuelve una etiqueta que, mal usada, impide ver.
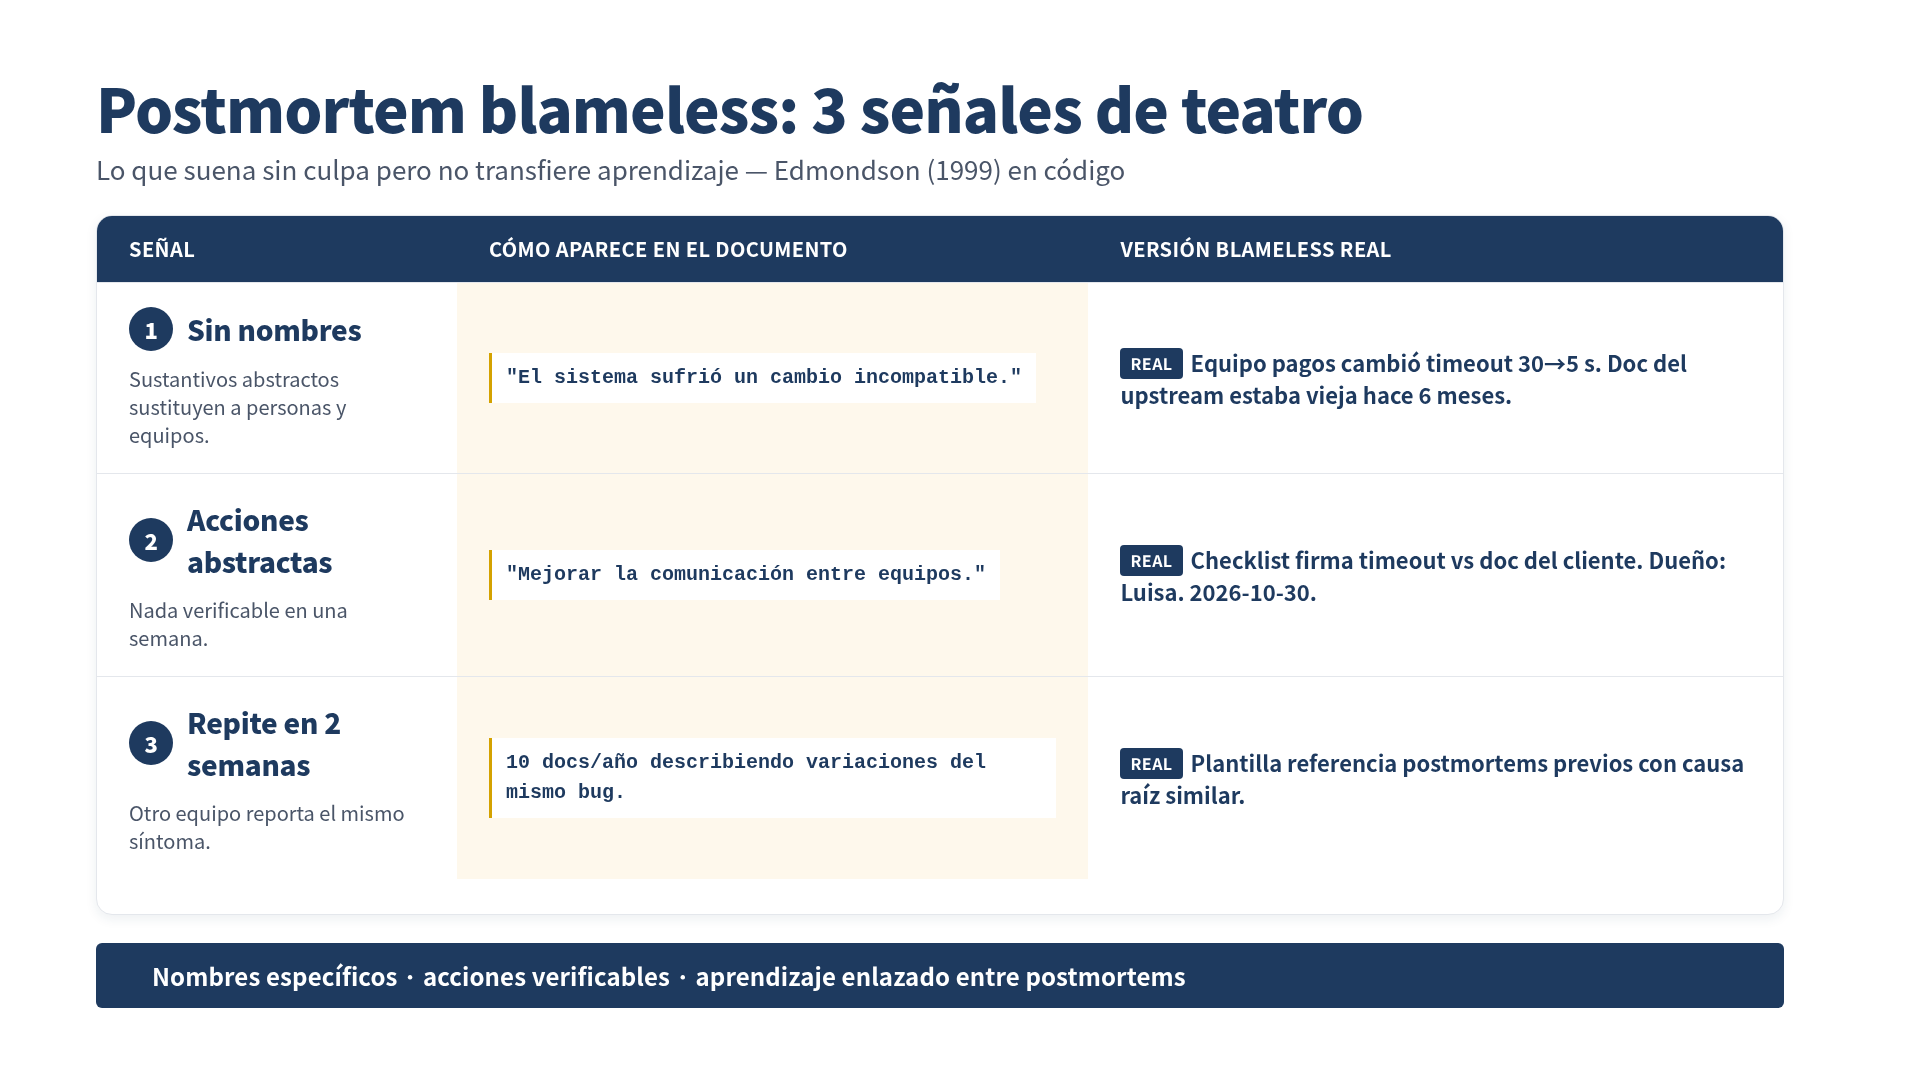
Señal 1: no hay nombres propios, solo sustantivos abstractos
Lee tu último postmortem. Cuenta cuántas veces aparece la palabra “pipeline”, “sistema”, “proceso”, “infraestructura”. Ahora cuenta cuántas veces aparece el nombre de una persona, un equipo específico, un servicio concreto con su owner. Si la primera cifra es alta y la segunda es cero, estás viendo la primera señal.
Blameless no significa “sin sujeto”. Significa que, cuando identificamos quién tomó la decisión, no la tratamos como culpa individual, la tratamos como información para entender el contexto. Un postmortem blameless real dice: “El equipo de pagos cambió el timeout de 30 a 5 segundos el martes. En ese momento, la documentación del cliente upstream decía que admitía timeouts bajos. Resulta que la documentación estaba desactualizada hace seis meses.”
Esa frase tiene equipo, decisión, momento, razón y causa. Nombra a todos y no culpa a nadie.
Un postmortem teatro dice: “El sistema de pagos sufrió un cambio de configuración que resultó incompatible con dependencias upstream.” Misma información, nombres borrados. El resultado es que nadie sabe con quién hablar, nadie entiende por qué se tomó la decisión, y la próxima persona que piense en cambiar un timeout va a tomar la misma decisión sin más contexto que la anterior.
El reflejo de borrar nombres suele venir de buena intención: “no queremos que se sienta mal”. Pero el efecto real es anónimo = inauditable. Y lo inauditable se repite.
Señal 2: todas las acciones correctivas son “mejorar la comunicación”
Esta es la señal más fácil de pescar porque tiene un vocabulario propio.
- “Mejorar la comunicación entre equipos.”
- “Revisar el proceso de aprobación de cambios.”
- “Alinear expectativas sobre timeouts.”
- “Fortalecer la cultura de observabilidad.”
Cada una de esas frases cumple la plantilla del postmortem (acción correctiva, dueño, fecha) sin comprometer a nada específico. ¿Qué es “mejorar la comunicación”? ¿Quién la mejora? ¿Cómo sabes el martes de la próxima semana si está mejorada?
Compara con lo que sería una acción concreta de la misma causa: “Agregar al checklist de cambios de configuración de prod un paso que requiere firmar que el timeout fue verificado contra la documentación del cliente upstream, con hash del commit de documentación. Dueño: Luisa. Fecha: 2026-10-30. Verificable viendo el checklist de los próximos 3 cambios.”
La diferencia no es cosmética. La primera versión te permite cerrar el postmortem sin que nada cambie. La segunda versión te obliga a decidir si lo que propones es realmente lo que vas a hacer. Las acciones abstractas sobreviven porque nadie las puede probar como no cumplidas. Esa es exactamente la razón por la que no deberías aceptarlas.
Esto no es puro problema de redacción. Las acciones abstractas aparecen cuando el equipo no quiere comprometerse a algo que suene como “arreglar lo que esa persona hizo mal”. El miedo a culpar termina produciendo acciones que no corrigen nada. Es un segundo orden de la seguridad psicológica mal entendida.
Señal 3: el mismo incidente aparece en otro equipo en 2 semanas
Esta es la señal técnica, y es la más difícil de ocultar. Si tu postmortem blameless funciona, el aprendizaje se propaga. Otros equipos leen el documento, revisan sus propias configuraciones, aplican la lección antes de pisar el mismo cable. El tiempo entre incidentes del mismo tipo crece.
Si no funciona, el aprendizaje se queda dentro del equipo que vivió el incidente. Dos semanas después, otro equipo reporta el mismo síntoma con un stack ligeramente diferente, y vuelves a hacer postmortem. Un año así y tienes diez documentos que describen variaciones del mismo problema.
La métrica directa es: para los últimos N postmortems, ¿cuántas veces el mismo patrón de causa raíz se repite en 30 días en otro equipo? Si la respuesta es “varias”, el postmortem no está transfiriendo conocimiento. Está transfiriendo papeles.
Esta señal también tiene una variante más sutil. A veces el incidente no se repite exactamente, pero sí aparece la misma clase de error, con otros nombres. “Timeout” se vuelve “retry budget”, “pipeline” se vuelve “orquestador”, pero la causa raíz es la misma: alguien configuró un parámetro operacional sin verificar la asunción de su cliente. Si tus postmortems no te permiten agrupar por “clase de error”, tampoco estás aprendiendo entre ellos.
Qué hace un postmortem blameless real
Las tres señales anteriores son el negativo. El positivo tiene cuatro propiedades que la literatura de SRE describe de manera recurrente (Google, Site Reliability Workbook, capítulo sobre Postmortem Culture; Allspaw 2012):
- Nombres específicos sin culpa. La persona o equipo que tomó la decisión aparece con nombre, junto con el contexto que explica por qué la decisión fue razonable en ese momento. El objetivo es que el lector entienda, no que juzgue.
- Acciones correctivas verificables en una semana. Cada acción tiene un criterio de verificación que un externo puede chequear. “Dueño Luisa, fecha 2026-10-30, verificable viendo X.” Si no puedes decir cómo lo vas a verificar, la acción es ambigua.
- Un diff concreto. Lo que cambió en el código, el config, la documentación o el checklist, como commit o PR. No “actualizar documentación” sino “PR #4821 mergeado”. La ambigüedad es donde se esconde el teatro.
- Enlazado con postmortems anteriores. La plantilla incluye una pregunta explícita: “¿Hay postmortems anteriores con causa raíz similar?” Si la respuesta es sí, el documento referencia los enlaces. Esto fuerza a que la clase de error sea visible entre incidentes.
Estas cuatro propiedades no requieren un software nuevo. Requieren que el líder, cuando revise el borrador, pregunte “¿quién, exactamente?” y “¿cómo lo verificamos?” en cada punto que esté vago. Esa pregunta es la práctica diaria de la seguridad psicológica que Edmondson describe: pedir claridad no es acusar, es parte del trabajo.
El error común: confundir “sin culpa” con “sin sujeto”
Es tentador leer la literatura de seguridad psicológica como “ser suave”. La propia Edmondson insiste en que no lo es. Seguridad psicológica y estándares exigentes coexisten; es más, su investigación muestra que los equipos de más alto desempeño combinan ambos. Lo que se elimina es el riesgo interpersonal de hablar, no la exigencia técnica.
Un postmortem puede nombrar a la persona que cambió el timeout, pedirle que explique el contexto, revisar la documentación que leyó, y proponer una acción concreta para la próxima vez. Nada de eso es culpar. Todo eso es blameless. Lo que no es blameless es evitar nombres para “no incomodar”, porque la incomodidad real llega dos semanas después, cuando otro equipo pisa el mismo cable y nadie sabe con quién hablar sobre el anterior.
El postmortem no está roto por decir “blameless”. Está roto cuando “blameless” se convierte en la etiqueta que te permite no mirar.
Si estás revisando postmortems esta semana, prueba lo siguiente: toma los últimos cinco documentos, cuenta nombres propios, cuenta verbos específicos en las acciones correctivas, y busca si alguno de los incidentes se repitió en otro equipo dentro del mes siguiente. Las tres señales de teatro aparecen rápido. Lo bueno es que corregirlas también.
Fuentes primarias:
- Edmondson, A. (1999). Psychological Safety and Learning Behavior in Work Teams. Administrative Science Quarterly, 44(2), 350–383.
- Google re:Work (2015). “The five keys to a successful Google team.” Project Aristotle.
- Allspaw, J. (2012). “Blameless PostMortems and a Just Culture.” Code as Craft, Etsy Engineering Blog.
Lecturas relacionadas en el blog:
- 3 sesgos de estimación cuando IA dice 10 minutos
- Sesgo de automatización: confías en Claude más que en un colega senior
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev
¿Te resultó útil este artículo?