nanochat CORE: 22 Tests en 1 Número (0.256525)
El coste de entrenar un modelo tipo GPT-2 con nanochat y las 8.000 líneas de código de Karpathy los desmenucé en /es/blog/nanochat-entrenar-gpt-2-costaba-43000-2019-cuanto-cuesta-hoy/. Aquí me meto con la otra cara del asunto: cómo se decide que un modelo “alcanzó” a GPT-2. La respuesta cabe en un número, 0.256525.
Ese número es el CORE Score de GPT-2 (1.6B), el listón que la leaderboard oficial de nanochat obliga a superar en cada ejecución nueva. A mí me chirriaba como cifra arbitraria hasta que me senté a mirar qué demonios mide.
22 tareas colapsadas en una decimal
CORE viene del paper DCLM (arxiv 2406.11794) y es el promedio de las precisiones en 22 tareas de evaluación distintas, agrupadas en 5 categorías: comprensión de lenguaje, conocimiento del mundo, razonamiento de sentido común, resolución simbólica de problemas y comprensión lectora.
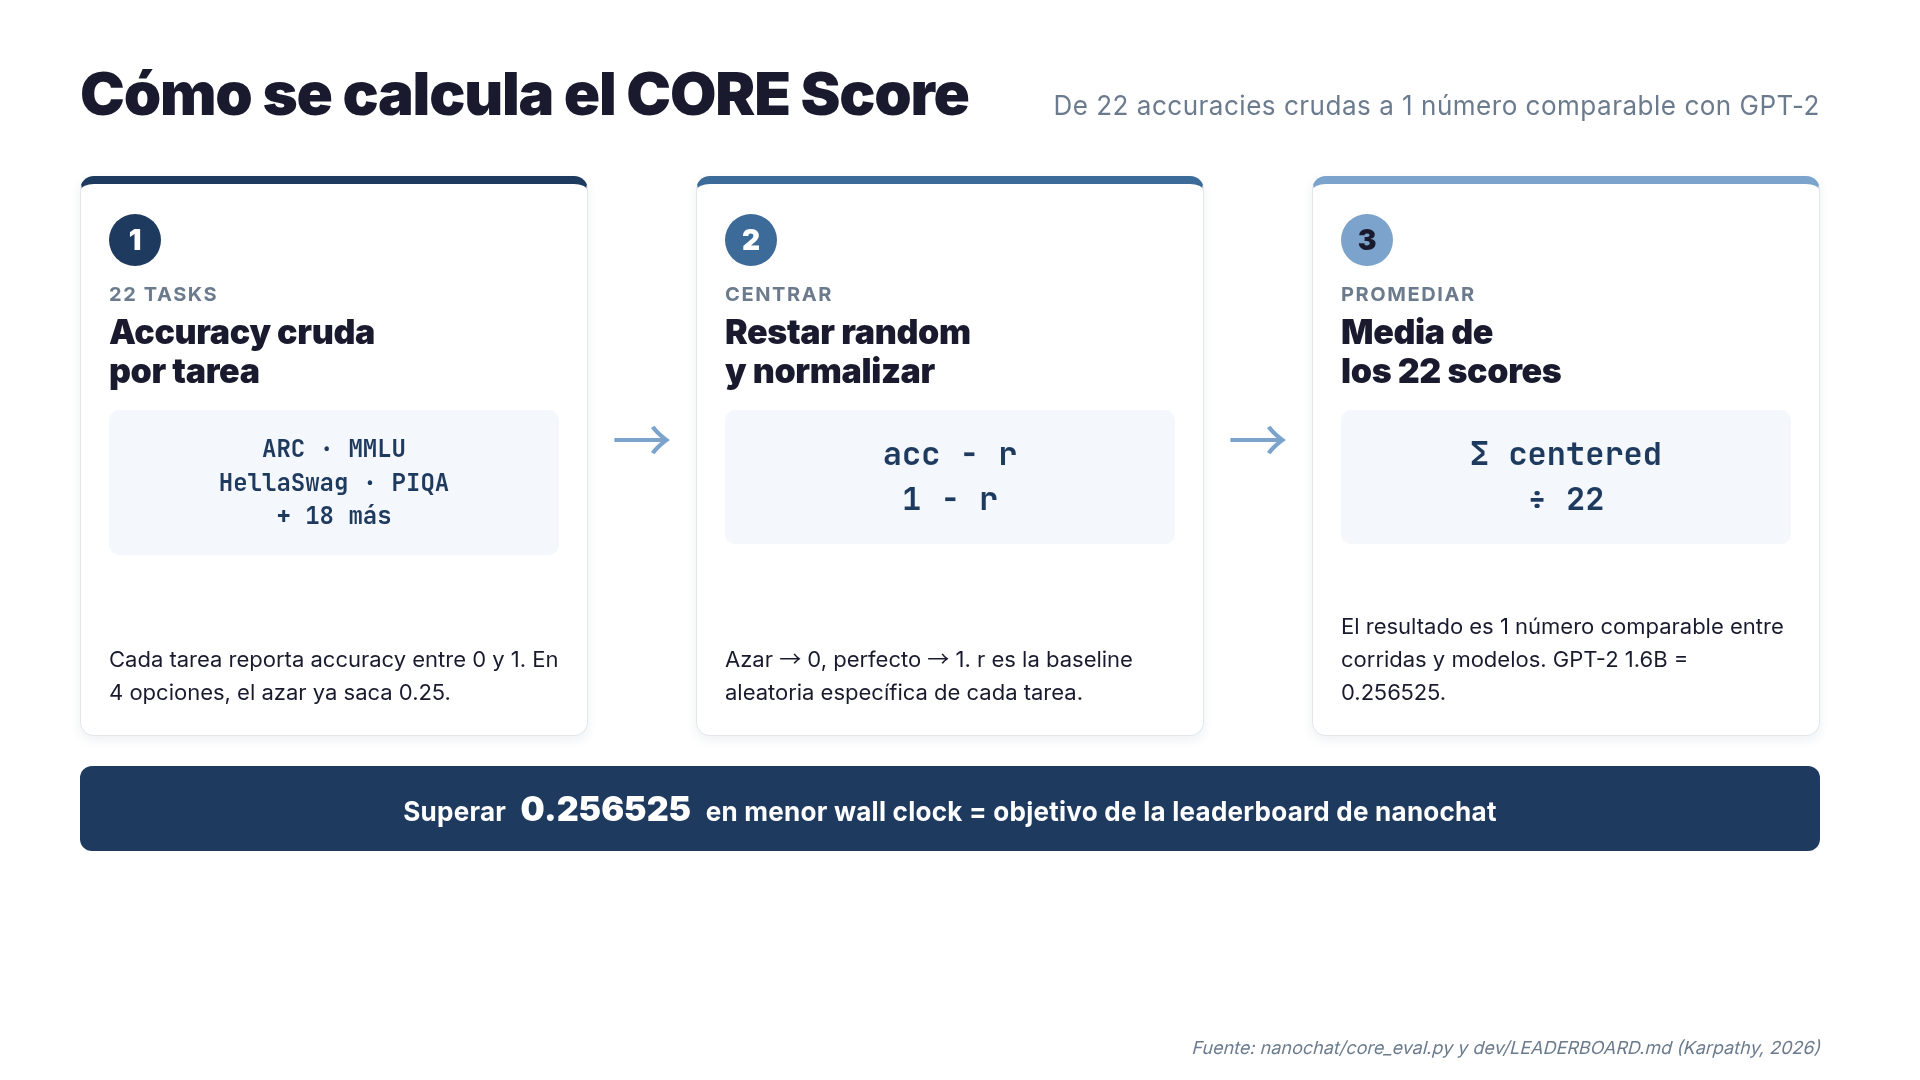
La lista incluye ARC-Easy, ARC-Challenge, MMLU, HellaSwag, PIQA, OpenBookQA y otras 16 tareas más. Cada una devuelve una precisión cruda (accuracy) entre 0 y 1. Si te limitas a promediar esas 22 accuracies, sale un número — pero uno engañoso. En una tarea de 4 opciones, un modelo que contesta al tuntún ya se lleva 0.25 de precisión. Ese 0.25 no cuenta como “capacidad”; es el suelo.
El truco está en cómo reescala el cálculo cada resultado. En scripts/base_eval.py:
accuracy = evaluate_task(model, tokenizer, data, device, task_meta)
random_baseline = random_baselines[label]
centered_result = (accuracy - 0.01 * random_baseline) / (1.0 - 0.01 * random_baseline)
La fórmula reescala cada tarea: si el modelo va a suerte, el centered_result sale 0; si acierta todo, sale 1. Se promedian los 22 valores centrados y de ahí sale el CORE Score.
core_metric = sum(centered_results.values()) / len(centered_results)O sea, cuando lees 0.256525 en ningún caso equivale a “GPT-2 acertó el 25% de las preguntas”. Se traduce más bien como “GPT-2 recorre un cuarto del trayecto entre azar puro y acierto perfecto, promediando 22 tareas”. Ojo con mezclarlo con las accuracies crudas que corren por ahí — es otra escala.
Por qué el modelo base no “responde” las preguntas
Un detalle que me llevó su tiempo pillar: el modelo base evaluado con CORE nunca genera texto. Las preguntas de opción múltiple las resuelve por una vía menos obvia.
En core_eval.py, para cada pregunta con 4 opciones, nanochat construye 4 frases completas (“pregunta + opción A”, “pregunta + opción B”, …) y le pide al modelo que calcule la loss (pérdida promedio) de cada continuación. La opción con menor loss es la “respuesta”. Nunca se llama a .generate().
elif task_type in ['multiple_choice', 'schema']:
    mean_losses = [losses[i, si-1:ei-1].mean().item()
                    for i, (si, ei) in enumerate(zip(start_idxs, end_idxs))]
    pred_idx = mean_losses.index(min(mean_losses))
    is_correct = pred_idx == item['gold']
Tiene su lógica cuando caes en que el modelo base todavía no ha aprendido a seguir instrucciones. Los roles de “usuario” o “asistente” le suenan a chino. Lo suyo, para eso lo preentrenaron, pasa por acertar qué continuación de texto suena más natural. La opción “correcta” acaba siendo la que menos le sorprende.
Sirve como forma indirecta de calibrar comprensión sin exigirle al modelo que dialogue.
Es como un examen tipo test para alguien que no sabe hablar
La analogía que me sirve: imagínate a un crío de infantil que aún no encadena frases enteras, pero que sí sabe qué dibujo va con cada palabra. Pedirle que “responda” de viva voz no lleva a ninguna parte; en cambio, si le pones 4 tarjetas y dices la palabra, apunta a la correcta sin pensarlo dos veces.
CORE hace exactamente eso. Le enseña al modelo base 4 finales de frase posibles y observa cuál “elige” (el que menos le sorprende). Como forma de medir capacidad en algo que técnicamente aún no puede mantener una conversación, tiene bastante sentido.
Karpathy lo escribe en el README de nanochat: el resultado de un speedrun es “un modelo de 4e19 FLOPs, un poco como hablar con un niño de kindergarten”. Y no es una gracieta de marketing — es que, literalmente, lo que estás midiendo se reduce a reconocimiento de continuaciones probables. Razonar o dialogar quedan fuera del test.
La leaderboard mide wall clock, no CORE
Cuando abrí dev/LEADERBOARD.md me sorprendió el giro: la leaderboard oficial de nanochat no compite por sacar el CORE más alto. Compite por llegar a 0.256525 en el menor tiempo real posible sobre una máquina 8×H100.
La cita textual del leaderboard: “‘time to GPT-2’ — the wall clock time needed to outperform the GPT-2 (1.6B) CORE metric on an 8XH100 GPU node.”
Eso cambia lo que optimizas. Si la meta pasara por sacar el CORE máximo, tocaría entrenar más pasos, meter más datos, quizá subir parámetros. Pero como la meta es “cruzar 0.256525 rápido”, las ejecuciones ganadoras son las que aprietan la eficiencia: mejor scheduler de learning rate, tokenizador más fino, menos overhead entre steps.
Es un benchmark de ingeniería antes que uno de calidad de modelo. Y tiene una virtud práctica de peso: se reproduce. Cualquiera con acceso a 8×H100 lanza speedrun.sh y compara contra la leaderboard. Se acaban las dudas de “qué evaluación usaste” o “qué hiperparámetros probaste antes de publicar el número”. Lanzas el speedrun y el reloj se encarga del resto.
ChatCORE es otra cosa (5 tareas, no 22)
Ojo con mezclarlo con ChatCORE, que es un score aparte para modelos post-SFT o post-RL y evalúa solo 5 tareas: ARC-Easy, ARC-Challenge, MMLU, GSM8K y HumanEval. Las dos últimas son generativas — GSM8K pide al modelo que redacte la solución de un problema aritmético, y HumanEval que escriba código capaz de pasar tests reales. Ninguna de las dos se resuelve eligiendo la opción con menor loss.
La baseline aleatoria de GSM8K y HumanEval está clavada en 0%: “contestar al azar” pierde sentido cuando la respuesta es un número exacto o un bloque de código. Cualquier puntuación positiva cuenta como capacidad real.
Cuando veas un post que suelte “CORE 0.4” hablando de un modelo chat, casi seguro se refieren a ChatCORE. Escalas distintas, comparación directa descartada.
Cómo leer un número de CORE en el wild
Con todo esto ya digerido, mi regla de bolsillo para interpretar un CORE Score de una ejecución cualquiera:
- < 0.15: el modelo apenas se despega del azar. Preentrenamiento incompleto o dataset malo.
- 0.15 – 0.25: modelo funcional pero por debajo de GPT-2. Útil para debuggear el pipeline, no para producción.
- ~ 0.256525: paridad con GPT-2 1.6B (2019). El objetivo declarado de nanochat.
- 0.30 – 0.40: rango donde caen modelos modernos pequeños bien entrenados.
- > 0.50: territorio de modelos grandes o de datasets muy afinados.
Y siempre, siempre, pedir el val_bpb (bits per byte) al lado del CORE. val_bpb es un indicador de loss normalizado por bytes, más estable y bastante menos ruidoso; se calcula en nanochat/loss_eval.py. La convención de nanochat pasa por publicar los dos juntos, porque cada uno pilla lo que al otro se le escapa.
0.256525 tampoco tiene nada de mágico: es el punto donde alguien puso una raya en 2019 y dijo “aquí estamos”. Lo interesante llega después — que 6 años más tarde una config laptop-grade se meriende esa raya en horas.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev
 Libro relacionado Convirtiendo LLMs de Mentirosos en Expertos Ingeniería de Contexto desde cero — RAG, MCP, CLAUDE.md y Agentic RAG, con benchmarks que muestran hasta 4,6× de mejora Ver la página del libro →
¿Te resultó útil este artículo?