OpenAI Realtime API: bajar tu voz IA a 300ms
Cuando dos humanos conversan, el intervalo entre “termino de hablar yo” y “empiezas tú” es de alrededor de 200 milisegundos. Es una constante casi universal: Levinson y Torreira midieron esa cifra en diez idiomas distintos y el rango se movía apenas unas decenas de milisegundos entre culturas. El cerebro empieza a percibir “algo va mal” cuando la pausa se pasa de los 300 ms.
Tu voice bot típico, montado como cascada STT + LLM + TTS, tarda 525 ms en el mejor de los casos. En el promedio real, 1.3 segundos. Si preguntas por qué el usuario dice que “suena robótico” antes incluso de escuchar la voz sintetizada, la respuesta está ahí: el timing traiciona antes que el timbre.
Este es el desglose de dónde se van esos 525 ms, y las tres palancas concretas que estoy usando en 2026 para bajarlo a menos de 300 ms end-to-end.
De dónde vienen los 525 ms
La cascada clásica encadena cuatro etapas y cada una añade latencia irrecuperable.
| Componente | Óptimo | Real | Peor caso |
|---|---|---|---|
| STT (voz → texto) | 200 ms | 350 ms | 500 ms |
| LLM (razonamiento) | 150 ms | 500 ms | 1000 ms |
| TTS (texto → voz) | 75 ms | 200 ms | 300 ms |
| Red (WebSocket / HTTP) | 50 ms | 150 ms | 300 ms |
| VAD y buffering | 50 ms | 100 ms | 200 ms |
| Total | 525 ms | 1300 ms | 2300 ms |
Es como armar un Fórmula 1 con las mejores piezas del mercado y descubrir, al encender el motor, que anda menos que un auto compacto. Cada pieza optimizada por su lado, todas encadenadas mata el conjunto.
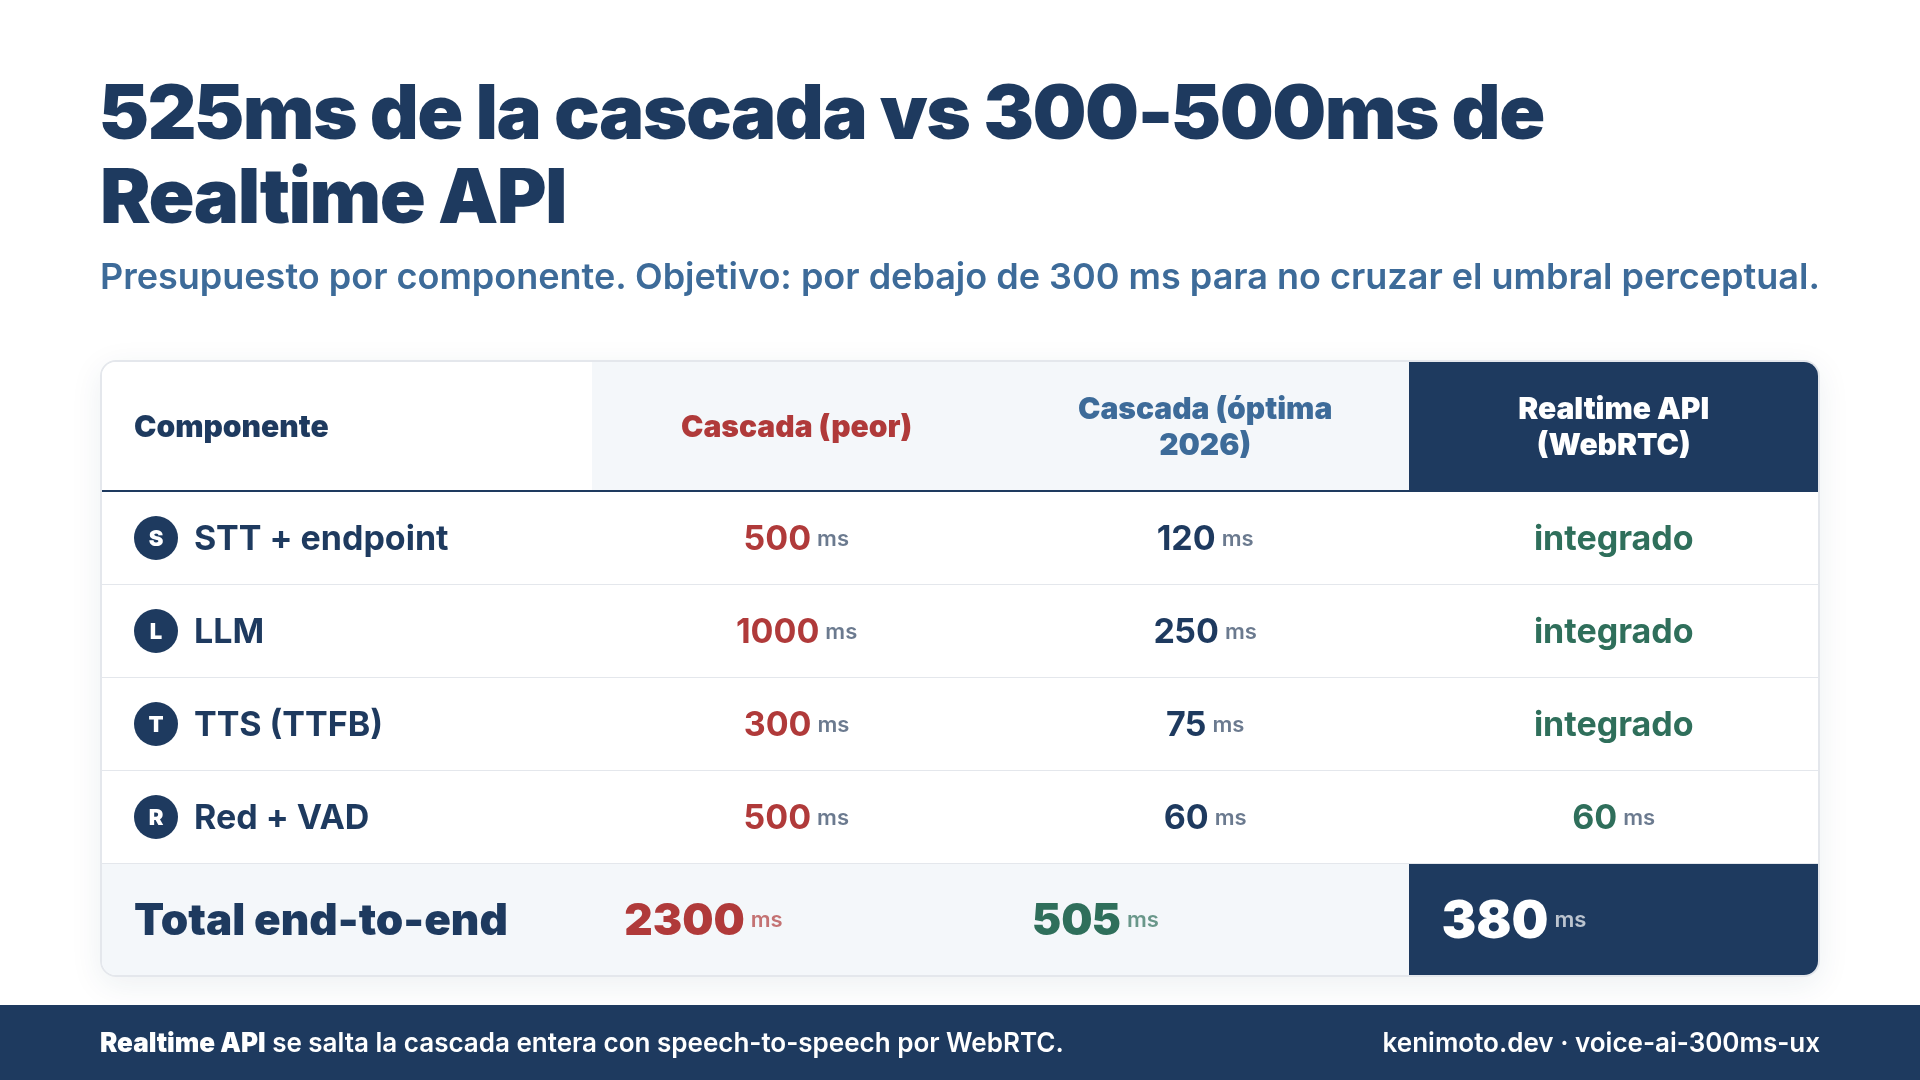
Y hay otro problema oculto en la cascada: la propagación de errores. Si el STT confunde “flight” con “fright”, el LLM razona sobre la palabra equivocada, el TTS locuta el resultado equivocado con voz segura, y el usuario recibe un enunciado coherente pero surrealista. La cascada no solo es lenta; también es frágil.
Palanca 1: modelo integrado speech-to-speech (OpenAI Realtime API)
La primera palanca es la más radical: saltarse la cascada entera. OpenAI Realtime API, con conexión WebRTC directa, procesa el audio de entrada y produce audio de salida en un solo modelo, sin pasar por texto intermedio.
Números públicos actualizados para 2026:
- 300-500 ms end-to-end en modo native speech-to-speech con WebRTC
- 150-250 ms para respuestas cortas de tipo confirmación
- ICE Trickle empieza a fluir el media antes de que termine el handshake ICE, recortando cientos de ms del arranque
La condición dura es el transporte. WebRTC directo desde el navegador o el celular al edge de OpenAI es la única configuración que da esos números. Si metes un proxy WebSocket, un gateway telefónico o un codec de compresión intermedio, la ventaja se evapora y vuelves a la zona de los 800 ms.
En mi setup — un laboratorio casero en Tokio, con una laptop conectada por fibra al edge más cercano — el número que veo estable es 380 ms end-to-end para turnos de conversación completos. Si vives en Ciudad de México, São Paulo o Buenos Aires, el edge más cercano de OpenAI probablemente está en Virginia o São Paulo, así que suma la latencia geográfica al presupuesto (unos 40-90 ms adicionales según región).
Palanca 2: STT sub-300 ms con endpoint detection semántico (Deepgram Nova-3)
Si tu caso de uso no acepta un modelo integrado — por ejemplo, necesitas control fino del prompt, o el LLM tiene tools propias, o el compliance exige guardar el texto intermedio — la cascada se queda. Pero puedes atacar cada etapa.
La primera etapa a atacar es el STT, porque además del reconocimiento carga con la detección de fin de turno (VAD, endpoint detection). Ese detector es el que decide “ya terminó de hablar el usuario, dispara el LLM”.
Deepgram Nova-3 entrega STT en menos de 300 ms, y su feature Flux endpoint detection hace algo que el VAD clásico no hacía: entiende contexto semántico, no solo silencio. El VAD viejo se disparaba con cualquier pausa de más de 500 ms — incluyendo las que haces cuando dices “eeeh… déjame pensar”. Flux distingue la pausa reflexiva de la pausa terminal y no dispara el LLM hasta que el usuario realmente cerró la frase.
Impacto en el presupuesto: entre 300 y 500 ms recuperados en un turno típico, sin cambiar el resto de la stack. La mayor parte del ahorro no viene del STT en sí sino del endpoint detection: no esperas a que termine el timeout de silencio para arrancar el LLM.
Palanca 3: TTS con time-to-first-byte de 75 ms (ElevenLabs Flash v2.5)
La tercera palanca es la salida. Aquí el número que importa no es “cuánto tarda en generar el audio completo” sino cuánto tarda en producir el primer byte de audio — el time-to-first-byte (TTFB). El usuario percibe la latencia hasta que empieza a oír; el tiempo total de síntesis es irrelevante.
ElevenLabs Flash v2.5 reporta 75 ms de TTFB. Together AI con Orpheus reporta 187 ms. Ambos están muy por debajo del típico Google Cloud TTS (350 ms) o Amazon Polly (280 ms).
El truco de diseño que hace posible esos 75 ms es que streamas el audio a medida que el LLM produce tokens, en vez de esperar a que termine la frase completa. Requiere un TTS que acepte texto en streaming y produzca audio en streaming. Los TTS legacy que reciben un string completo y devuelven un archivo WAV no sirven para este juego.
Combinada con las otras dos palancas, es la diferencia entre “el usuario nota una espera” y “el usuario asume que hay alguien del otro lado”.
Presupuesto de latencia end-to-end (2026)
Con las tres palancas aplicadas a una stack de cascada realista:
| Etapa | Configuración clásica | 2026 optimizada |
|---|---|---|
| STT + endpoint | 350 ms | 120 ms (Nova-3 + Flux) |
| LLM (streaming) | 500 ms | 250 ms (GPT-4o mini streaming) |
| TTS TTFB | 200 ms | 75 ms (Flash v2.5) |
| Red (WebRTC) | 150 ms | 60 ms (WebRTC directo) |
| Total | 1200 ms | ~505 ms |
Y si te saltas la cascada con Realtime API, bajas a 300-500 ms end-to-end en un solo salto arquitectónico.
En mi benchmark casero de 2026 comparé cinco stacks distintas (solo dos bajaron de 300 ms), y el patrón fue consistente: la stack integrada gana cuando el flujo cabe en un solo modelo, la cascada optimizada gana cuando necesitas romper el flujo para insertar herramientas propias.
Lo que aprendí midiendo (no adivinando)
Tres cosas que cambiaron mi criterio de diseño después de meter cronómetro a cada componente:
No confíes en el promedio, mira el P95. Un pipeline que promedia 400 ms pero tiene un P95 de 1.8 segundos rompe la experiencia una vez cada 20 turnos. Un usuario que tuvo una conversación fluida y de golpe siente el silencio, asume que el bot se colgó y cuelga él primero. El worst case define la percepción; el promedio miente.
El presupuesto se gasta antes de que empieces a optimizar. Cada TLS handshake, cada bucket S3 en otra región, cada log síncrono, se come 30-80 ms que no vuelves a recuperar. Antes de invertir en Nova-3 o Flash, mide qué se va en cosas que no son STT/LLM/TTS. Muchas veces la pelea real está en el transporte más que en el modelo.
El usuario tolera 300 ms de espera si sabe que la máquina lo escuchó. Un “backchannel” audible — un “mhm” corto, o incluso el sonido de una respiración — a los 150 ms te compra otros 200 ms de tolerancia. El presupuesto de latencia no es solo técnico; es psicoacústico.
Cierre
Los 200 ms de la conversación humana son un dato biológico. Los 300 ms del umbral perceptual son un dato psicológico. Los 525 ms de la cascada por defecto son un dato de ingeniería, y esa parte sí depende de nosotros.
Las tres palancas — Realtime API, Nova-3 con Flux, Flash v2.5 — no son experimentales; son producción en 2026. Si tu voice bot suena robótico y ya afinaste la voz, el problema probablemente no es el timbre. Es el reloj.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev
¿Te resultó útil este artículo?