Tree-sitter code review: 3 pasos sin IA
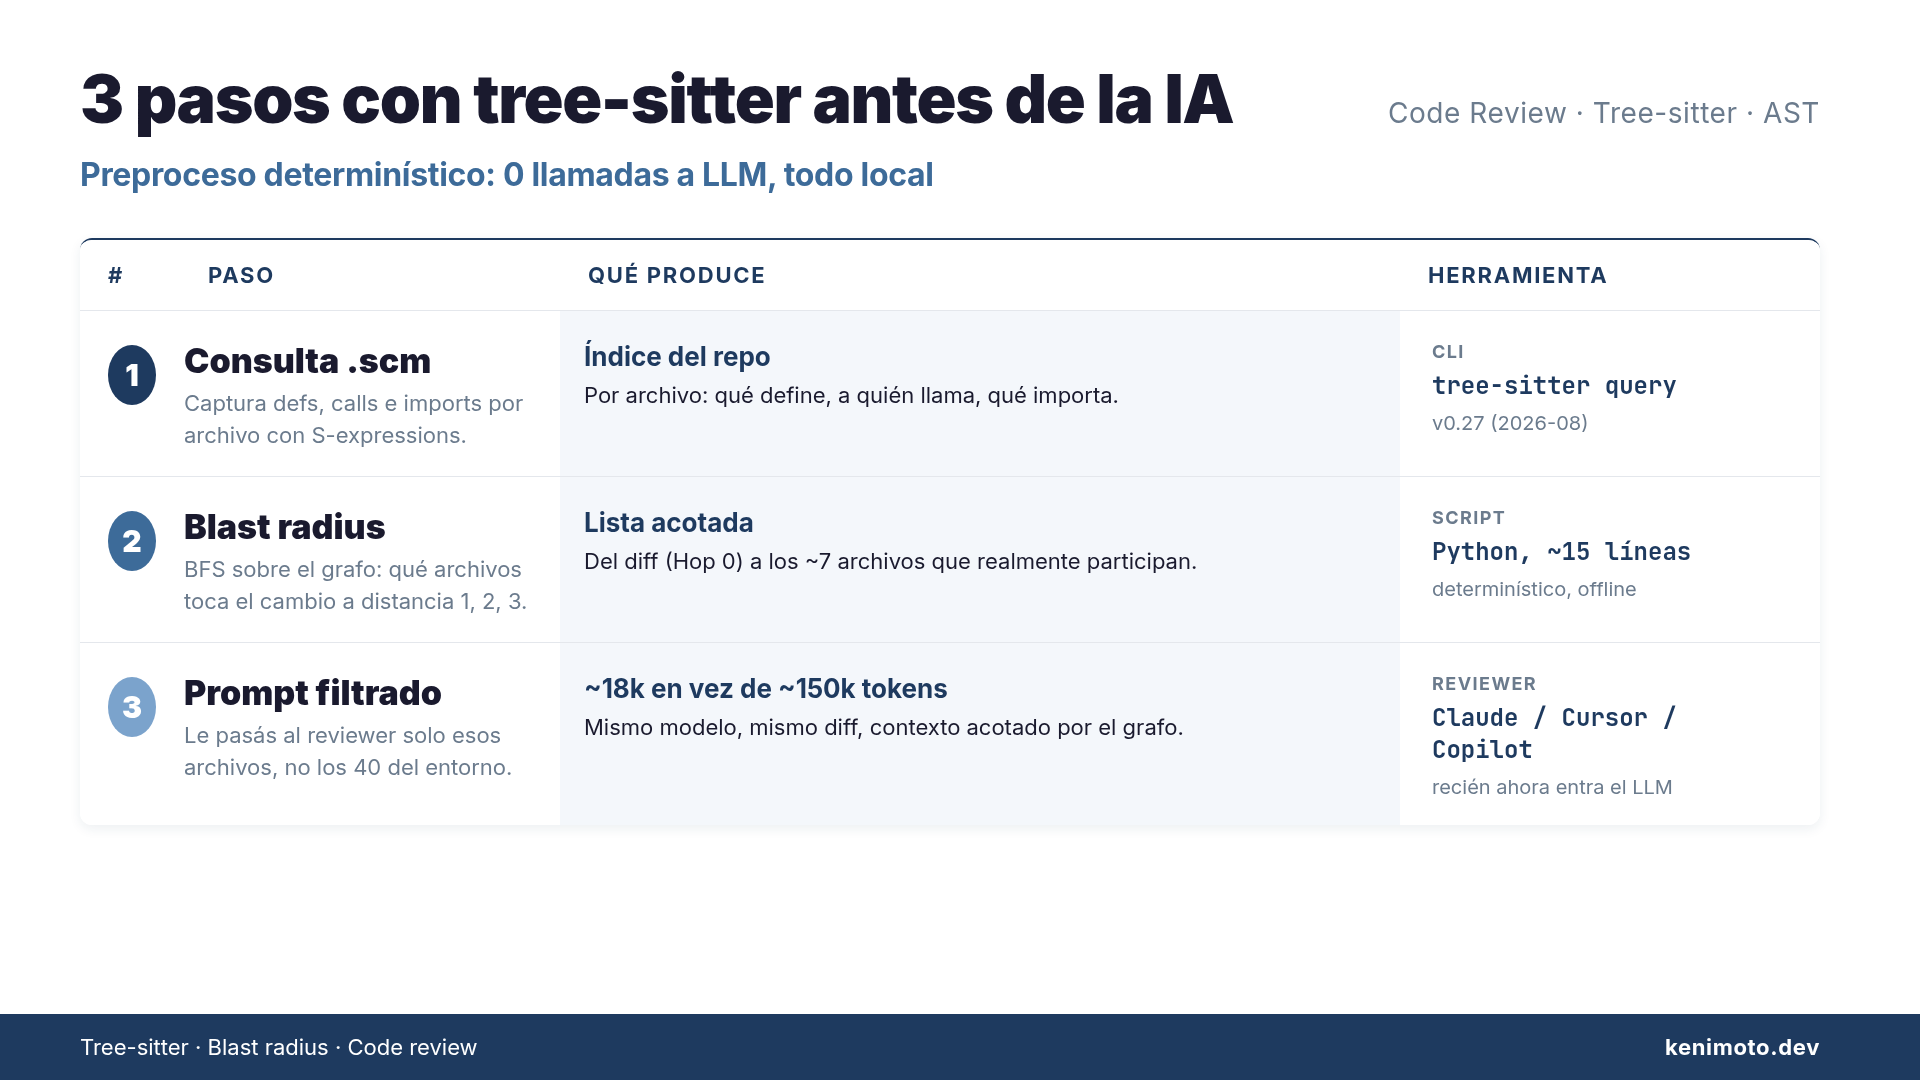
Antes de pedirle una review a Claude —o a Cursor, o a Copilot— corro tres pasos con tree-sitter. Los tres son deterministas, se ejecutan en local y no llaman a ningún LLM. Cuando el LLM entra al final, mira solo los archivos que la estructura del código señala como parte del cambio, y no los cuarenta o cincuenta que uno acaba metiendo por si acaso.
En el post original en portugués —el paso más valioso de la review de código por IA no usa IA— resumí la idea en un número: el mismo cambio, pasado al mismo modelo, baja de unos 150k tokens de contexto a unos 18k. Lo que hace caer la cifra es el preproceso, no el modelo. Aquí reconstruyo ese preproceso con los tres pasos concretos y los ejemplos de .scm que necesitas para reproducirlo.
Por qué “meter más contexto” empeora la review
Uno tiende a pensar que, si le paso al modelo el archivo del PR más cuarenta vecinos, va a ver más y va a encontrar más problemas. En code review es al revés. Con 150k tokens el modelo se dispersa: comenta el README viejo, señala un helper que ya nadie llama, y el problema del diff real queda diluido entre el ruido.
Y encima pagas por token. Con Claude, con la API de Anthropic o con cualquier proveedor por uso, pasar de 150k a 18k son unos dólares o unos céntimos por review. Multiplica por los PRs que abras en la semana y ya te aparece como una línea visible en la factura.
Lo interesante es esto: el trabajo que más mejora la review no lo hace el modelo. Lo hace un pipeline determinista que decide qué le vas a mostrar. Se apoya en tree-sitter y no gasta un solo token.
Paso 1: consulta .scm — qué define y qué llama cada archivo
Tree-sitter es la librería que parsea código a AST (árbol sintáctico). Se ejecuta 100% en local, es determinista y ya cubre más de cuarenta lenguajes con parser oficial y unas trescientas gramáticas de la comunidad. Su CLI actual (v0.27, agosto 2026) trae un subcomando query que aplica un archivo .scm sobre el fuente y devuelve las capturas.
Un .scm es un archivo con patrones S-expression (sintaxis tipo Lisp) que le indican al parser qué nodos capturar. Los tres patrones que necesitas para montar el grafo del repo son: defs (dónde se define cada símbolo), calls (a quién llama cada función) e imports (qué módulos importa cada archivo).
Para JavaScript / TypeScript:
; defs.scm
(function_declaration
  name: (identifier) @def.function)

(class_declaration
  name: (identifier) @def.class)

; calls.scm
(call_expression
  function: (identifier) @call.callee)

; imports.scm
(import_statement
  source: (string) @import.module)
Para Python:
; defs.scm
(function_definition
  name: (identifier) @def.function)

(class_definition
  name: (identifier) @def.class)

; calls.scm
(call
  function: (identifier) @call.callee)

; imports.scm
(import_from_statement
  module_name: (dotted_name) @import.module)
Se lanza desde la línea de comandos:
tree-sitter query defs.scm src/**/*.tsLa salida es la lista de capturas por archivo. Nada de esto sale de tu máquina y ningún LLM aparece en el trayecto. Cuando termina el paso 1 tienes un índice concreto: por archivo, qué define, a quién llama y qué importa.
Paso 2: blast radius — de la lista de archivos, solo los que importan
Con los tres índices del paso 1, el repo ya es un grafo. Cada arista es concreta: “login.ts llama a auth.ts”. La operación clave se llama blast radius: partiendo del archivo (o los archivos) del diff (Hop 0), pintas los que dependen de él a distancia 1, 2, 3.
Se resuelve con un BFS de unas quince líneas de Python encima del índice del paso 1. La entrada es el diff; la salida, la lista de archivos afectados. El ejemplo del post en portugués:
Cambio: auth.py

Hop 0: auth.py
Hop 1: middleware.py, api/login.py, api/register.py
Hop 2: tests/test_auth.py, tests/test_login.py
Hop 3: conftest.py

Archivos afectados: 7
Siete archivos, no cincuenta. Y no es una opinión: la lista sale del grafo, y cualquiera que corra el mismo pipeline sobre el mismo commit obtendrá la misma lista.
Hop 2 suele ser el corte natural. De Hop 3 en adelante empiezan a colarse archivos que “tocan” el módulo pero no participan del cambio (por ejemplo un conftest.py compartido con toda la suite de tests). Si el blast radius devuelve cuarenta archivos, el corte está mal puesto: casi siempre hay alguna utility de uso masivo —un logger, un parse, un format— con un grado tan alto en el grafo que arrastra medio repo detrás. Lo práctico es tratar esos nodos aparte, con un umbral por grado, y no seguirlos como al resto de las dependencias. La parte estructural del grafo la desarrollo en mi libro sobre knowledge graphs de código.
Paso 3: prompt filtrado — solo esos archivos entran al LLM
Ahora sí, la IA. La cosa es directa: en vez de pegarle al reviewer el archivo modificado más “el entorno que parezca relevante”, le pasas el archivo modificado más exactamente los que devolvió el blast radius.
Cómo se traduce eso al día a día:
- Con Claude Code, listas esos paths como contexto explícito al abrir la sesión (por ejemplo referenciándolos con
@archivo.tsen el prompt inicial) en vez de dejar que el agente decida por su cuenta qué archivos leer. - Con la API de Anthropic, montas el mensaje con el diff más el contenido de esos archivos concatenado, y nada más.
- Con Cursor o Copilot Chat, seleccionas solo esos archivos como contexto y evitas el “auto-context” que arrastra medio repo.
No hay un CLI mágico para este paso; consiste en pasarle al reviewer la lista del paso 2. Ahí es donde cae el número: en el pipeline que documenté en el post en portugués, el mismo review pasa de ~150k a ~18k tokens de input. Mismo modelo y mismo diff; lo único que cambia es lo que entra al contexto.
Por qué el paso más valioso no es el LLM
La intuición dice que la inteligencia de la review vive en el modelo: cuanto mejor sea el modelo, mejor la review. Es parcialmente cierto, pero el techo lo pone otra cosa. El modelo solo puede razonar bien sobre el material que le pases; si le pasas cincuenta archivos con contexto sucio, hasta el mejor modelo va a producir una review sucia.
Tree-sitter es viejo, aburrido y gratuito. Parsea código, aplica queries y devuelve nodos. No compite con el LLM sino que lo prepara. Y precisamente por no usar IA en este paso, todo queda determinista y auditable: si el blast radius trae siete archivos que no cuadran, el problema está en el grafo y se arregla en el grafo; no es un problema del modelo que se “resuelva” cambiando de proveedor.
Esta separación —preproceso determinista + LLM sobre contexto acotado— es la misma que aparece en un RAG bien hecho, en agentes con un tool-use bien acotado y en el pipeline de code review que estoy describiendo aquí. Lo que importa es el patrón, no la herramienta concreta.
Cierre
Si el code review con IA te sale caro o inconsistente, mira el paso previo antes de cambiar de modelo. Tres pasos con tree-sitter —.scm para capturar defs, calls e imports; BFS para el blast radius; prompt con solo esos archivos— resuelven el grueso del problema sin llamar a un LLM.
El post original en portugués trae la métrica completa y el diagrama del recorte de 150k → 18k. La parte estructural del pipeline —cómo montar el grafo de código con tree-sitter y usar blast radius por encima— la desarrollo en mi libro sobre knowledge graphs de código, listado en la página de libros.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev
 Libro relacionado Practical Claude Code Claude Code desde cero hasta producción — CLAUDE.md, Plan Mode y workflows de equipo, desde un año de uso real Ver la página del libro →
¿Te resultó útil este artículo?