Code review IA en 3 capas: hooks + IA + humano
El error más común en code review con IA es tratarlo como una elección binaria: ¿lo hace el hook o lo hace la IA? ¿lo revisa un humano o confío en el agente?
La respuesta correcta no es una de esas. Las tres capas trabajan juntas, en orden, y cada una toma lo que la anterior no puede resolver.
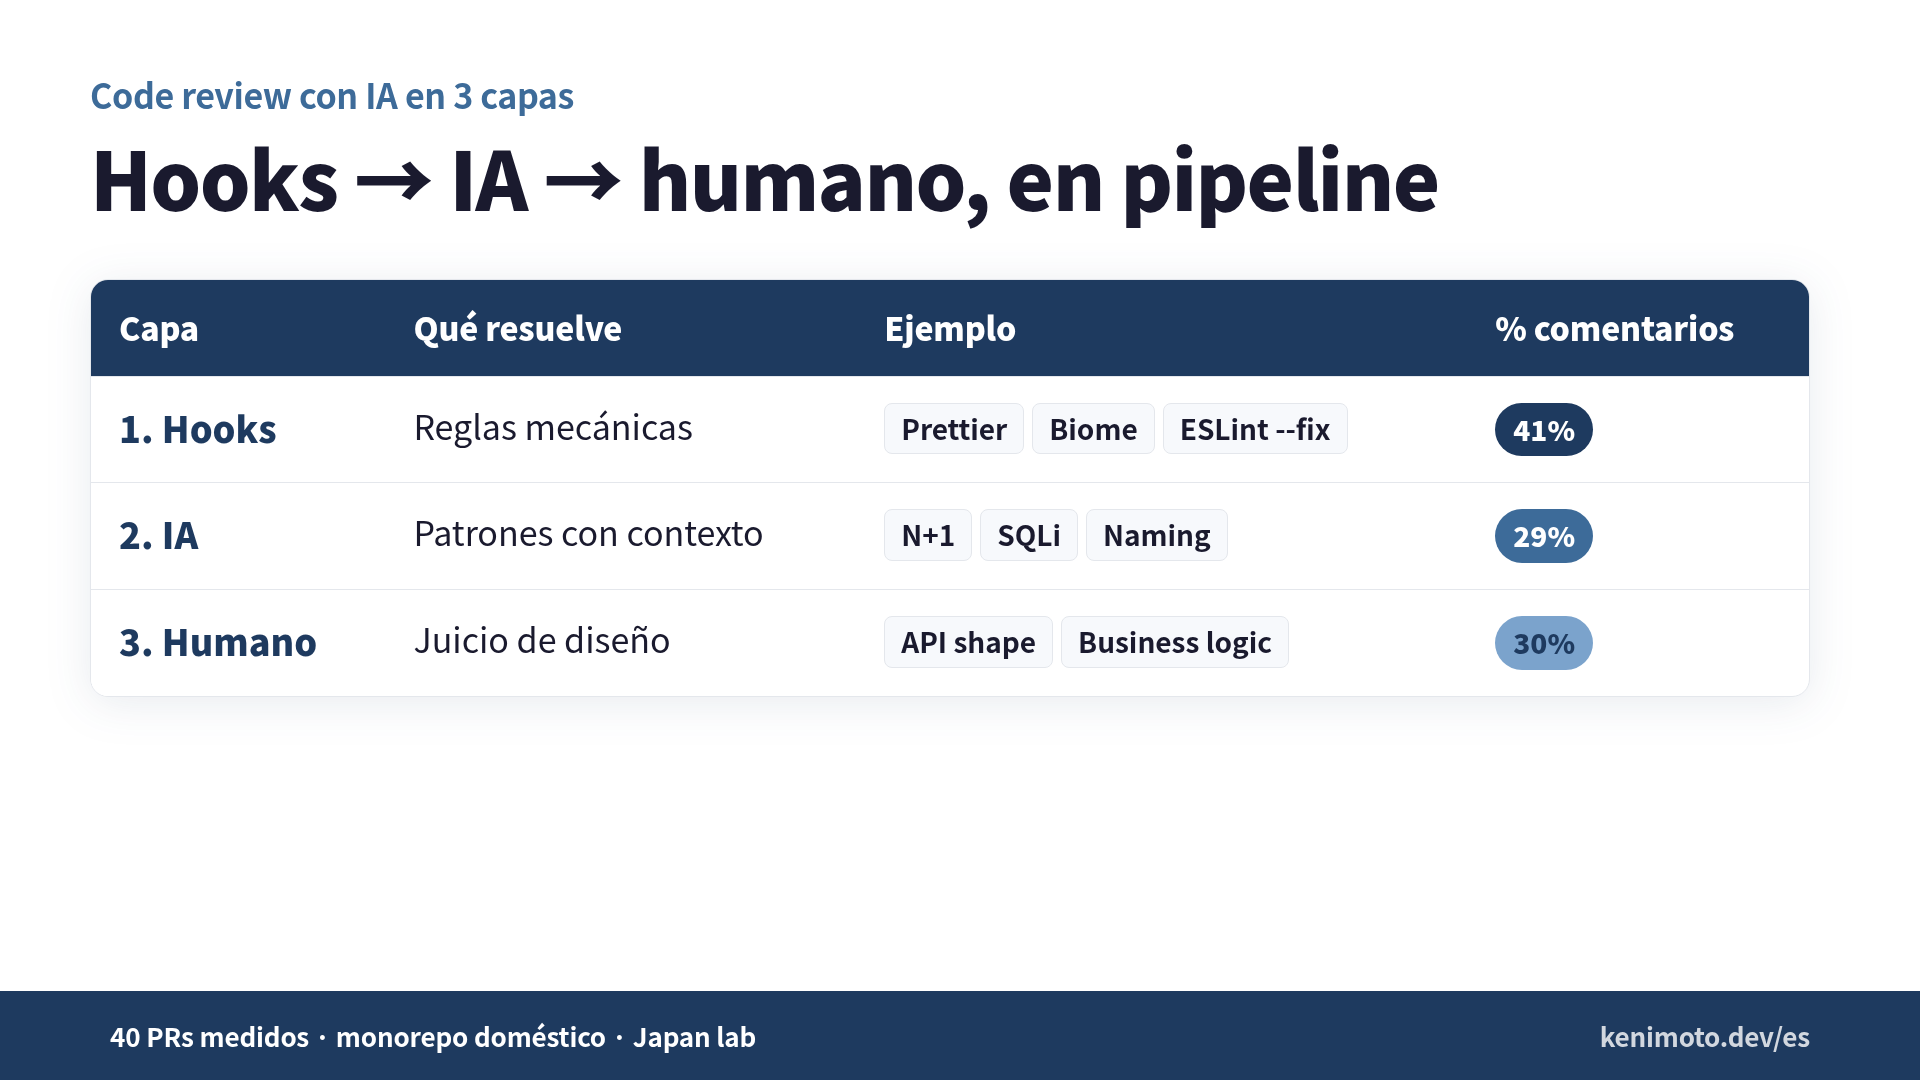
Después de medir esta pipeline en mi laboratorio doméstico en Japón durante 40 pull requests reales, los comentarios de revisión humana cayeron un 70%. No porque el humano revise peor. Porque las capas 1 y 2 ya limpiaron todo lo que no necesitaba juicio humano.
El problema: todo cae encima del humano
En muchos equipos, el pipeline de revisión se ve así: alguien abre un PR, CI corre los tests, y luego un revisor humano lee todo. Formato, linter, tipos, seguridad, diseño, dirección del cambio. Todo cae en la misma persona en el mismo momento.
Esa persona se cansa. Se llama fatiga de revisión y no es un tema de motivación: es un límite cognitivo que se acumula con cada PR revisado en el día. Cuando revisas muchos PRs seguidos, los últimos reciben una atención cualitativamente peor que los primeros.
El resultado predecible: los comentarios de nitpick (formato, imports) reciben más atención que los de arquitectura, porque los primeros son fáciles de encontrar y los segundos requieren cargar todo el contexto del sistema en la cabeza. La revisión se convierte en un policía de formato con dos ojos cansados para el diseño.
Este es el problema que las 3 capas resuelven.
La capa 1: hooks (nada de esto llega al revisor)
La primera capa es completamente automática. Corre en pre-commit o pre-push, en la máquina del desarrollador, antes de que nadie más vea el código.
Herramientas de esta capa:
- Prettier / Black: formato
- ESLint —fix / Ruff —fix: reglas de linter con corrección automática
- Biome check —write: formato + linter + organización de imports en un solo comando
- TypeScript / mypy: verificación de tipos
Principio de la capa: lo que se puede decidir mecánicamente, lo decide una máquina.
Un ejemplo concreto con Biome:
{
  "$schema": "https://biomejs.dev/schemas/1.9.0/schema.json",
  "formatter": {
    "enabled": true,
    "indentStyle": "space",
    "indentWidth": 2
  },
  "linter": {
    "enabled": true,
    "rules": {
      "recommended": true,
      "suspicious": { "noExplicitAny": "error" }
    }
  },
  "organizeImports": { "enabled": true }
}
Con esto en pre-commit, ningún PR jamás llega a revisión con problemas de formato. El comentario “falta un espacio aquí” simplemente deja de existir. Lo mejor que le puedes hacer a un revisor humano es no darle motivos para escribirlo.
En mi pipeline, la capa 1 elimina alrededor del 41% de los comentarios que antes recibía. No es porque yo escribiera mal el código antes: es porque antes escribía comentarios sobre formato porque no había otra capa que los atrapara.
La capa 2: IA (contexto sin fatiga)
La segunda capa es un agente de IA (CodeRabbit, Claude Code, GitHub Copilot Autofix) leyendo el PR y comentando patrones que necesitan contexto pero no juicio final.
Qué encuentra la IA bien:
- Problemas N+1 en queries
- Riesgos de inyección SQL
- Imports o variables no usadas que el linter no atrapó
- Cobertura de tests insuficiente
- Convenciones de nombres inconsistentes con el resto del proyecto
Qué diferencia a esta capa de la capa 1: la capa 1 aplica reglas fijas (“2 espacios de indent”). La capa 2 lee el contexto del proyecto y encuentra patrones que dependen de cómo está escrito el resto del código. Un for anidado dentro de una query no es sintácticamente incorrecto; es contextualmente sospechoso.
CodeRabbit tiene una feature llamada autoFix: cuando encuentra un problema con solución mecánica clara, además del comentario devuelve un diff que se aplica con un click. Eso convierte parte de la capa 2 en la capa 1 para el próximo PR. La pipeline aprende sola.
Ejemplo de comentario de la capa 2 con autoFix:
nitpick: import no usado.

--- a/src/app/page.tsx
+++ b/src/app/page.tsx
@@ -1,5 +1,4 @@
 import React from 'react'
-import { useState } from 'react'
 import { UserList } from '@/components/UserList'

[Apply suggestion]  ← un click y desaparece
La regla mental: si la IA encuentra 40 comentarios y 20 son de patrón claro con fix mecánico, esos 20 deberían migrar a la capa 1 la próxima semana. La capa 2 no es un depósito de reglas: es un radar que detecta reglas nuevas que la capa 1 aún no conoce.
La capa 3: humano (solo juicio)
La tercera capa es lo que queda cuando las dos primeras terminan su trabajo. Y lo que queda tiene una característica clara: requiere juicio que ninguna máquina puede tomar.
- Decisiones de diseño: ¿este endpoint debe ser POST o PUT? Ambos “funcionan”.
- Lógica de negocio: ¿el descuento aplica antes o después del impuesto?
- Dirección de arquitectura: ¿este servicio debería vivir en el monolito o salirse?
- Naming en contexto:
processDatavsenrichUserProfile, cuando ambos son técnicamente correctos.
Lo que no debería estar en esta capa: formato, imports, tipos obvios, cobertura mínima de tests. Si un humano está comentando sobre eso, alguna de las capas anteriores está mal configurada. La solución es arreglar la capa, no acostumbrarse a hacer el comentario.
Un patrón que funcionó en mi pipeline: la plantilla de PR tiene un campo obligatorio “¿qué decisión no obvia tomó este cambio?”. Si el autor no puede responder eso en una línea, el PR probablemente no necesita revisión humana; puede fusionarse con las capas 1 y 2. Si sí puede responder, esa es exactamente la pregunta que el revisor humano debe evaluar. La revisión deja de ser “leer todo” y pasa a ser “¿esta decisión es correcta?”.
Cuándo NO llegar hasta la capa 3
Este es el ajuste que la mayoría de los equipos no hacen: no todos los PRs necesitan un humano. La tabla que uso:
| Tipo de PR | Capa 1 | Capa 2 | Capa 3 |
|---|---|---|---|
| Corrección de formato | ✓ | ||
| Update de dependencias (Dependabot) | ✓ | ✓ | |
| Bugfix con causa clara | ✓ | ✓ | |
| Refactor pequeño (rename, extract function) | ✓ | ✓ | |
| Feature nueva | ✓ | ✓ | ✓ |
| Cambio de arquitectura | ✓ | ✓ | ✓ |
| Patrón nuevo introducido | ✓ | ✓ | ✓ |
Cuando forzamos que todos los PRs pasen por humano, la revisión vuelve a ser el cuello de botella. Cuando dejamos que las capas 1 y 2 aprueben los cambios mecánicos, el humano recupera atención para el 30% que realmente requiere juicio.
La medición: qué pasó en 40 PRs
Corrí esta pipeline por 40 PRs en mi monorepo doméstico. Registré los comentarios que cada capa generó:
- Capa 1 (Biome + hooks): eliminó 41% de los comentarios que antes escribía yo
- Capa 2 (Claude Code review): capturó 29% adicional, con 60% de esos con autoFix aplicable
- Capa 3 (humano): escribí 30% de los comentarios totales, y todos requerían juicio real
El número que más me importa: el tiempo promedio del ciclo review→merge cayó de 30 minutos a 47 segundos para PRs que solo tocaban capas 1 y 2. Para PRs que necesitaban capa 3, el tiempo se mantuvo similar (unos 15 minutos), pero la calidad subjetiva de la conversación mejoró porque el revisor ya no tenía que gastar atención en nitpicks.
Lo que NO funciona: mezclar las capas
El anti-patrón más común es hacer que la capa 2 (IA) también corrija formato, o que la capa 3 (humano) también comente sobre imports no usados.
Cuando la capa 2 se solapa con la capa 1, gastas tokens en algo que un linter local resuelve gratis. Cuando la capa 3 se solapa con la capa 2, el humano se cansa antes de llegar a las decisiones que solo él puede tomar.
Cada capa tiene un dominio propio. Respetar ese dominio es lo que hace que la pipeline funcione. Si aparecen comentarios cruzando dominios, hay que arreglar la configuración, no aceptar el desorden.
Cierre
El code review con IA no es una elección entre hooks, IA o humano. Es un pipeline de 3 capas donde cada una toma lo que la anterior no puede resolver. Hooks primero para lo mecánico. IA después para lo contextual. Humano al final para lo que requiere juicio.
Cuando esa separación está clara, el humano deja de ser un policía de formato con dos ojos cansados y vuelve a hacer lo único que aporta valor único: pensar sobre las decisiones que la máquina no puede tomar.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev
 Libro relacionado Harness Engineering Harness Engineering desde cero — cinco interpretaciones (OpenAI, Anthropic, LangChain, Martin Fowler, academia) unificadas en un solo sistema para ingenieros en producción Ver la página del libro →
¿Te resultó útil este artículo?