Auditei 30 llms.txt em 2026: 5 anti-padrões
Dá para entender quando llms.txt de infra clássica sai quebrado. Anthropic, Stripe, Vercel, Cloudflare: gente grande, com Confluence e comitê. Ninguém fica vigiando o llms.txt.
Aí abri o terminal em 30 empresas do ecossistema de IA, de startups YC recentes a nomes já estabelecidos: Firecrawl, Trigger.dev, Cursor, Modal, Baseten, Braintrust, Warp, Cactus, Cedar, Wisprflow, e por aí. A maioria vende produto para quem desenvolve com LLM. Se alguém deveria acertar llms.txt, seria essa gente.
Não acertaram.
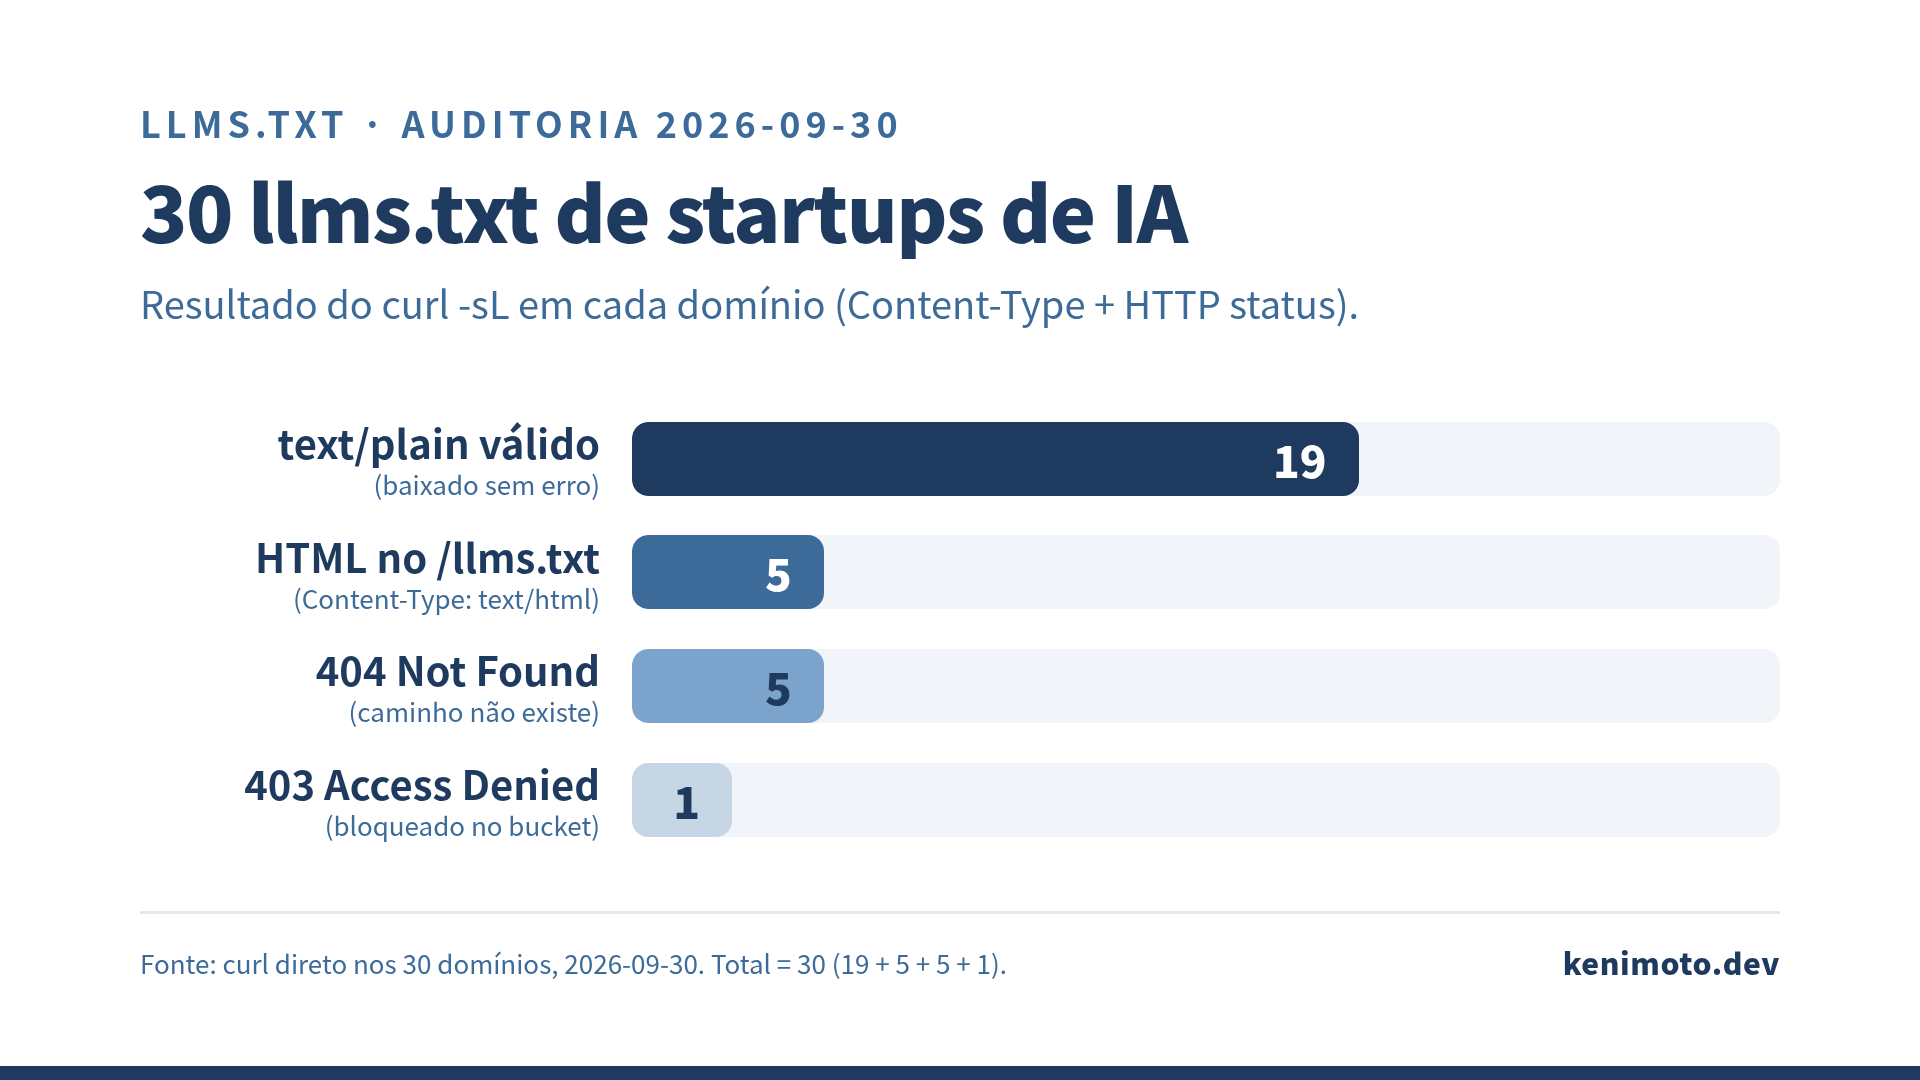
Rodei curl em cada domínio em 30 de setembro de 2026, por volta das 13h (horário do Japão). Anotei o HTTP status, o Content-Type, o tamanho, e depois li o conteúdo. 19 arquivos abriram como text/plain. 11 abriram como outra coisa. Cinco anti-padrões saltam da lista bruta. Todos eles descrevem comportamento observável no curl -o daquele dia, sem espaço para opinião. Como servidor muda, todos os números abaixo são de 30/09/2026; no fim do texto anoto o que mudou quando refiz o curl em 19/10/2026.
Como auditei
Escolhi 30 domínios com peso em ecossistema de IA em 2026 (mix de YC recentes e nomes estabelecidos como Cursor e Sourcegraph). Rodei:
curl -s -A "Mozilla/5.0 (audit)" --max-time 8 \
  -o "response-$domain.txt" \
  -w "HTTP=%{http_code}|CT=%{content_type}|SIZE=%{size_download}|EFF=%{url_effective}" \
  "https://$domain/llms.txt"
Os 13 domínios que responderam com redirect passaram por uma segunda rodada igual, com -L (segue redirect) e --max-time 12. O -w grava o status e o Content-Type real. Isso muda tudo: eu não precisei confiar em nenhuma declaração da empresa sobre “o llms.txt que a gente publicou”. Confiei no que o servidor devolveu.
Resultado bruto de 30/09/2026, sem interpretação:
- 19 arquivos vieram como
text/plain(variando de 448 bytes a 138.722 bytes) - 5 domínios devolveram HTML no path
/llms.txt(200 OK, masContent-Type: text/html) - 5 domínios devolveram 404
- 1 domínio devolveu 403 com XML de “Access Denied”
É uma lista fixa de 30 domínios rodada uma vez, sem pretensão de amostra estatística. Mesmo assim, os padrões se repetem.
Anti-padrão 1: HTML no lugar de text/plain
Cinco dos 30 sites devolveram uma página HTML no endereço /llms.txt. O servidor respondeu 200 OK, com o site inteiro renderizado.
| Domínio | Content-Type retornado | Tamanho |
|---|---|---|
| basehub.com | text/html | 321.780 bytes |
| poe.com | text/html | 87.920 bytes |
| windsurf.com | text/html | 67.028 bytes |
| layercode.com | text/html (redirect) | 473.148 bytes |
| codeium.com | text/html (redirect) | 67.028 bytes |
Tamanhos de 30/09/2026. Em 19/10/2026 os cinco ainda devolviam HTML; mudou o tamanho de dois: basehub.com caiu para 104.815 bytes e o layercode.com (ainda redirecionando para toyo.ai) para 183.930 bytes.
O caso mais estranho é o layercode.com: o /llms.txt redireciona para toyo.ai, um domínio de outra empresa. Presumo que a Layercode foi comprada ou renomeada. O codeium.com faz uma manobra parecida: redireciona para windsurf.com, que é o nome novo do produto. Os dois entregam a página inicial do site em vez de qualquer arquivo estruturado.
Um llms.txt é Markdown em texto plano. Quem pede esse arquivo e recebe a página inicial em HTML tem que adivinhar o que fazer com ela, e nada ali tem o formato de um llms.txt. É o 404 sem admitir que é 404.
Se você configurou uma URL /llms.txt no Next.js e ela cai no catch-all do App Router, o comportamento padrão é responder HTML. Verifique com curl -I o Content-Type real: o browser mascara isso porque renderiza qualquer coisa.
Anti-padrão 2: 404 silencioso (e um 403 educado)
Cinco domínios responderam 404 explícito:
continue.dev— 404 em HTML da própria homejulius.ai— 404 servindo 58KB da SPAsourcegraph.com— 404 em 10KB de HTMLreworkd.ai— 404 nowww.reworkd.ai/llms.txtdepois do redirectgrit.io— redireciona paradocs.grit.io/llms.txte 404 lá
E um sexto que merece nota separada: cedarcopilot.com devolveu 403 com um XML curtíssimo da AWS S3: <Error><Code>AccessDenied</Code>.... Ou seja, existe uma configuração de bucket que bloqueia leituras não autenticadas do /llms.txt. É a única coisa pior do que 404: 404 sinaliza “não temos”; 403 sinaliza “temos, mas é privado”. Nenhum dos dois casos é o que o crawler procura.
Seis domínios em 30 = 20% de “não temos, e nem sabemos que não temos”. Suspeito que a maioria já teve um llms.txt em algum momento (o SEO mensal recomendou), o arquivo migrou de pasta, e ninguém redirecionou. É o comportamento clássico do link quebrado dentro do próprio site.
A verificação leva quatro segundos:
curl -sI https://seusite.com/llms.txt | head -1
# HTTP/2 200  ← ok
# HTTP/2 404  ← problema
Coloque isso em cron uma vez por semana e você fica sabendo antes do crawler.
Anti-padrão 3: O despejo de 138KB
A spec original do Jeremy Howard descreve o arquivo como um índice: ele “stays small enough to fit in context”, e o detalhe fica atrás dos links, baixado só quando precisa.
Em 30/09, cactuscompute.com respondeu 138.722 bytes. O arquivo trazia a documentação inteira do produto Needle inline, com preços, instruções para agentes, especificações da API, tudo dentro do mesmo arquivo. Não havia nenhum link - [Nome](url) no formato canônico: só cabeçalhos e prosa.
(Atualização de 19/10/2026: a Cactus reescreveu o arquivo. Agora ele tem 27.521 bytes, se apresenta como “the index for agents” e aponta para páginas com links. O exemplo abaixo vale para o arquivo de setembro.)
A escolha faz sentido dependendo do que você quer que o LLM faça. Se a intenção é “dar todo o contexto de uma vez”, 138KB entra em qualquer janela moderna. Mas o llms.txt foi desenhado como índice, e um despejo desse tamanho muda essa premissa. Você paga com tokens toda vez que o crawler abre o arquivo, mesmo quando a pergunta do usuário toca só um pedacinho.
Outros gigantes do meu recorte (tamanhos de 30/09):
basehub.com(HTML) — 321KBpoe.com(HTML) — 87KBwindsurf.com(HTML) — 67KBmodal.com— 26KBbaseten.co— 24KBcursor.com— 22KB
Os três primeiros são HTML e caem no anti-padrão 1. Os últimos três estão em texto plano e são grandes, mas usam a estrutura de índice com links .md, o que deixa o LLM baixar só o que precisa. Se o índice cresce demais, uma saída é um llms.txt raiz enxuto que aponta para llms.txt por produto.
Anti-padrão 4: URL concatenada com bug
Este só aparece com o arquivo aberto. Estava lendo o cursor.com/llms.txt (22KB, 367 referências .md, no geral bem organizado) quando bati na linha 22:
- https://cursor.comhttps://cursor.com/changelog.mdSem espaço. Dois https://cursor.com colados. (Em 19/10/2026 o arquivo cresceu para 24.384 bytes e a mesma linha continuava lá, agora na linha 25.) É um bug de template: o gerador do arquivo concatenou base_url + full_url em vez de base_url + path. Quem tentar seguir esse link cai em nada (o domínio cursor.comhttps não resolve).
Um único link quebrado num arquivo grande não deveria ser fatal, mas revela algo pior: ninguém executou parser algum sobre esse arquivo antes de publicar. Existe parser pronto no NPM (llms-txt-parser, de terceiros); existe curl | grep -oE 'https?://[^ ]+' | xargs -I{} curl -sI -o /dev/null -w "%{http_code} {}\n" {} para bater todos os links em 30 segundos.
Se você monta o llms.txt num CI, coloque essa checagem no mesmo job que gera o site. Custa 30 segundos e evita alucinações induzidas: o LLM vai ver a URL malformada e inventar uma correção que soa plausível, talvez https://cursor.com/changelog.md, talvez outra coisa. Nenhuma é confiável.
Anti-padrão 5: Zero gêmeo .md
A proposta original inclui uma convenção esperta: qualquer URL com .md adicionado deve retornar uma versão Markdown limpa da página, sem nav, sem ads, sem bundle de JavaScript. É o padrão que faz llms.txt funcionar de verdade: o LLM abre o .md e vê só conteúdo.
Contei as ocorrências da string .md em cada um dos 19 arquivos válidos (contagem de 30/09):
| Grupo | Domínios | Ref. .md |
|---|---|---|
| Zero (8) | trigger.dev, wisprflow.ai, cactuscompute.com, supermemory.ai, onlook.com, val.town, morphik.ai, warp.dev | 0 |
| 1 a 6 (5) | firecrawl.dev (3), motherduck.com (1), modelscope.cn (5), browserbase.com (3), baseten.co (6) | 1–6 |
| 10 ou mais (6) | openrouter.ai (13), e2b.dev (19), greptile.com (55), braintrust.dev (65), modal.com (317), cursor.com (367) | 13–367 |
Oito arquivos válidos apontavam para zero URL .md. Servem links para páginas HTML, e se o conteúdo dessas páginas depende de JavaScript, o crawler fica sem ele: no levantamento da Vercel sobre crawlers de IA (dezembro de 2024), nenhum dos grandes crawlers de IA renderizava JavaScript.
(Em 19/10/2026, trigger.dev e supermemory.ai já traziam 5 referências .md cada; o grupo do zero caiu de oito para seis.)
O paper GEO de Aggarwal et al. (arXiv 2311.09735), publicado no SIGKDD 2024, mostrou que técnicas de otimização aumentam a visibilidade de uma fonte nas respostas geradas em até 40% na média, e em +115,1% no caso específico de sites na quinta posição da SERP usando o método “Cite Sources”. Esses ganhos partem de um conteúdo que o modelo consegue ler. Se o parser bate em HTML embaralhado e desiste, não sobra conteúdo para otimizar. A convenção .md existe justamente para desbloquear esse ponto.
O padrão maior por trás dos cinco
A impressão que a lista deixa: o arquivo é publicado uma vez e ninguém volta para conferir. Dos 30 domínios, 11 (pouco mais de um terço) não passaram no teste mais básico: status 200 com Content-Type: text/plain.
Se você mantém um llms.txt, coloque no seu monitor:
curl -Isemanal no/llms.txt— status 200 eContent-Type: text/plain- Parser em CI — quebra o build se algum link for malformado
- Contagem de links
.md— se está em zero, você está entregando HTML pro crawler - Tamanho abaixo de 10KB no raiz — se passar, divida em
llms.txtpor produto - Alerta se
.mdversionado sumir — o.mdsome quando o build muda de path
Mais material sobre llms.txt e o resto do LLMO está em llmoframework.com.
Refiz o curl nos mesmos 30 domínios em 19/10/2026: os 5 HTML, os 5 404 e o 403 continuavam iguais, e os 19 válidos seguiam válidos (o openrouter.ai passou a responder text/markdown). Vou refazer a auditoria completa no primeiro trimestre de 2027. Aposto uma cerveja que o número de HTML servido em /llms.txt aumenta em vez de cair. Adoção está ganhando a corrida; qualidade continua perdendo.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev · TabNews
 Livro relacionado LLMO Quickstart tutorial LLMO | Otimização para Busca por IA em 30 minutos · llms.txt · JSON-LD caminho mais curto Ver a página do livro →
Este artigo foi útil?