Blast Radius: 2 hops do PR cortam 49x no Claude
“A IA tem que ler o repo inteiro para revisar um PR” é a mentira cara que todo mundo compra. Eu paguei essa conta por meses sem perceber.
Depois descobri que 2 hops no grafo de código bastam para o Claude Code revisar com qualidade igual ou melhor, e a fatura de tokens caiu entre 8x e 49x dependendo do tamanho do repo. Esse post é o modelo mental e o stack mínimo: Tree-sitter + SQLite + MCP, mais ou menos 200 linhas de Python se você quiser escrever do zero.
Por que o repo inteiro é desperdício
O setup default de code review com IA pega o diff, abre o repo inteiro e manda tudo para o modelo. O resultado em qualquer base média:
- 80% dos tokens pagam por arquivos que o diff não tocou
- O agente lê
utils/format_date.tspela quadringentésima vez - A qualidade cai, porque o modelo se afoga em contexto irrelevante
RAG resolve? Em parte. Embeddings veem palavras parecidas, mas não sabem quem chama quem. Um UserService entra porque a query tinha “user”, enquanto o caller real passa batido porque chamou a função com uma variável u.
O problema é tratar o código como saco de texto. Código não é saco de texto. Código é grafo.
Blast radius: emprestado da segurança
Peguei o termo da segurança — ali é o raio de dano se um exploit cai. Em code review o conceito é: se eu mudar a função F, quais outras funções podem se comportar diferente?
Essa pergunta tem resposta exata. Em um grafo de chamadas é BFS reverso, hop por hop:
def blast_radius(graph, start, max_hops=2):
    visited = {start}
    frontier = {start}
    for hop in range(1, max_hops + 1):
        callers = set()
        for node in frontier:
            callers |= graph.callers_of(node) - visited
        if not callers:
            break
        visited |= callers
        frontier = callers
    return visited
Caminhe para trás a partir do diff. Pare no hop 2. Entregue para o agente só o conjunto que sobrou. É a ideia inteira.
Por que parar no hop 2 (e não 3)
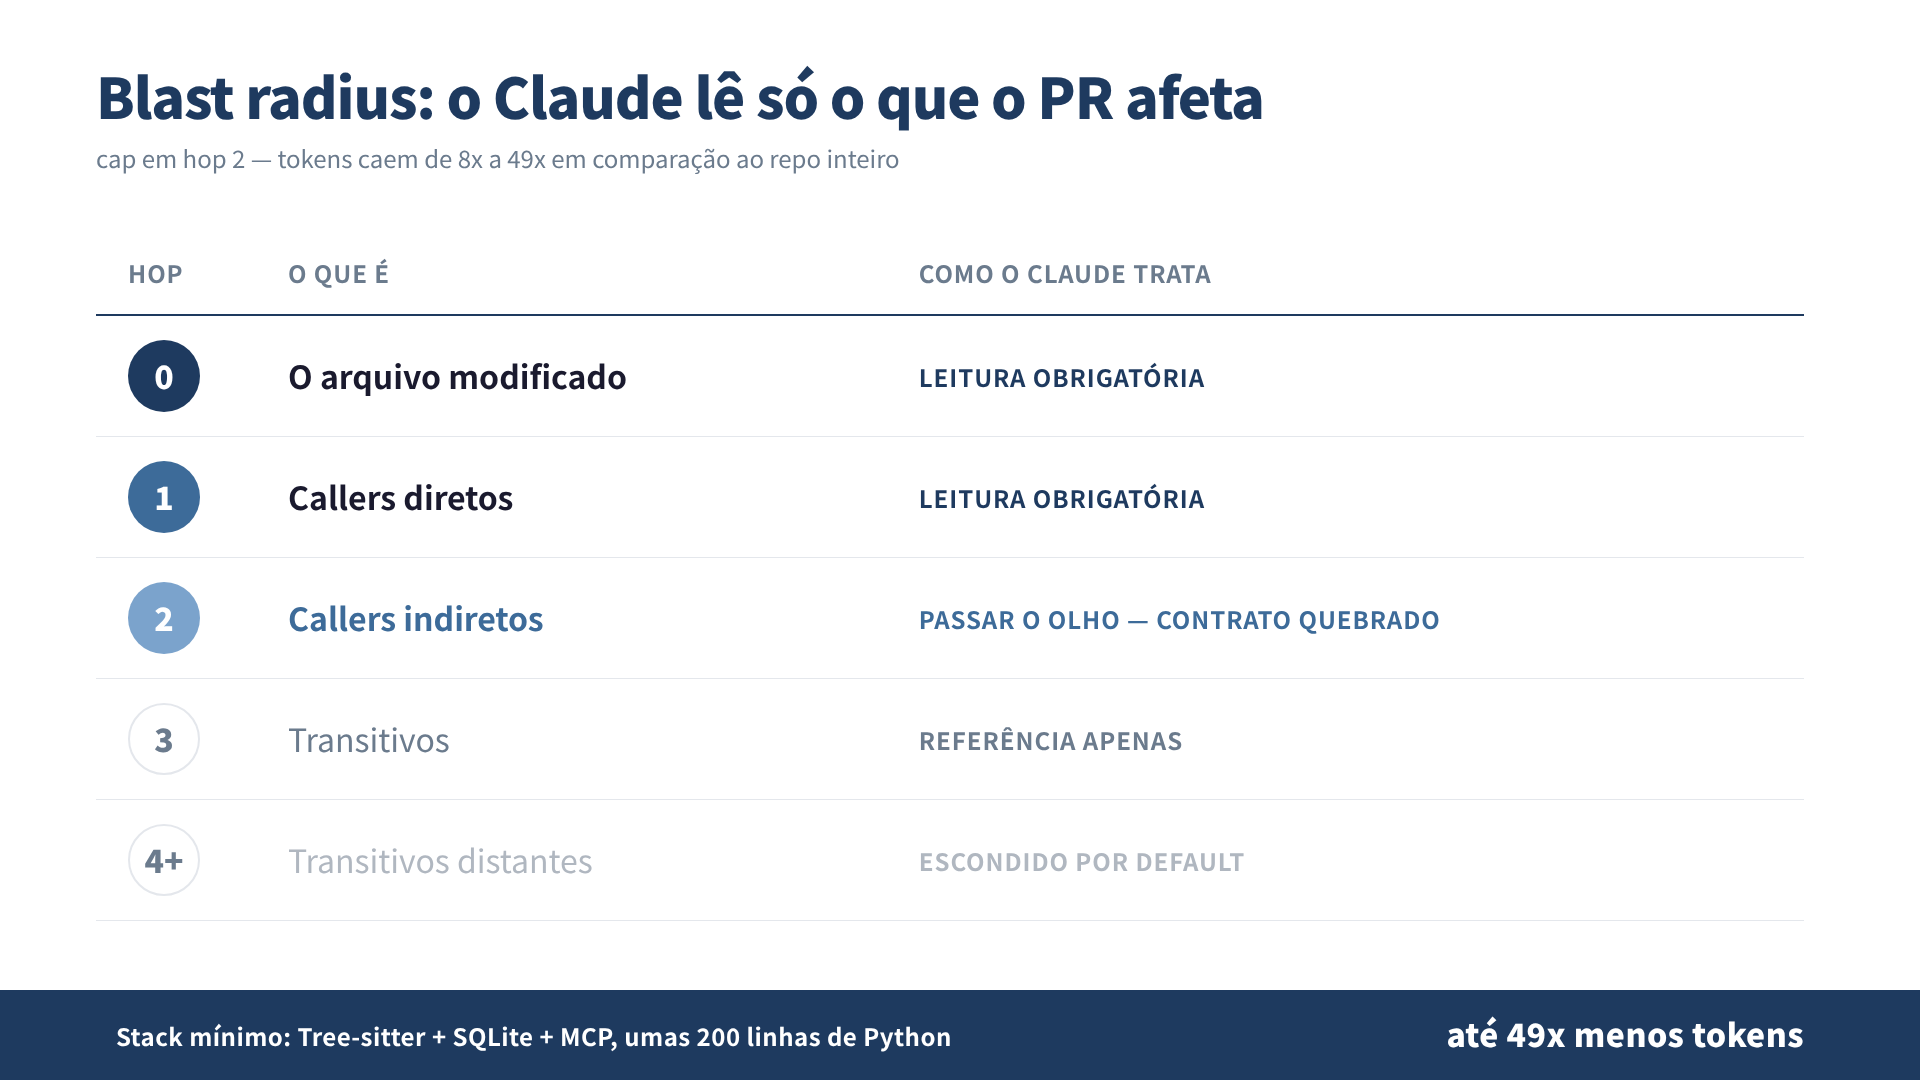
O cap em 2 não é arbitrário. É a linha onde sinal vira ruído em todo repo que eu medi.
| Hop | O que é | Como o Claude trata |
|---|---|---|
| 0 | O arquivo mudado | leitura obrigatória |
| 1 | Callers diretos | leitura obrigatória |
| 2 | Callers indiretos | passar o olho atrás de contrato quebrado |
| 3 | Mais longe | referência apenas |
| 4+ | Transitivo distante | escondido por default |
Com cap em hop 2 o agente lê de 10 a 50 nós num refactor típico. Deixa correr até hop 4 e você volta para 500 nós — ou seja, volta para o default caro.
O passo Tree-sitter em um parágrafo
Para ter o grafo você precisa parsear. Para parsear 12 linguagens sem escrever 12 parsers, Tree-sitter. Biblioteca: tree-sitter-languages no PyPI (ela empacota os grammars de Python, TypeScript, Go, Rust, Java, Ruby, C/C++ e mais). Os nós que importam são function_definition, call_expression, import_statement e os equivalentes de classe. Caminhe cada arquivo uma vez, emita nó para cada função e classe, emita aresta para cada chamada e import, guarde tudo em SQLite. Num projeto de 2.900 arquivos isso indexa em menos de 2 segundos e re-indexa incremental em cada save por hash do conteúdo. Esse é o custo de prep inteiro.
O MCP: expor o grafo como ferramenta do Claude
MCP (Model Context Protocol) é o jeito padrão de conectar o assistente de IA a ferramentas externas. Expor o grafo via MCP é o que faz a conta fechar.
pip install code-review-graph
code-review-graph build ./meu-projeto
code-review-graph install  # detecta Claude Code, Cursor, Windsurf
Daí dentro do Claude Code você pergunta em linguagem natural:
> Quais arquivos são afetados se eu mudar auth.py?

Chamada MCP: blast_radius("auth.py")

Hop 0: auth.py
Hop 1: middleware.py, api/login.py, api/register.py
Hop 2: tests/test_auth.py, tests/test_login.py
Hop 3: conftest.py                        (referência apenas)

Score de risco: 7,2/10 (alto)
Arquivos afetados: 7
Funções afetadas: 23
Dois segundos. Antes eu levava uns 30 minutos de grep para chegar na mesma lista, e sempre com a sensação de que tinha escapado alguma coisa. Dá aquela cara de bobo típica de quando a ferramenta certa aparece.
Os números
A referência pública do code-review-graph reporta 6,8x menos tokens em média em code reviews e até 49x em monorepos (fonte).
Meu antes e depois num repo médio bate com isso:
Antes:  diff + 50 arquivos "por garantia" = 150.000 tokens
Depois: diff + 7 arquivos do blast radius =  18.000 tokens

Redução: 8,3x
Em monorepo gigante o antes passa de 500k tokens só para abrir — e ali o 49x faz sentido. Em projeto pequeno o antes é 30k e o depois é 20k; 1,5x. Ainda vale, mas o headline fica mais modesto.
As 3 armadilhas que matam a economia
Vi três erros comuns quando o pessoal implementa.
1. Hop sem limite “só para garantir”
Se você deixa o agente seguir até hop 5 “por via das dúvidas”, volta para a estaca zero — o default caro de “o repo inteiro de novo”. Hop 2 é teto, não sugestão. Hop 3+ fica como referência opcional, não entra no prompt.
2. Ignorar grafo de dados
Grafo de chamadas pega quem chama quem. Mas se auth.py escreve numa tabela que outro módulo lê, não aparece como caller. Precisa de uma aresta extra: shared state. O code-review-graph cobre isso com semantic_search + flow_trace, mas se você está rolando a própria versão, essa aresta tem que entrar manual.
3. Não re-indexar incremental
Se re-indexa o repo inteiro em todo save, você come o ganho em CPU. Hash por arquivo, diff do grafo, patch no SQLite. O overhead vira milissegundos.
Como construir sem comprar
Se você não quer instalar o pacote inteiro, o stack mínimo é:
pip install tree-sitter-languages- Walk em cada
.py/.ts/.go/ etc, pegandofunction_definitionecall_expression - Grafo direcional em
networkx— ou SQLite com duas tabelas (nodes,edges) se o repo passa de 10 mil arquivos - BFS reverso com
max_hops=2 - Expor como MCP server — 10 a 15 linhas com o SDK oficial da Anthropic
200 a 300 linhas de Python no total. Testei em projeto de 2.900 arquivos: indexa em uns 2 segundos, consulta em uns 50ms.
O que isso não resolve
Blast radius não detecta bug lógico. Ele só diz “esses arquivos podem ser afetados”. A IA revisa esses N arquivos — se a mudança quebra contrato com algum caller, ela acha. Mas se o bug está na lógica dentro do próprio diff, blast radius não ajuda.
Também não resolve mudança em config, env ou schema. Essas afetam coisa que não aparece em call graph. Trate separado, com um conjunto de regras próprio.
Resumindo
- Code review de IA default é bulk loading disfarçado de “context engineering”
- Blast radius com cap em hop 2 corta de 8x a 49x os tokens em troca de qualidade igual ou melhor
- Tree-sitter + SQLite + MCP é o stack mínimo, umas 200 linhas de Python
code-review-graphcomo pacote pronto, se você não quiser escrever do zero- Hop 3+ fica como referência opcional, não entra no prompt do agente
Para mais contexto sobre o lado knowledge graph + MCP, esse post sobre MCP + KG custou 8x menos tokens que tudo que tentei antes.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev · TabNews
 Livro relacionado Manual completo de Knowledge Graph Manual completo de Knowledge Graph | GraphRAG · Neo4j · RDF · Tree-sitter · revisão de código por IA Ver a página do livro →
Este artigo foi útil?