GraphRAG em produção: 3 paredes depois do POC
GraphRAG virou a resposta curta para “o RAG clássico está fraco, e agora”. Aponta grafo, cita o paper da Microsoft Research de fevereiro de 2024, encerra reunião. No POC, dentro de 100 páginas de doc interno, a demonstração realmente impressiona: a resposta junta informação que a busca vetorial ignorava.
E aí você passa para produção corporativa. É onde eu vi engenheiros bons travarem em três lugares específicos. Não é o grafo que está errado. Nenhuma dessas três paredes aparece no tutorial de “GraphRAG com 100 páginas de PDF”, porque elas só existem no formato em que empresa de verdade usa documento: muita gente, muito departamento, muita versão.
Este post destrincha as três paredes com fonte: documentação oficial do Microsoft GraphRAG, paper do LinkedIn (arxiv 2404.17723) e dois capítulos de livros meus que já tratam o tema em profundidade. Eu não implementei GraphRAG em cliente corporativo brasileiro, então o que vai aparecer aqui é leitura de material público e dos livros, não “o case que fiz”. Prefiro ser honesto sobre o que é dado e o que é interpretação.
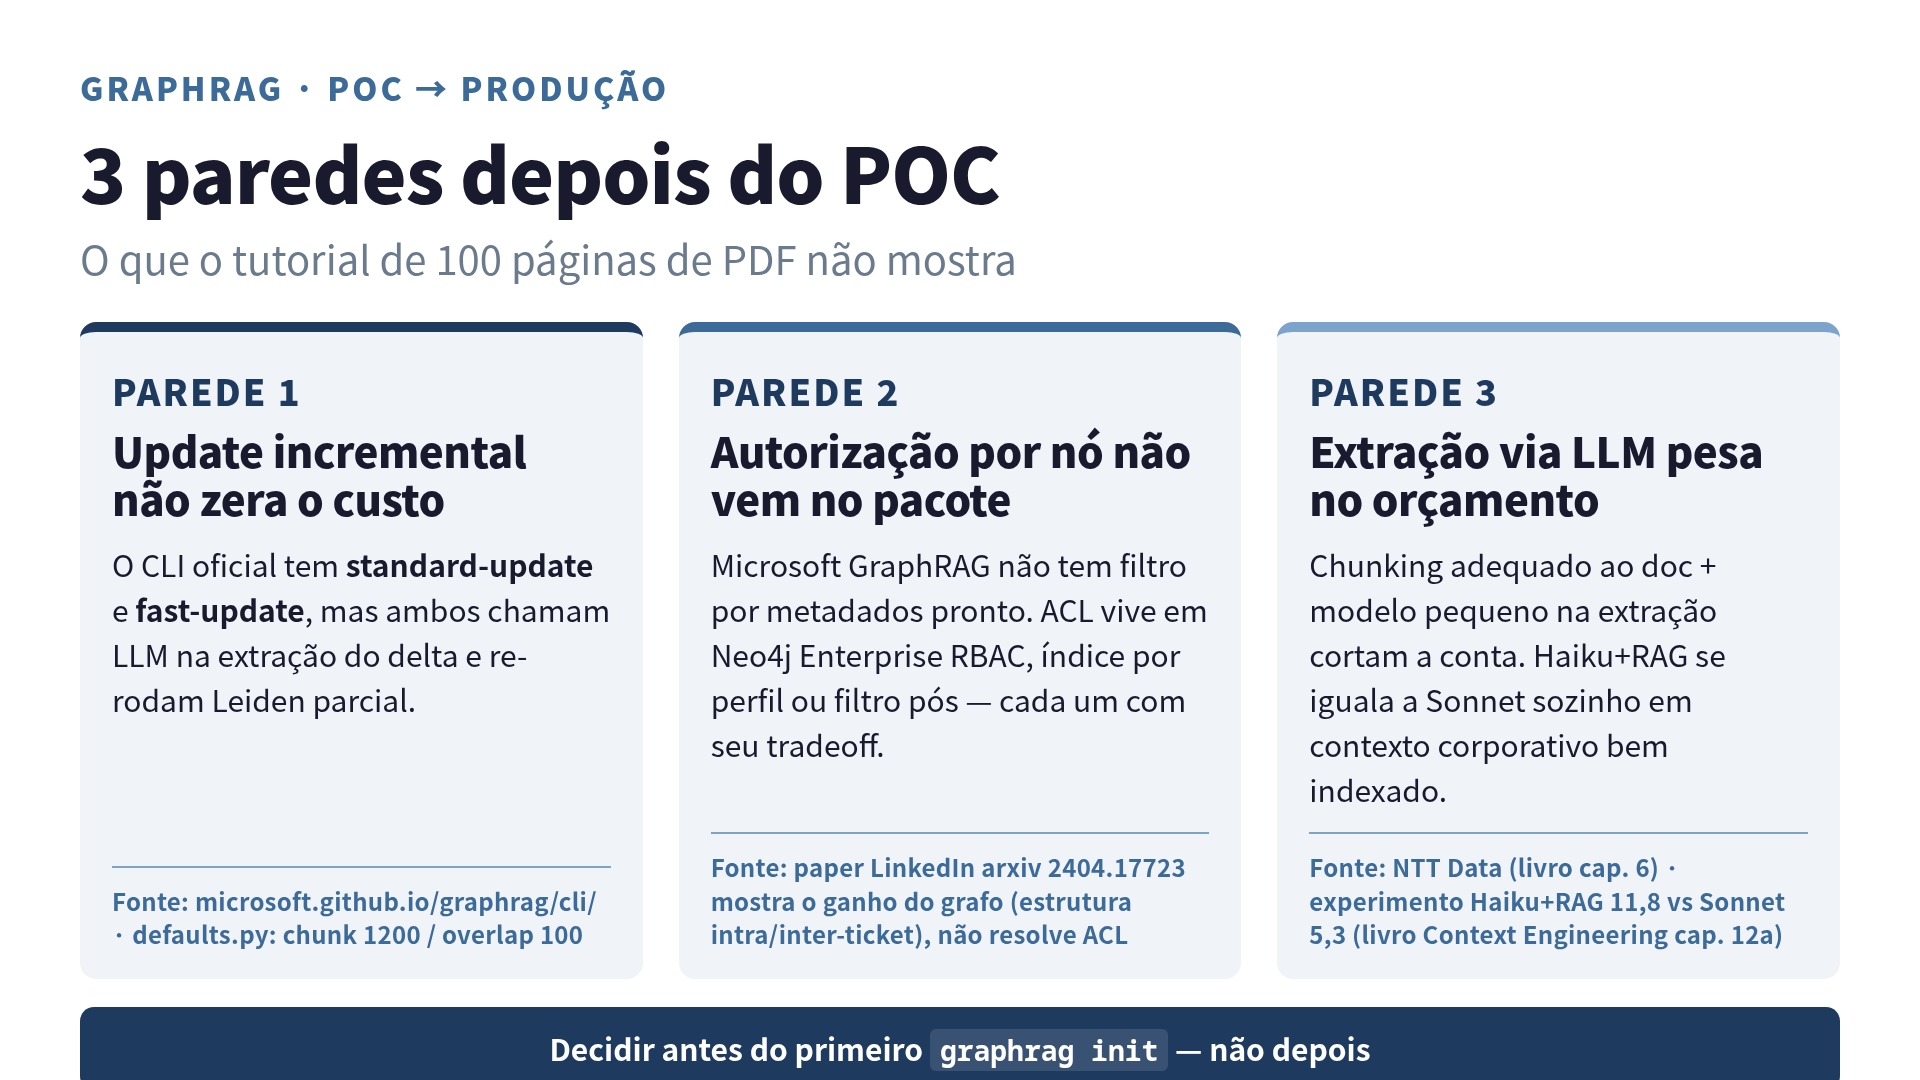
Parede 1: update incremental existe, mas não zera o custo
Primeira coisa que cai no POC: “e quando o documento muda, a gente reconstrói o grafo todo?”. A resposta antiga era sim. A resposta de hoje é “não, mas quase”.
O CLI oficial do Microsoft GraphRAG tem o comando update desde a v0.4.1 (docs oficiais). Os métodos são standard, fast, standard-update e fast-update. O resultado é escrito numa pasta update_output separada e aplicado por cima do índice existente, sem reconstruir tudo.
Até aí, bom. O ponto que o POC esconde é o que o update ainda roda em cada deltinha:
- Extração de entidade e relação por chamada de LLM nos chunks novos ou alterados. Chunk default é 1200 tokens com overlap de 100 (fonte:
defaults.pyno repo oficial). - Re-clusterização Leiden parcial, porque mudança de nó pode mover a vizinhança de comunidade.
- Regeneração dos resumos de comunidade afetados.
O fast-update pula etapas pesadas e sacrifica profundidade da reindexação. O standard-update mantém qualidade mas custa quase proporcional ao delta.
Em corpora com rotatividade alta — contrato que muda semana sim semana não, wiki com commits diários — o custo de API acumulado em um ano pode superar o da reconstrução inicial. A promessa “sem reconstrução total” é verdadeira. A promessa implícita “sem custo recorrente” não é.
A pergunta certa de arquitetura, portanto, é outra: “qual é a frequência de mudança do corpus, e esse custo de API cabe no orçamento mensal?”. Para doc estável (manual de produto, base jurídica consolidada), cabe. Para doc vivo (ticket, email, chat corporativo), raramente cabe sem camada de triagem antes do pipeline de ingestão.
Parede 2: autorização por nó não vem no pacote
Segunda parede: controle de acesso. Em RAG vetorial com Amazon Bedrock Knowledge Bases, o filtro por metadados é parte do produto — department, security_level, region. A query de recuperação já respeita o nível do usuário logado.
No GraphRAG oficial da Microsoft, isso não existe pronto. A implementação de referência cobre o pipeline de construção do grafo e a busca por resumo de comunidade. ACL por nó, por aresta ou por subgrafo fica na camada de infraestrutura abaixo, fora do escopo do GraphRAG.
As opções reais são três, cada uma com tradeoff próprio:
- Neo4j Enterprise com RBAC fine-grained. O Neo4j traz permissões em nível de nó, aresta e propriedade a partir da versão Enterprise. É sólido, mas é camada paga e exige modelagem de role antes de ingerir qualquer dado.
- Index por tenant / por nível de autorização. Em vez de um grafo com ACL, N grafos — um para cada perfil. Simples de implementar, caro para manter: o custo da parede 1 se multiplica por N.
- Filtro em pós-processamento. Monta um grafo único, recupera subgrafo, aplica filtro no cliente. Vaza metadado através dos resumos de comunidade, que podem citar entidade que o usuário não deveria ver.
O paper do LinkedIn (arxiv 2404.17723, “Retrieval-Augmented Generation with Knowledge Graphs for Customer Service Question Answering”) aponta um ganho que vem de outra direção. A mediana do tempo de resolução de ticket caiu 28,6% e o MRR melhorou 77,6%. A atribuição do próprio paper é literal: a abordagem preserva a estrutura intra-ticket e as relações inter-ticket que o RAG baseado em texto perde no segmento de chunks. O ganho não vem de ACL, vem de preservar a forma estrutural do ticket (sintoma, passos de resolução, FAQ relacionada) e a relação com tickets similares, dando ao LLM contexto que o RAG puro não tinha.
O ganho do grafo e o problema da autorização são eixos diferentes. É possível construir o GraphRAG inteiro e, no final, descobrir que a camada de ACL em cima dele vai custar o mesmo que o resto.
Parede 3: a conta de LLM na extração não some, mesmo com modelo pequeno
A terceira parede é a mais citada e também a mais mal mapeada. Todo mundo sabe que GraphRAG custa mais que RAG puro. Pouco time projeta onde esse custo vai parar.
O livro do Knowledge Graph, no capítulo 6, descreve o caso de avaliação de risco contratual da NTT Data e, logo depois, aponta o custo de chamadas de API na fase de construção como problema notável da adoção corporativa. Processar dez mil páginas de documento interno pode gerar custo de API na casa das dezenas de milhares de ienes só na construção inicial — e isso é extração, antes de qualquer query de usuário.
Dois ingredientes evitam que esse custo detone o projeto, e os dois precisam estar no desenho desde o começo:
Primeiro, chunking que respeita a estrutura do doc. O padrão do GraphRAG oficial é 1200 tokens com overlap de 100. Para manual técnico com fronteira de seção clara, sobe-se para preservar bloco. Para email ou chat, desce. Rodar com o padrão sem olhar o doc significa pagar extração em pedaços que nem precisavam ser separados.
Segundo, modelo de extração não precisa ser premium. O experimento do livro de Context Engineering (capítulo 12a) mostra que, em configuração corporativa bem indexada, Haiku com RAG se iguala a Sonnet sozinho na avaliação de qualidade de resposta (11,8 contra 5,3 numa pontuação composta de quatro eixos: precisão factual, resistência a alucinação, especificidade e honestidade). Número pequeno, mas o padrão bate com relatos públicos: no contexto corporativo, boa indexação compensa modelo menor numa faixa larga. Para a extração de entidade do GraphRAG, isso quer dizer que rodar com Haiku na ingestão corta boa parte do custo da parede 3 sem comprometer o grafo.
Combinando as duas alavancas — chunking adequado ao tipo de doc + modelo pequeno na extração —, o custo de construção cai bastante contra uma implementação ingênua. Não some. Mas vira ordem de grandeza aceitável.
O que isso muda na decisão de arquitetura
Depois dessas três paredes, a pergunta de projeto deixa de ser “GraphRAG ou não?”. Vira uma lista de checagem antes do primeiro graphrag init:
- Rotatividade do corpus: documentos mudam diariamente, semanalmente ou raramente? Diariamente, o custo de
updateprecisa estar no orçamento mensal — não só o inicial. - Modelo de autorização: cada usuário vê tudo, ou cada perfil tem recorte? Se tem recorte, a decisão de ACL (Neo4j Enterprise vs índice por perfil vs filtro pós) precisa estar antes do pipeline.
- Volume e tipo de doc: dez mil páginas de manual técnico tem comportamento diferente de dez mil threads de email. Chunk e modelo de extração mudam.
Se as três respostas estão no quadro antes do POC, a travessia do POC para produção vira engenharia. Se estão depois, vira projeto que atrasa.
O resumo honesto
GraphRAG serve para uma forma específica de problema: pergunta que atravessa documento, corpus onde a estrutura entre entidades é a resposta. Chamar de “próxima geração do RAG” é vender errado. Para esse recorte, o paper do LinkedIn (28,6% a menos no tempo mediano de resolução, atribuído explicitamente à preservação da estrutura intra e inter-ticket) e os casos dos livros são evidência real.
A parte que o POC esconde está na operação de todo dia, não na mecânica do grafo em si: atualização incremental que ainda chama LLM, autorização que não vem no pacote, extração que precisa de desenho para não estourar o orçamento.
Três paredes concretas. Reconhecíveis antes de qualquer linha de código, se a gente olhar o POC com dois olhos — um para a resposta impressionante que ele dá hoje, outro para a conta que ele vai gerar amanhã.
A versão aprofundada deste tema está no meu livro Manual completo de Knowledge Graph, que trata de RDF vs Property Graph, GraphRAG na empresa e os casos de NTT Data / LinkedIn em detalhe. O capítulo 12a do livro de Context Engineering traz o experimento Haiku+RAG citado aqui.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev · TabNews
 Livro relacionado Manual completo de Knowledge Graph Manual completo de Knowledge Graph | GraphRAG · Neo4j · RDF · Tree-sitter · revisão de código por IA Ver a página do livro →
Este artigo foi útil?