Context Engineering: RAG é 80%, Full CE só +12%
Rodei a bateria inteira de Engenharia de Contexto do meu livro em PT-BR, do zero contexto até o “Full CE”. Quando cheguei na última comparação — passar de RAG para Full Context Engineering — o número me parou: no Sonnet 4 o salto foi de só +12%, e no Haiku 3 o Full CE regrediu -14% em relação ao RAG puro.
A lição do capítulo é desconfortável para quem acabou de montar um pipeline cheio de “melhorias”: o RAG responde por cerca de 80% do ganho total de Context Engineering. O resto é margem fina, e às vezes negativa.
Este post é a leitura honesta desses números, incluindo o que exatamente foi medido como “Full CE” na minha bateria (não é o mesmo que a definição de produção que descrevo no capítulo).
O número que não bate com a propaganda
A bateria passa por cinco estágios cumulativos: Zero Context, System Prompt, Few-shot, RAG, Full CE. O ponto onde o gráfico sobe de verdade é o salto para RAG. Depois disso o retorno diminui — às vezes inverte.
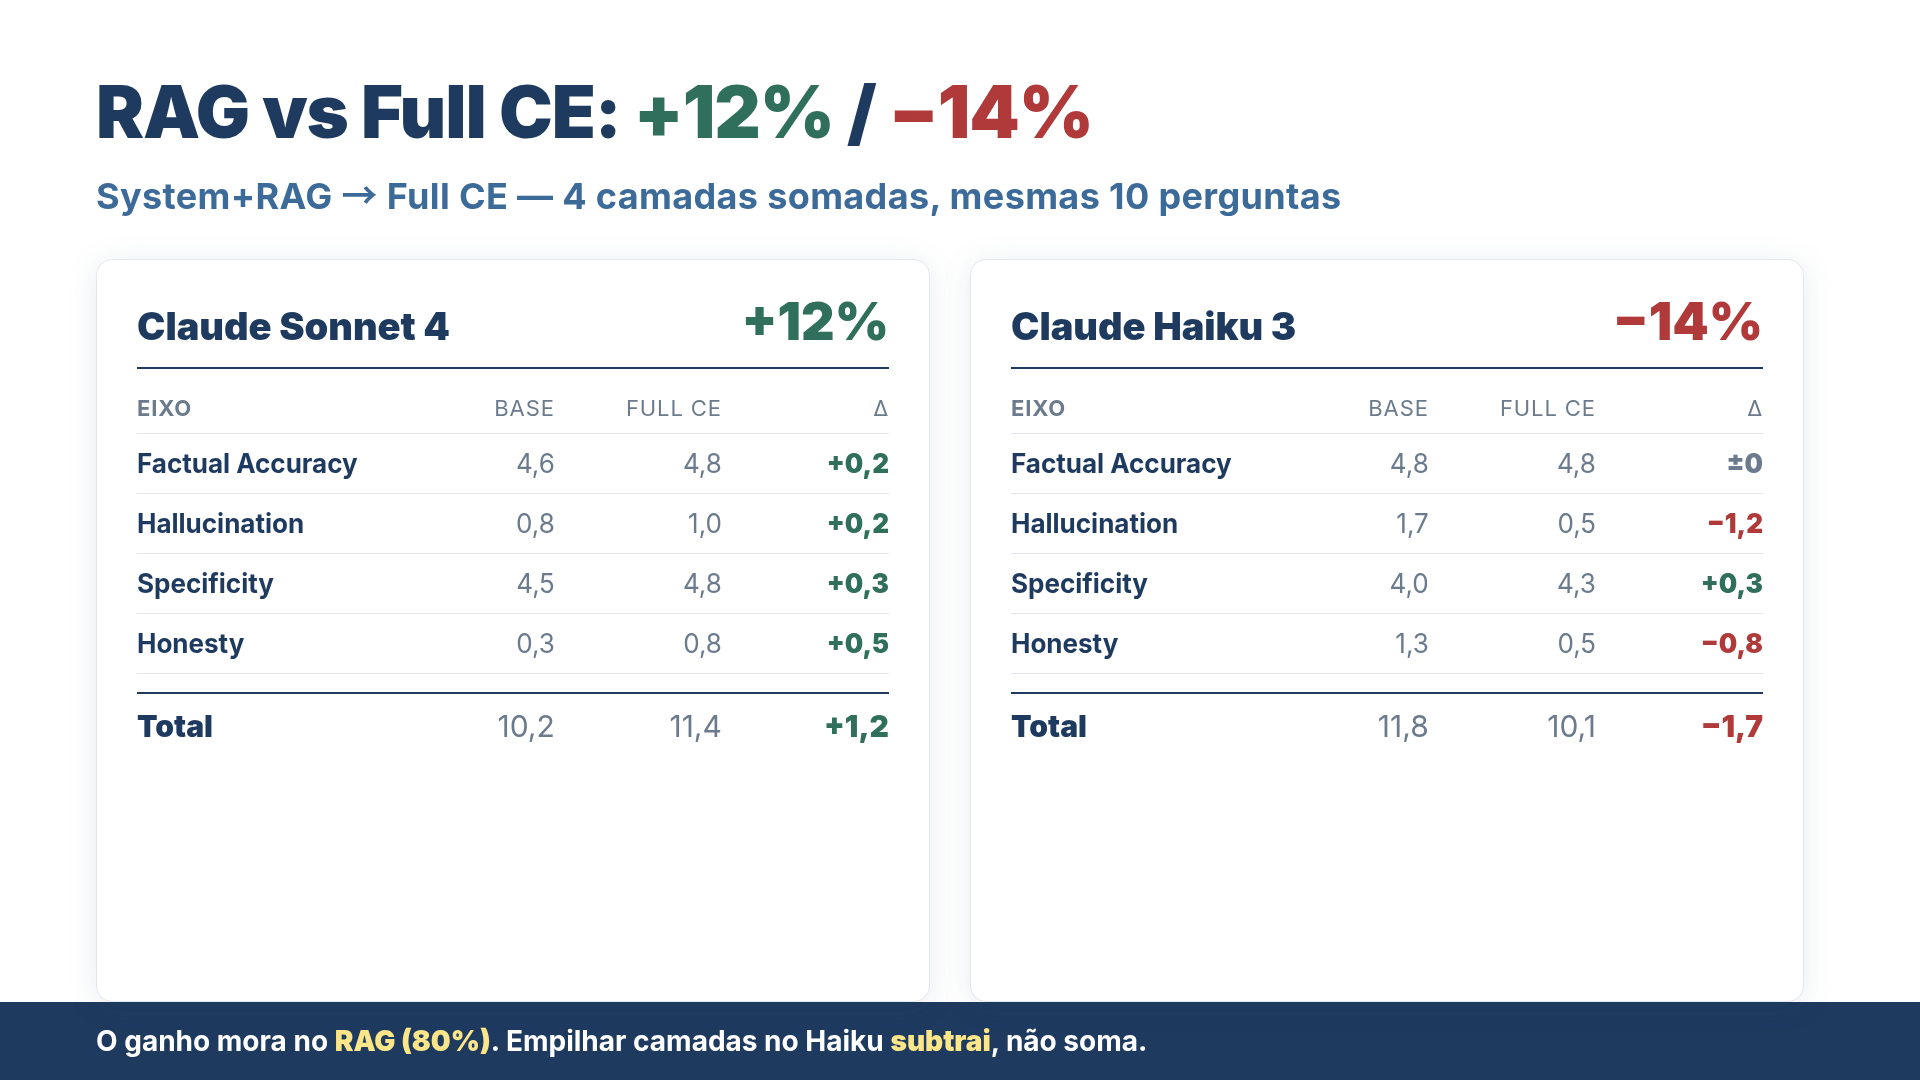
Os totais crus, direto da planilha do experimento:
| Modelo | System + RAG | Full CE | Delta | Em % |
|---|---|---|---|---|
| Claude Sonnet 4 | 10,2 | 11,4 | +1,2 | +12% |
| Claude Haiku 3 | 11,8 | 10,1 | -1,7 | -14% |
Compare com o salto anterior, de System Prompt para RAG:
- Sonnet: 8,8 → 10,2, +16% (+1,4 pontos)
- Haiku: 3,7 → 11,8, +219% (+8,1 pontos)
A diferença de ordem de grandeza não é opinião, é a planilha. O RAG puxou o Haiku de 3,7 para 11,8 — mais que triplicou. O que veio depois somou pouco no Sonnet e tirou pontos do Haiku.
O que foi medido como “Full CE”
Antes de interpretar, uma honestidade importante: no capítulo do livro eu descrevo Engenharia de Contexto Completa como um conjunto maior de técnicas de produção (recuperação seletiva, compressão de contexto, layout hierárquico, seleção dinâmica, gestão de memória, estruturação de saída de ferramentas). A bateria não implementou tudo isso. O harness do experimento mediu a camada que dá para ligar sem reescrever a arquitetura:
- O mesmo RAG top-3 do estágio anterior.
- Um System Prompt mais estrito (regras explícitas de “não invente ferramenta”, “não responda além do contexto recuperado”).
- Instrução de saída estruturada no prompt (seções fixas: resposta / justificativa citando as fontes RAG / nível de confiança / áreas sem informação).
- Marcação explícita de hierarquia no contexto (PRIMARY / SUPPORTING / BACKGROUND antes dos chunks).
É isso que, no meu benchmark, carrega o rótulo “Full CE”. A definição mais ampla de produção fica no livro — e seria um experimento separado para ser medida com honestidade.
Com esse disclaimer no ar, dá para olhar o breakdown por eixo sem fingir que o resultado prova algo que ele não prova.
O breakdown por eixo: Sonnet ganha agulha, Haiku perde martelo
O que mudou dentro do delta +1,2 do Sonnet 4:
| Eixo (0–5) | System + RAG | Full CE | Delta |
|---|---|---|---|
| Factual Accuracy | 4,6 | 4,8 | +0,2 |
| Hallucination (maior = melhor) | 0,8 | 1,0 | +0,2 |
| Specificity | 4,5 | 4,8 | +0,3 |
| Honesty | 0,3 | 0,8 | +0,5 |
| Total | 10,2 | 11,4 | +1,2 |
O ganho mais vistoso é em Honesty: o Sonnet, quando forçado a abrir seções de “confiança” e “áreas sem informação”, começa a admitir ignorância em vez de inventar. Factual Accuracy e Hallucination andam juntos: o Sonnet já estava bom, a camada extra deu polimento.
Agora o Haiku 3, no mesmo estágio:
| Eixo (0–5) | System + RAG | Full CE | Delta |
|---|---|---|---|
| Factual Accuracy | 4,8 | 4,8 | 0 |
| Hallucination (maior = melhor) | 1,7 | 0,5 | -1,2 |
| Specificity | 4,0 | 4,3 | +0,3 |
| Honesty | 1,3 | 0,5 | -0,8 |
| Total | 11,8 | 10,1 | -1,7 |
O Haiku não ficou mais burro — ele ficou mais confiante. Hallucination caiu de 1,7 para 0,5 (traduzindo: alucina muito mais). Honesty caiu de 1,3 para 0,5 (traduzindo: deixa de dizer “não sei”). As camadas extras viraram ruído para o modelo pequeno.
Por que o Haiku piora quando o Sonnet melhora
A hipótese que o próprio capítulo do livro levanta, e que o experimento sustenta: modelos pequenos têm orçamento de atenção menor dentro da janela de contexto. Adicionar instruções estruturadas sobre o RAG dispersa a atenção da informação que o RAG trouxe.
Olhando o prompt do estágio Full CE, dá para contar o que está disputando atenção:
- As regras estritas do System Prompt (não invente, não extrapole, cite as fontes).
- A marcação de hierarquia (PRIMARY / SUPPORTING / BACKGROUND).
- Os chunks recuperados pelo RAG.
- O template de saída estruturada (seções obrigatórias).
- A pergunta do usuário.
Sonnet 4 tem folga para processar os cinco. Haiku 3 escolhe mal onde gastar atenção: ele passa a satisfazer o formato de saída antes de verificar se tem base factual para responder. Resultado: entrega resposta em todas as seções, inclusive naquelas em que deveria admitir ignorância.
É o mesmo padrão que descrevi em Haiku 3 + RAG (11,8) venceu Sonnet 4 puro (5,3) e em Haiku + Qwen 4B vencem Opus (14,47), só que invertido: aquele post mostra onde o modelo pequeno dá luz; este mostra onde ele apaga. O ponto de ruptura é a densidade do prompt, não o tamanho do modelo em si.
O que mudar segunda-feira de manhã
Se você está em Sonnet 4 com RAG decente e pensa em “ligar o resto do Context Engineering”, três decisões:
Primeira: +12% é real, mas não é +80%. Faça a conta de ROI antes de reescrever o pipeline. +12% de qualidade compensa reescrever 400 linhas de orquestração? Em alguns produtos sim; em outros, não. A mesma +12% em dólar de API gasto pode ser maior que o ganho de UX.
Segunda: comece pelo que mexe menos no sistema. No meu benchmark, as duas peças que mais puxaram o Sonnet para cima foram a instrução de saída estruturada (seções obrigatórias) e o System Prompt mais estrito. Nenhuma das duas precisa de infra nova — são linhas no prompt. Rodou e passou de 10,2 para 11,4? Siga. Rodou e ficou igual? Pare aqui.
Terceira: se você está em Haiku 3 (ou qualquer modelo pequeno de 2024-2025), pare no RAG. O capítulo do livro é explícito nesse ponto e a bateria confirma: somar camada estruturada ao RAG derrete Hallucination e Honesty do modelo pequeno. Rode as 20 perguntas antes de aceitar que o seu caso é diferente.
Como medir no seu produto, em uma tarde:
- Pegue 20 perguntas reais de produção (não invente).
- Rode cada uma com o seu RAG atual. Guarde a resposta.
- Rode as mesmas 20 com RAG + System Prompt estrito + saída estruturada (4 seções: resposta, justificativa com fontes, confiança, áreas sem informação).
- Um humano avalia às cegas em quatro eixos (Factual Accuracy, Hallucination invertido, Specificity, Honesty), 0 a 5 cada.
- Se o total subir, você está no caso Sonnet. Se cair, você está no caso Haiku — e acabou de economizar o trabalho de reescrever a arquitetura.
A bateria do livro usou Claude Sonnet 4 e Claude Haiku 3 com os preços de 2026. O seu produto pode estar num modelo intermediário onde a curva vira em outro ponto. A única forma de saber é medir — e três horas de bateria pagam bem.
Resumo
- RAG responde por cerca de 80% do ganho de Engenharia de Contexto. O resto é margem fina, não revolução.
- “Full CE” no meu benchmark = RAG + System Prompt estrito + saída estruturada + marcação de hierarquia. Não é o conjunto maior de 6 técnicas de produção que o capítulo descreve; é o subset ligável sem reescrever a arquitetura.
- No Sonnet 4, Full CE melhora 10,2 → 11,4 (+12%). Honesty é quem mais sobe (+0,5).
- No Haiku 3, Full CE regride 11,8 → 10,1 (-14%). Hallucination derrete (-1,2) e Honesty também (-0,8): o modelo pequeno satisfaz o formato antes de verificar o fato.
- Modelo grande ganha agulha com camada extra; modelo pequeno perde martelo. O ponto de ruptura é a densidade do prompt.
- Antes de ligar Full CE, rode 20 perguntas reais com e sem a camada estruturada. Três horas de bateria evitam semanas de reescrita.
Leituras relacionadas
- Haiku 3 + RAG (11,8) venceu Sonnet 4 puro (5,3) — o salto que vale 80% do efeito, medido no mesmo harness
- O modelo barato + RAG bateu o caro em 223% — a conta de preço que fecha o argumento
- Construí o RAG que mandaram fazer, depois deletei tudo: o grep venceu — o outro lado, onde até o RAG é overkill
- Context Engineering: por que trocar o prompt não resolve — a entrada da série, antes dos benchmarks
Se você quiser o experimento inteiro reproduzível (bateria, scripts, planilhas e os cinco estágios além do que coube neste post), o livro Transformando LLMs de Mentirosos em Especialistas: Engenharia de Contexto na Prática tem o apêndice B com o passo a passo. Mas rode as 20 perguntas primeiro — o livro só faz sentido depois que o seu próprio número bater.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev · TabNews
 Livro relacionado Transformando LLMs de Mentirosos em Especialistas Engenharia de Contexto na Prática | RAG · MCP · CLAUDE.md · Agentic RAG, com benchmarks de ponta a ponta Ver a página do livro →
Este artigo foi útil?