RTX 4070 + Qwen 9B: 187W, 0,68 Wh de energia
A thread no TabNews toda semana é a mesma: “trocar Sonnet por Qwen local resolve o bill”. Eu já concordo em termos de dólar. Mas ninguém mede quantos watts isso puxa, e eu também não media — até ter uma RTX 4070 ligada o dia inteiro e começar a desconfiar da minha própria conta de luz.
Então liguei o nvidia-smi no modo polling e gerei 1.500 tokens com Qwen 9B via Ollama, só para ver o número. Duas rodadas: 73,6 tok/s a 187,5W de média de GPU na primeira, 74,4 tok/s a 183,0W na segunda. Isso dá 0,708 Wh por mil tokens na run 1 e 0,683 Wh por mil tokens na run 2 — e esse é o número que me interessa, porque é com ele que você compara “a conta vai cair” com “a conta vai subir”.
O setup, para você poder me chamar de errado
Máquina é uma RTX 4070 de 12 GB montada numa torre que roda só isso (não é um laptop com GPU ligada em DisplayLink puxando outra coisa). O ocioso da placa é 9,3W antes de qualquer ollama run. O modelo é Qwen 3.5:9b servido pelo Ollama local, temperature: 0, think desligado, 1.500 tokens gerados por rodada. Isso está tudo no experimento 045 com os CSVs crus.
Para medir, rodei nvidia-smi -lms 500 em paralelo (uma amostra a cada 500 ms) e peguei a média de power.draw só nas amostras em que utilization.gpu > 20%. Isso tira os primeiros 100 ms de startup e as caudas de resfriamento, que são os dois lugares onde a conta mente para baixo.
Aviso importante antes de alguém me trollar nos comentários: o número é só a GPU, não é a tomada. CPU, DRAM, fan curve, perda do PSU (RTX 4070 em sistema modesto costuma rodar a ~85% de eficiência de fonte) não entram. O número real na parede é maior. Mas é o maior componente isolado — a GPU puxa 95% do delta quando o modelo está gerando, então para efeito de “a ordem de grandeza bate” essa medição aguenta.
O resultado
| modelo | tok/s | GPU média | J/token | Wh / 1k tokens |
|---|---|---|---|---|
| qwen3.5:9b (run 1) | 73,6 | 187,5W | 2,55 | 0,708 |
| qwen3.5:9b (run 2) | 74,4 | 183,0W | 2,46 | 0,683 |
| qwen3.5:35b-a3b | 10,2 | 21,6W | — | inválido |
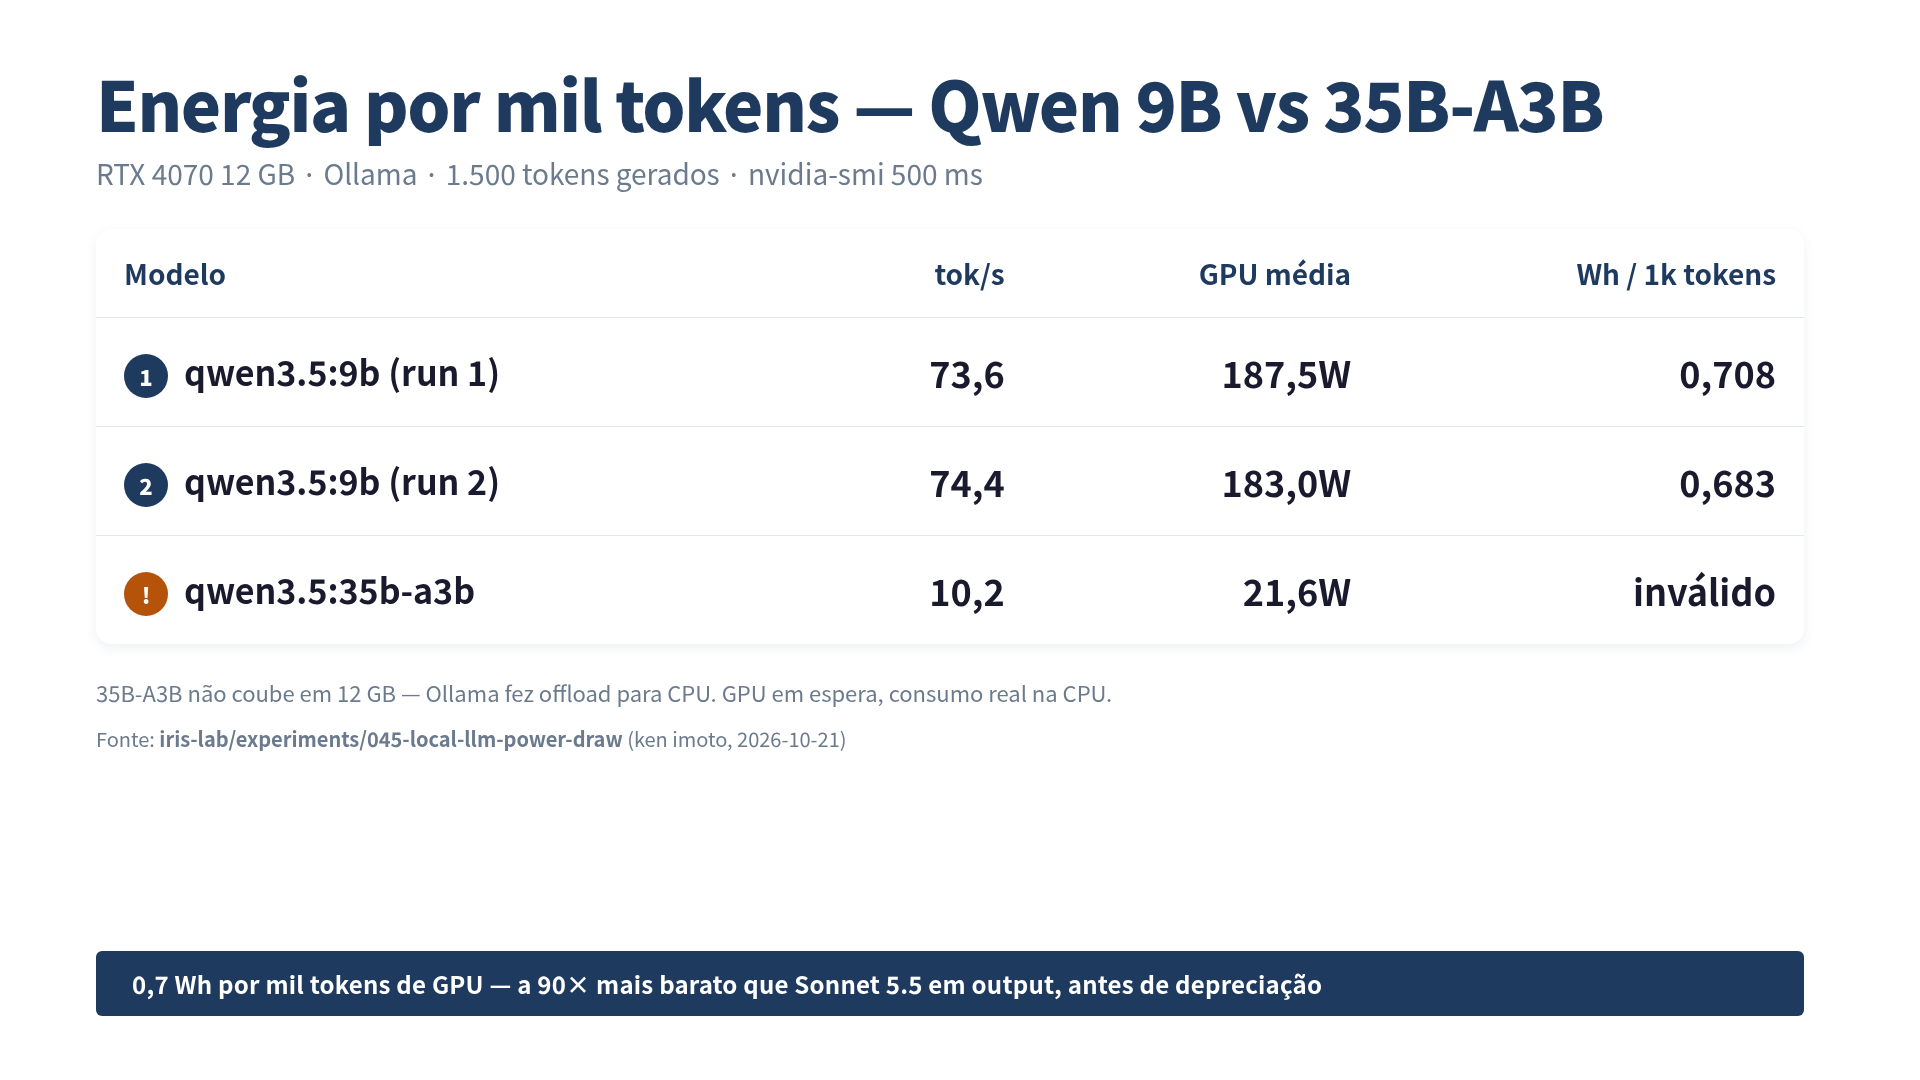
A variação entre run 1 e run 2 (4,5W, 1,1% de tok/s) é dentro de ruído de amostragem com nvidia-smi a 500 ms. Para fins de “quanto custa isso”, assume 0,7 Wh por mil tokens e segue.
O que não deu — e o que eu quase registrei errado
A linha do 35B-A3B merece parágrafo próprio porque é o tipo de medição que mente convincentemente. O modelo tem 35 bilhões de parâmetros com arquitetura MoE (3 bilhões ativos), teoricamente cabe mais fácil, mas no meu caso real ele não coube em 12 GB e o Ollama fez offload para CPU. A GPU ficou em 21,6W de média, 10 tok/s de throughput. Se eu reportasse esse número sem olhar o nvtop, pareceria que o 35B-A3B é absurdamente eficiente — “olha, tem metade do consumo do 9B!”.
É mentira. A GPU não estava trabalhando. A conta estava sendo paga em outra fatura. O cálculo real precisaria somar o consumo da CPU (12 cores em thermal throttle, ~65W sustentado) e o do DRAM thrashing. Só não dá para medir isso com nvidia-smi sozinho, e por isso a linha do 35B-A3B fica marcada como inválida no experimento.
Isso é o buraco de medir só uma coisa. Se você só olha o watt-meter da GPU, modelo que não cabe parece eficiente. Se você só olha a conta de luz do mês, modelo que cabe parece caro. Precisa das duas pontas, ou você vai para a Hacker News jurando que resolveu o problema.
Agora a conta que você veio ler
Com 0,7 Wh por mil tokens e a tarifa residencial média das 84 distribuidoras do país em outubro de 2026 (R$ 0,816/kWh, sem impostos) — bandeira de outubro é verde, e não entram ICMS, PIS/COFINS específicos da sua distribuidora — o custo direto de energia da GPU para gerar 1 milhão de tokens é:
0,7 Wh × 1.000 (para chegar a 1M tokens) = 700 Wh = 0,7 kWh
0,7 kWh × R$ 0,816/kWh = R$ 0,57
R$ 0,57 por milhão de tokens de energia direta de GPU. Esse é o número que gera a reação “então é praticamente de graça comparado com API”. Sim — se você só paga pela GPU trabalhando, e só pelo consumo dela.
Agora, para a comparação virar útil, repita o exercício com Claude Sonnet 5.5 (o modelo que a thread do TabNews fala em “trocar”). Preço público em outubro de 2026 é US$ 2 por milhão de tokens de input e US$ 10 por milhão de tokens de output segundo a tabela da Anthropic replicada em várias fontes. Com dólar a R$ 5,20 (ago-out 2026), isso dá R$ 10,40 de input e R$ 52 de output por 1M tokens. Então sim, o Qwen 9B local em energia pura é ~90× mais barato que o Sonnet 5.5 em output.
Pronto. Agora os asteriscos.
O que a comparação R$ 0,57 vs R$ 52 esconde
Três coisas que você já sabe mas é bom escrever para a próxima pessoa que te mandar essa thread:
Depreciação do hardware não entra. Uma RTX 4070 custa ~R$ 4.700 no Brasil (BR MSRP de ~US$ 599 + impostos de agosto 2026, Pichau e Terabyte). Se você amortiza em 3 anos de uso 8h/dia, isso é ~R$ 0,54 por hora de GPU. Em 8h gerando a 73 tok/s, cabem ~2,1 milhões de tokens. R$ 0,25 por milhão de tokens em depreciação, só da placa. Soma com energia e você vai para R$ 0,82/MTok ao invés de R$ 0,57 — ainda muito mais barato que API, mas a conta já não é “praticamente de graça”.
Qualidade por token não é igual. Esse texto não é sobre WDS (what does Qwen say) — é sobre watts. Mas em qualquer tarefa onde você precisa de 2x mais tokens para chegar na mesma resposta útil, a economia de 90× vira 45×. E para tarefas de reasoning longo, Qwen 9B costuma precisar de 2-3x mais tokens que Sonnet 5.5 para o mesmo resultado útil. A conta é por token útil, não por token.
O modelo não cabe sempre. Já mostrei que 35B-A3B não entrou em 12 GB. Se seu caso precisa de contexto grande ou modelos acima de ~13B, a RTX 4070 vira a parede, e você está no cenário “pago US$ 2.000 em RTX 4090 ou US$ 10/MTok em API”. Depende de quantos milhões de tokens você gera por mês para a conta fechar.
Quando o local realmente vale
Da minha medição, três cenários onde local ganha com folga:
- Alto volume, qualidade suficiente — bulk processing (classificação, summarização, extração) onde Qwen 9B é “bom o bastante” e você gera dezenas de milhões de tokens por semana. Aí a diferença de 90× em energia faz a conta fechar mesmo com depreciação.
- Latência local importa mais que qualidade marginal — ferramenta interna com SLA de resposta local, ou dev loop com Claude Code offline para operações que não precisam do melhor modelo possível.
- Dados sensíveis que não podem sair do rack — a conta nunca foi sobre dinheiro aqui, mas o modelo local é o único caminho. Se cair nesse bucket, nem compare preço.
Fora desses, o balanço mudou menos do que o TabNews deixa parecer. Para o seu dev loop pessoal com 50 mil tokens por semana, R$ 2 por mês em API é mais barato que o custo mental de administrar GPU em casa.
Limites honestos deste número
Antes que alguém abra uma issue:
- 1 modelo, 1 GPU, 2 rodadas. Não é um benchmark, é um ponto de medição. Qwen 7B pode ser mais eficiente, Llama 3.1 8B pode ser pior, GPU com undervolt pode baixar 20W. Rode o seu antes de me citar como fonte.
- Só a GPU. CPU, PSU e cooling adicionam ~30-50W no sistema, então o número da tomada é mais perto de 0,9-1,0 Wh por 1k tokens, não 0,7. Isso aumenta a conta de energia direta para ~R$ 0,80/MTok. Ainda baixo.
- Variação de preço da energia é grande. R$ 0,816 é a média das 84 distribuidoras. Enel RJ é R$ 1,061. Se você mora em região de distribuidora cara ou com bandeira vermelha 2, multiplique por 1,3. Se você tem solar, divida por 3.
- O número do 35B-A3B é lixo e eu deixei na tabela de propósito, para você ver que medir só a GPU engana. Se eu só mostrasse o 9B, você sairia daqui com uma impressão errada da arquitetura MoE.
Os CSVs brutos e o script de medição estão em iris-lab/experiments/045-local-llm-power-draw. Se refizer com GPU diferente, me manda o número — adiciono numa tabela e credito.
Se já tinha trocado Sonnet por Qwen local e nunca mediu a conta, pelo menos você agora sabe a ordem de grandeza. Se ainda está no API e via TabNews jurando que local é a resposta, pode continuar — mas sem a frase “é praticamente de graça”, porque com depreciação e PSU somados a resposta é ~R$ 0,80 por milhão de tokens, e isso é um número, não um slogan.
Para a leitura adjacente, o experimento de trocar Sonnet por Qwen 7B local em 3 tarefas de código cobre o lado “em que tarefa o local realmente vence” com mais detalhe.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev · TabNews
 Livro relacionado Transformando LLMs de Mentirosos em Especialistas Engenharia de Contexto na Prática | RAG · MCP · CLAUDE.md · Agentic RAG, com benchmarks de ponta a ponta Ver a página do livro →
Este artigo foi útil?