Busca web em 4 LLMs: cache do Codex fez 24/24
O uso da API da Kimi neste post foi pago com créditos que a Moonshot AI forneceu para avaliação. A Moonshot AI não participou do desenho, da execução nem das conclusões do teste.
Há quatro meses eu escrevi que os meus próprios agentes de IA buscam no Brave, não no Google (em inglês). Na época, como quase todo mundo, eu pensava em busca com IA a partir de qual buscador estava por baixo.
Desta vez, reli a documentação oficial para comparar a busca na web do Claude, do Codex, do Kimi K3 e do Qwen. E esse jeito de pensar já não funciona. Nenhum dos quatro fornecedores diz qual buscador usa. A OpenAI deixou um índice mantido por ela mesma como padrão no Codex. A Kimi passou a vender a própria busca como uma API separada. A pergunta deixou de ser “qual buscador?” e virou “onde a busca roda, e quem chama?”. Eu não esperava tanta mudança em quatro meses.
Se o mecanismo mudou, o resultado também deveria mudar. Antes de medir, eu achava que a busca ao vivo ganharia do cache sempre que a pergunta precisasse de informação recente.
A busca na web do Codex CLI não é ao vivo por padrão. Ela roda no modo “cached”, consultando um índice que a OpenAI mantém. A documentação explica o motivo: reduzir o risco de prompt injection (Codex: Web search). Eu li isso como abrir mão de um pouco de atualidade em troca de segurança.
As medições mostraram o contrário. Fiz as mesmas 8 perguntas, 3 vezes cada, em 5 configurações: Claude, Codex ao vivo, Codex em cache, Kimi K3 e um Qwen local. Só a busca em cache acertou todas. Ela achou até o título de um artigo que estava no ar havia umas três horas.
A outra surpresa: a mesma API de busca rendeu 21 acertos com um modelo e 9 com outro. Dei ao Kimi K3 e a um Qwen local exatamente o mesmo acesso à API de busca da Kimi. Os resultados da busca eram iguais. O jeito de cada modelo ler esses resultados, não.
Onde a busca roda muda de fornecedor para fornecedor
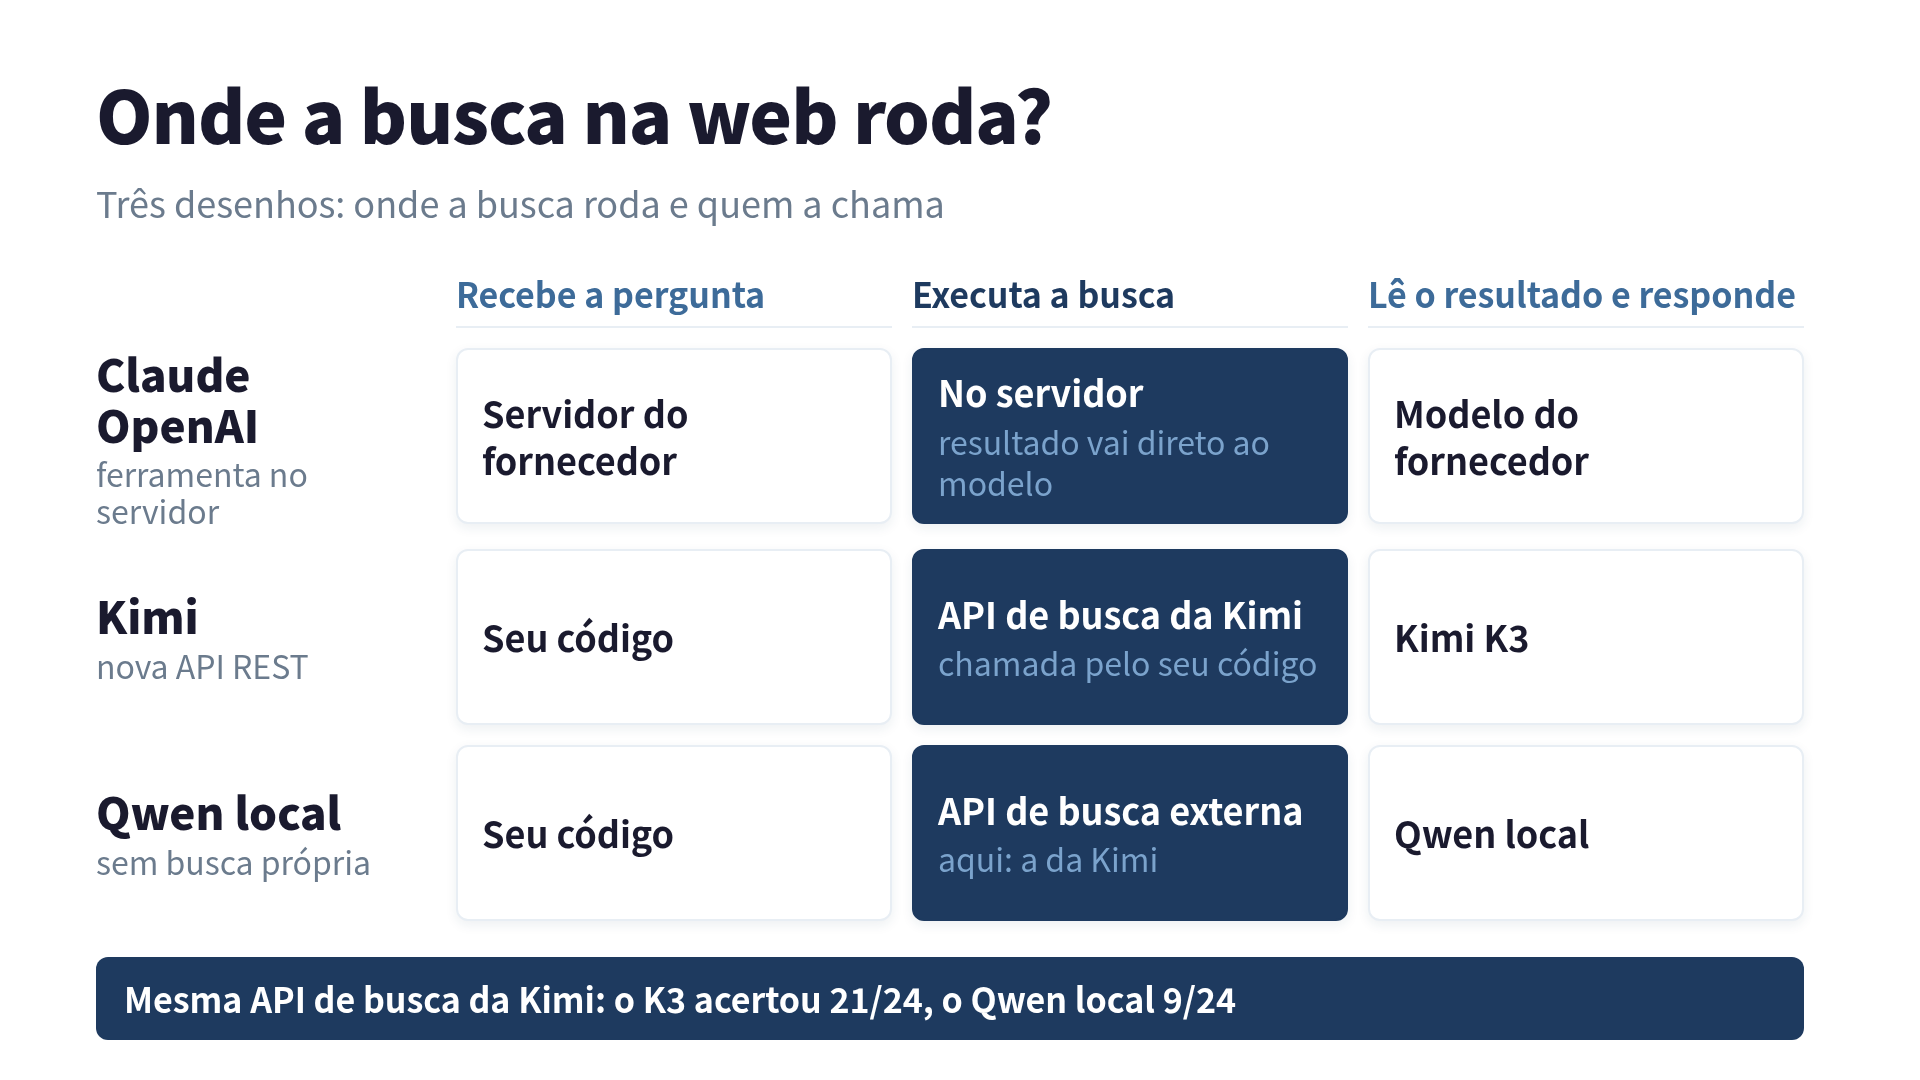
Antes de comparar, conferi o funcionamento na documentação pública. A maior diferença é onde a busca é executada.
| Claude | Codex / OpenAI | Kimi (Moonshot AI) | Qwen | |
|---|---|---|---|---|
| Onde a busca roda | Do lado da Anthropic (ferramenta no servidor) | Do lado da OpenAI (ferramenta hospedada) | API nova: o seu código chama e repassa o resultado ao modelo | Do lado da Alibaba (DashScope). Um Qwen local não tem busca |
| Controle de atualidade | Nenhum | O Codex usa cache por padrão; --search para ao vivo | Janela de tempo na busca Pro | Janela de 7 a 365 dias |
| Preço por busca | US$ 0,01 | US$ 0,01 | US$ 0,002 a 0,003 | Varia por região |
| Buscador | Não divulgado | Não divulgado (“índice mantido pela OpenAI”) | Não divulgado | Não divulgado |
Nenhum dos quatro diz oficialmente qual buscador usa. No caso do Claude, uma notícia de março de 2025 disse que o Brave Search tinha entrado na lista de subprocessadores da Anthropic (Simon Willison). A documentação de hoje fala só em “backend de busca da Anthropic”.
O Claude e a OpenAI rodam a busca nos próprios servidores e entregam o resultado ao modelo. No Claude, o resultado volta criptografado, e você precisa devolvê-lo sem alterações para continuar a conversa (Claude: Web search tool).
A Kimi está no meio de uma troca. A ferramenta embutida $web_search sai de linha em 2026-10-20. No lugar dela entram APIs REST separadas para buscar e baixar páginas, como /v1/tools/search (Kimi API: Web Search). Com as APIs novas, é você quem decide quando e quantas vezes buscar. Elas custam de um terço a um quinto das outras, e só cobram quando a chamada dá certo e traz resultado (Kimi: preços).
O Qwen, como modelo, não tem busca própria. A API da Alibaba Cloud oferece busca, mas um Qwen rodando localmente só pesquisa alguma coisa se você conectar uma ferramenta de busca externa.
Dois detalhes da documentação que valem saber
- O WebSearch do Claude Code devolve só títulos e URLs. Ele não lê as páginas. A leitura fica com o WebFetch, que antes resume a página com outra chamada de modelo. A própria documentação admite que isso perde informação de propósito (“lossy by design”) (Claude Code: Tools reference)
- A busca do Qwen na Alibaba Cloud é pulada sem aviso acima de 15 requisições por segundo. Não dá erro: a busca simplesmente não acontece. O FAQ também diz que perguntas em inglês muitas vezes não disparam a busca, e recomenda perguntar em chinês ou forçar a busca. As duas notas aparecem só na documentação em chinês (阿里云: 联网搜索)
Eu mesmo caí nessa perda de informação enquanto pesquisava para este post. Pedi ao WebFetch do Claude Code para ler a documentação do Qwen, e ele disse que não encontrou nem a nota dos 15 RPS nem o FAQ sobre inglês. Um grep no HTML bruto (uns 460 KB) achou as duas. Quando tem um resumo no meio, “isso não está escrito” pode só querer dizer “o resumo deixou de fora”.
Como eu medi
Cinco configurações, as mesmas 8 perguntas, 3 rodadas cada: 120 respostas avaliadas no total, coletadas na noite de 2026-10-14.
| Configuração | O que é |
|---|---|
| Claude | Claude Code (claude -p) com WebSearch / WebFetch, Opus 5.5 |
| OpenAI ao vivo | web_search da Responses API, gpt-5.6-terra (o modelo padrão do meu Codex CLI) |
| OpenAI em cache | Igual, mais external_web_access: false |
| Kimi K3 | kimi-k3 com uma função de busca minha, que chama /v1/tools/search da Kimi |
| Qwen local | qwen3.5:35b-a3b no Ollama com a mesma função de busca |
No Codex, chamei direto a API que o CLI usa por baixo. No código-fonte do Codex, o modo cached vira external_web_access=false e o ao vivo vira true (codex hosted_spec.rs). Assim, as chamadas à API reproduzem os dois modos do CLI.
Estas foram as 8 perguntas. Só usei perguntas com resposta que eu consigo conferir em fonte primária ou no meu próprio site.
| # | Pergunta | Resposta | O que testa |
|---|---|---|---|
| q1 | Data de lançamento da API do Kimi K3 | 2026-07-16 | Notícia posterior ao corte de treino |
| q2 | Data de lançamento dos pesos abertos do Kimi K3 (perguntada em inglês, com “release date”) | 2026-07-27 | A armadilha do “date” |
| q3 | Data de lançamento de um livro japonês, MCP実践セキュリティ (Impress) | 2026-10-16 | Fontes em japonês |
| q4 | Título em japonês de um artigo sobre o Kimi K3 publicado no kenimoto.dev naquele dia | Kimi K3の動画レビュー、Claudeと互角 | Atualidade: uma página com poucas horas |
| q5 | Data do release candidate da especificação MCP 2026-07-28 | 2026-05-21 | Um fato com data |
| q6 | Data em que o $web_search da Kimi sai de linha | 2026-10-20 | Um detalhe escondido na documentação |
| q7 | Parâmetros totais e ativos do Kimi K3 | 2.8T / 104B | Números |
| q8 | Data de lançamento do Kimi K4 | Não anunciado | Ele inventa algo que não existe? |
A q3 é um livro meu e a q4 é um artigo meu. Escolhi as duas porque sei as respostas com certeza. Isso traz um viés meu, e prefiro deixar claro. As duas estão em japonês, então também medem o quanto cada configuração alcança fontes em japonês.
Resultados
| Configuração | Acertos (de 24) | Parcial | Erro ou sem resposta | Tempo (mediana) | Buscas (média) |
|---|---|---|---|---|---|
| Claude | 21 | 1 | 2 | 22,0 s | 3,5 |
| OpenAI ao vivo | 22 | 1 | 1 | 5,7 s | 2,3 |
| OpenAI em cache | 24 | 0 | 0 | 6,2 s | 2,7 |
| Kimi K3 | 21 | 0 | 3 | 25,9 s | 4,0 |
| Qwen local | 9 | 2 | 13 | 31,1 s | 1,7 |
Acertos por pergunta, em 3 rodadas:
| Configuração | q1 | q2 | q3 | q4 | q5 | q6 | q7 | q8 |
|---|---|---|---|---|---|---|---|---|
| Claude | 3 | 2 | 1 | 3 | 3 | 3 | 3 | 3 |
| OpenAI ao vivo | 3 | 2 | 2 | 3 | 3 | 3 | 3 | 3 |
| OpenAI em cache | 3 | 3 | 3 | 3 | 3 | 3 | 3 | 3 |
| Kimi K3 | 3 | 3 | 3 | 0 | 3 | 3 | 3 | 3 |
| Qwen local | 0 | 2 | 0 | 0 | 0 | 2 | 3 | 2 |
Sobre o Kimi K4, que não existe (q8), todas as configurações disseram que ele ainda não foi anunciado. Numa rodada, o Qwen acrescentou, sem fonte, que o K4 tinha sido “mencionado como parte de planos para 2027 ou depois”.
Descoberta 1: o cache não estava velho
A busca em cache acertou as 24. O artigo da q4 entrou no ar pouco depois das 17h daquele dia, e eu medi umas três horas depois. A busca em cache devolveu o título nas três rodadas. Sinceramente, isso me surpreendeu. Pelo menos para o meu site, “um índice que a OpenAI mantém” foi atualizado em poucas horas.
A qualidade das fontes também pendeu para o cache em alguns momentos. Na q6 (quando o $web_search sai de linha), a busca em cache citou a documentação oficial da Kimi. A busca ao vivo deu a mesma resposta, mas numa rodada citou um site de compilação não oficial. Alcançar mais da web também significa pegar mais páginas não oficiais.
A busca ao vivo errou a q3, o livro japonês, uma vez: disse que não conseguia confirmar um livro com aquele título.
Descoberta 2: mesmo resultado de busca, respostas diferentes
O Kimi K3 e o Qwen local receberam exatamente a mesma API de busca, do mesmo jeito. Mesmo assim, fizeram 21 e 9. É mais que o dobro.
Os erros do Qwen seguiram alguns padrões:
- A crença de que ainda é 2024 venceu o resultado da busca. Na q4 ele disse: “Hoje (maio de 2024), um artigo de 14 de outubro de 2026 não existe. É uma data no futuro.” Na q1 ele achou a data de 16 de julho e concluiu que o modelo “ainda não foi lançado em 2025”
- A fonte e a resposta não batiam. Na q5, as três rodadas citaram o anúncio do release candidate, de 21 de maio, e responderam com a data da versão final, 28 de julho
- Ele inventou uma fonte. Na q3, citou uma URL de comunicado da Impress que não existe (404) e deu uma data errada. Cada rodada deu uma data errada diferente
- Ele quase não buscou. Foram 1,7 buscas em média, menos da metade das 4,0 do K3
O tamanho dos modelos é diferente, então isso não é um veredito sobre o Qwen como um todo. O que dá para afirmar é que a precisão da busca na web não depende só da API de busca.
Descoberta 3: a API de busca da Kimi tem duas falhas
Os três erros do K3 foram todos na q4. Ele reformulou a busca 12 vezes e não achou o artigo do mesmo dia. A página ainda não estava no índice de busca da Kimi. O problema estava na atualidade do índice, e o modelo não teve culpa.
A segunda falha: buscas com o operador site: devolvem HTTP 502. Tanto o K3 quanto o Qwen tentaram site:kenimoto.dev para achar uma página específica. Toda vez, a API de busca devolveu uma página de erro que não era JSON, e na primeira rodada isso derrubou o meu script. Agora a minha ferramenta devolve a falha ao modelo, para ele reformular e tentar de novo.
Chamar a API de busca diretamente também mostrou o quanto a escolha das palavras pesa. Buscar “Kimi K3 release date Moonshot AI” deixou o “date” dominar: vieram um site de fusos horários e a documentação do Date do JavaScript. Buscar só “Kimi K3” pôs o site oficial, o paper e o GitHub no topo. Nos testes de verdade, porém, nenhum modelo caiu nessa armadilha. O K3 e o Qwen reformularam as próprias buscas e desviaram dela.
Aliás, a ferramenta $web_search, que vai sair de linha, não funcionou com o K3. A segunda chamada, a que devolve o resultado da busca, falhou toda vez com 400 tokenization failed. Passar a busca por function calling comum, como neste teste, funciona sem problema no K3 (mais detalhes em Kimi K3 vs Claude: Video Review, Same Findings, em inglês).
O Claude teve dificuldade com um livro japonês
Na q3, o Claude disse em 2 das 3 rodadas que não encontrou o livro e que talvez ele não exista. O livro está listado, com data de lançamento, na página da NextPublishing, da editora, e na Rakuten Books.
Em outros pontos, ele foi persistente. Numa rodada da q4, o WebSearch não trouxe o artigo, e o Claude o achou pelo sitemap e abriu a página para confirmar título e data. Como o WebSearch devolve só títulos e URLs, buscar a página quando necessário faz parte do desenho, e aqui isso compensou. O Claude também avisou várias vezes que só tinha conferido fontes secundárias, e evitou afirmações categóricas.
A mediana de 22 segundos inclui o loop de agente do Claude Code. Chamar a ferramenta de busca direto pela API deve ser mais rápido.
Como vou usar cada um
O que eu levo deste teste:
- Deixe a busca em cache como padrão para pesquisa. Se você usa o Codex, não precisa passar
--searchtoda vez. A configuração mais segura não perdeu em precisão - Não confie em “não encontrei” para fontes fora do inglês. Não encontrar não é o mesmo que não existir. Quando o Claude diz isso, eu confiro de outro jeito
- Se você mesmo conecta a busca, o modelo pesa mais. Com a mesma API de busca, o K3 e o Qwen diferiram em mais que o dobro. Escolha um modelo que saiba ler resultados de busca antes de escolher a API de busca mais barata
- Faça a sua ferramenta de busca devolver falhas. A API de busca da Kimi devolve 502 com
site:. Passe a falha para o modelo em vez de derrubar o processo, e ele reformula e busca de novo
Limitações
- É um teste pequeno: 8 perguntas, 3 rodadas. Os temas puxam para o Kimi K3 e o MCP, e a q3 e a q4 são um livro e um artigo meus
- O Claude rodou pelo Claude Code; os resultados do Codex vêm de chamadas à API que o CLI usa
- A configuração do Qwen é um modelo local de 35B conectado à busca da Kimi, não a busca oficial do Qwen
- Cada configuração funciona de um jeito, então os tempos não são diretamente comparáveis. Não somei os custos neste teste
O próximo passo é chamar a ferramenta de busca do Claude direto pela API e testar a busca oficial do Qwen na Alibaba Cloud, para fechar as diferenças entre as configurações.
Referências
- Claude: Web search tool: preços, citações, resultados criptografados, versões
- Claude Code: Tools reference: como o WebSearch e o WebFetch se comportam
- Codex: Web search: modos cached / ao vivo
- OpenAI: Web search tool:
external_web_access - openai/codex hosted_spec.rs: como os modos viram
external_web_access - Kimi API: Web Search / boas práticas / preços
- 阿里云 百炼: 联网搜索 (em chinês; a nota dos 15 RPS e o FAQ sobre perguntas em inglês só aparecem aqui)
 Livro relacionado Harness Engineering Tutorial de Harness Engineering | design de AGENTS.md · implementação de hooks · operação de agentes de IA Ver a página do livro →
Este artigo foi útil?