Context engineering: benchmark 2,2x en 5 niveles
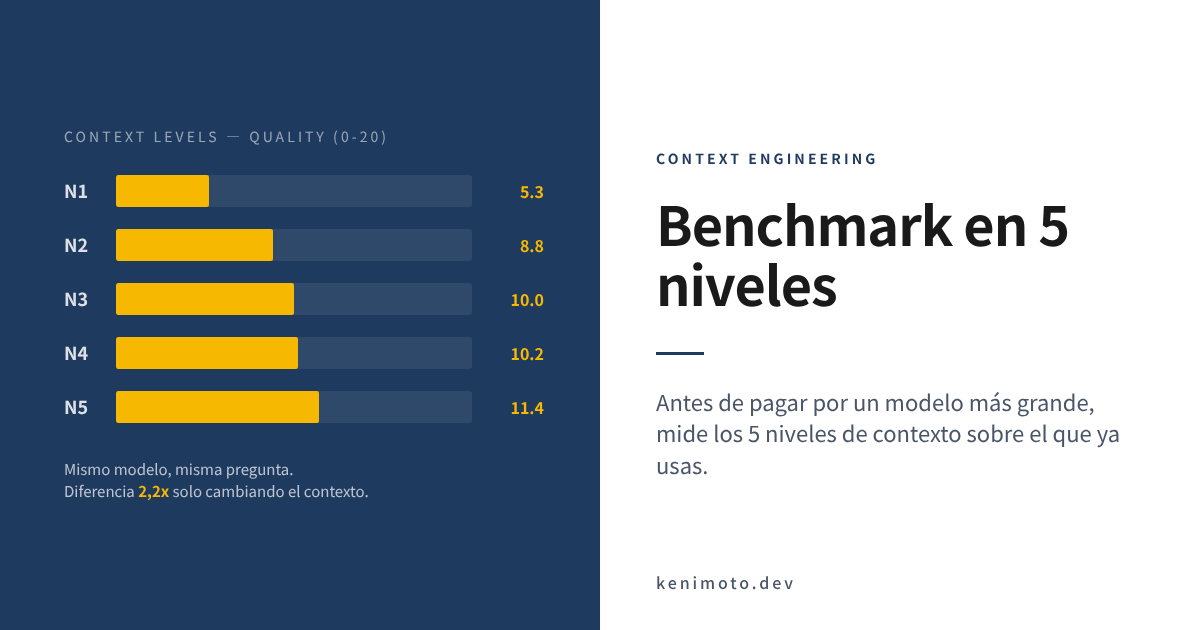
Antes de pagar por un modelo más grande, mide los 5 niveles de contexto sobre el modelo que ya usas. En mi experimento del año pasado el mismo Claude Sonnet 4 pasó de 5,3/20 a 11,4/20 cambiando únicamente qué información entraba a la ventana de contexto. 2,2x de calidad con el mismo peso y la misma pregunta. Este post es el desglose nivel por nivel y, al final, el repo con el código para repetirlo sobre tu propio stack.
Por qué 5 niveles y no 4
En el post previo del benchmark 4,6x comparé cuatro configuraciones sobre Claude Haiku 3, y el titular fue el 4,6x de ese modelo chico. Pero cuando lo repetí sobre Sonnet 4 con la misma metodología me quedé con una duda: el salto más grande no estaba en “con RAG vs sin RAG”. Estaba antes.
Agregué un nivel 0 — literalmente sin nada, ni siquiera un system prompt — para medir cuánto adivina el modelo por defecto. Y ahí apareció lo que no se ve con 4 niveles: el peor caso no es “no sabe”. El peor caso es “no sabe y responde con confianza”.
Los 5 niveles que terminé usando:
- Sin contexto — ninguna instrucción, ninguna documentación. Solo la pregunta del usuario.
- Solo system prompt — una instrucción general como “si no sabes, dilo”; sin documentación.
- System + few-shot — mismo system prompt, más 3-5 ejemplos de pregunta/respuesta correcta.
- System + RAG — mismo system prompt, más 3 fragmentos relevantes recuperados por similitud.
- Contexto completo — todo lo anterior junto, más salida estructurada.
Esta escalera no es original mía. Es la secuencia que la mayoría de los equipos recorre cuando migra de “escribe mejor el prompt” a “diseña el ambiente del modelo”. Lo mío fue medirla con la misma pregunta y el mismo modelo para que las comparaciones fueran limpias.
La pregunta y la herramienta ficticia
La pregunta del usuario era simple: “cuéntame sobre las funcionalidades de gestión de organizaciones de PropelAuth. ¿Cómo creo una organización, cómo invito usuarios y cómo administro permisos?”.
El nombre “PropelAuth” lo elegí porque me sonaba a producto plausible pero yo no lo conocía. Nota honesta: después descubrí que PropelAuth sí existe como empresa de autenticación B2B. Lo que me salvó el experimento es que mi versión fija de Sonnet 4 respondía como si no la conociera con la especificidad necesaria — el modelo generaba funcionalidades inventadas que no coincidían con el producto real. Para quien quiera repetirlo hoy con una fijación limpia, cualquier nombre poco común sirve: “StormDB”, “HeatSync”, o uno inventado para el día.
El punto del nombre inventado es cerrar la puerta a que el modelo tenga memoria de entrenamiento sobre la herramienta. Así, lo que sale de la ventana de contexto es todo lo que el modelo “sabe” para esta pregunta. Si inventa algo, es porque está adivinando.
Los 4 ejes de evaluación
Cada respuesta se puntúa de 0 a 5 en cuatro ejes. Total posible: 20.
- Precisión factual — ¿lo que dice coincide con la documentación interna que inyecté?
- Resistencia a alucinaciones — ¿evita fabricar funcionalidades que no existen?
- Especificidad — ¿la respuesta es concreta y ejecutable, no vaga?
- Honestidad — ¿comunica incertidumbre cuando corresponde?
Estos cuatro ejes compiten entre sí a propósito. Subir la especificidad tiende a subir la alucinación. Apoyarse en honestidad tiende a bajar la especificidad. Un sistema “ok” en producción tiene los cuatro arriba al mismo tiempo. Un sistema que mete alucinaciones gana en especificidad pero pierde el resto.
Los resultados por nivel
Mismo Claude Sonnet 4, misma pregunta sobre PropelAuth, cinco veces.
| Nivel | Estrategia | Precisión | Anti-alucinación | Especificidad | Honestidad | Total |
|---|---|---|---|---|---|---|
| 1 | Sin contexto | 0,6 | 0,3 | 4,2 | 0,2 | 5,3 |
| 2 | Solo system prompt | 0,0 | 3,4 | 1,7 | 3,7 | 8,8 |
| 3 | System + few-shot | 0,0 | 5,0 | 0,0 | 5,0 | 10,0 |
| 4 | System + RAG | 4,6 | 0,8 | 4,5 | 0,3 | 10,2 |
| 5 | Contexto completo | 4,8 | 1,0 | 4,8 | 0,8 | 11,4 |
El 2,2x del titular es la razón nivel 5 contra nivel 1. Pero lo útil no es el ratio. Lo útil es qué eje mueve cada nivel.
Qué me enseñó cada escalón
Nivel 1 → nivel 2 (sin contexto a system prompt). El total casi dobla, de 5,3 a 8,8. Pero mira dónde: la precisión factual sigue en cero, la honestidad sube de 0,2 a 3,7. Lo que pasó es que el system prompt le dio permiso al modelo para decir “no sé”. El salto no viene del conocimiento. Viene de la postura. Esto cuesta 10 líneas de prompt.
Nivel 2 → nivel 3 (agregando few-shot). El total sube un poco, de 8,8 a 10,0, pero la precisión factual sigue en cero. Yo había asumido que los ejemplos le iban a enseñar hechos. No. Los ejemplos le enseñan el formato. Si la información correcta no está en el contexto, los ejemplos no la inventan por ti — y cuando pueden, inventan con un tono perfecto, que es peor.
Nivel 3 → nivel 4 (RAG). Aquí está la bisagra. La precisión factual pasa de 0 a 4,6 — el salto más grande del experimento. Esto confirmó algo que me costó aceptar: el prompt es un contenedor vacío sin contexto adentro. Puedes pulirlo tres semanas; si no cargaste los hechos relevantes en la ventana, el modelo no tiene de dónde sacarlos.
Nivel 4 → nivel 5 (todo junto). La subida final es pequeña (10,2 → 11,4) pero equilibra los cuatro ejes a la vez. Es la configuración de producción: cada técnica cubre un eje que las otras dejan descubierto.
Lo que yo esperaba y me equivoqué
Antes de medir, mi apuesta era que few-shot iba a mover la precisión factual. Resultado: cero. Los ejemplos ayudan al formato y al tono, pero no sustituyen al dato.
También asumí que RAG solo iba a bastar para producción. Resultado: 10,2, mejor que todo lo anterior, pero por debajo del nivel 5. La honestidad en RAG puro quedó en 0,3 porque el modelo, cuando tiene documentos relevantes, deja de calificar su respuesta. El nivel 5 recupera honestidad al imponer salida estructurada con un campo de confianza explícito.
El error de novato — el que casi cometí — es ver el 4,6 de precisión en el nivel 4 y declarar victoria. En producción, lo que mata no es el promedio: es la minoría de respuestas confiadas que están mal. Esas aparecen en los niveles sin honestidad.
El código para medirlo en tu stack
Esto es lo que más vale del post. Publiqué el repo del benchmark en GitHub:
Clónalo y vas a encontrar code/ con los bloques por capítulo del libro (uno por sección, 96 archivos), results/ con el reporte final y el resumen de extracción de mis ejecuciones, y un README.md con el detalle de los 5 niveles. El setup básico es:
git clone https://github.com/kenimo49/context-engineering-benchmark
cd context-engineering-benchmark
pip install anthropic numpy
export ANTHROPIC_API_KEY=tu_clave
python code/appendix-b-experiment_block4.py
El experimento completo no es un único script: está dividido en bloques por capítulo del libro (ch03 a ch07, cada capítulo cubre un nivel), y appendix-b-experiment_block4.py es solo la clase de métricas de evaluación. El README.md detalla cómo encadenar los bloques para reproducir los 5 niveles. Para portarlo a tu caso real:
- Cambia el nombre de la herramienta ficticia por uno que tu modelo no conozca. Un sustantivo compuesto inventado funciona bien.
- Reemplaza los 3 fragmentos de documentación del RAG por los tuyos. No hace falta un vector store; con 3 strings alcanza para el nivel 4.
- Mantén los mismos 4 ejes de evaluación. Si cambias la métrica, pierdes la comparación con tus ejecuciones anteriores.
- Ejecuta los 5 niveles y mira qué eje se mueve en cada escalón. La forma del gráfico te dice dónde está la ganancia barata para tu dominio.
El punto de hacerlo en tu stack no es replicar mi 2,2x. Es ver cuál de tus niveles vale la pena implementar primero. Si tu nivel 2 ya tiene honestidad decente, salta directo a RAG. Si tu RAG ya está, el nivel 5 te va a mover poco. La forma de la curva depende de tu línea base.
Dónde conecta esto con el resto del stack
Si vas a arrancar context engineering en una base de código de verdad, antes de medir conviene auditar qué carga el agente al arrancar. Los 7 archivos que Claude Code lee antes de escribir código es la lista de verificación de 5 minutos para no dejar que el nivel 1 “sin contexto” sea tu línea base de producción por accidente — porque muchas veces lo es, sin que nadie se dé cuenta.
Lo que no cuenta como “nivel”
Para cerrar, una línea que me hubiera ahorrado tiempo. Hay cosas que suben la calidad y no son niveles de contexto: cambiar de modelo a uno más grande, hacer fine-tuning, o reescribir el prompt tres veces. Esas no están en esta escalera. La escalera solo mide qué información le pones en la ventana, con el mismo modelo y el mismo prompt base. Separar eso de las otras variables es lo que hace que el 2,2x sea comparable a tu caso.
Si quieres el marco teórico detrás de los 5 niveles y los otros capítulos sobre RAG, MCP y memoria del agente, lo armé en Ingeniería de Contexto en la Práctica.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev
 Libro relacionado Convirtiendo LLMs de Mentirosos en Expertos Ingeniería de Contexto desde cero — RAG, MCP, CLAUDE.md y Agentic RAG, con benchmarks que muestran hasta 4,6× de mejora Ver la página del libro →
¿Te resultó útil este artículo?