Evaluar RAG en producción: 3 ejes y sus pesos
Antes de pasar RAG a producción, alguien pregunta cuál es la accuracy. La respuesta honesta es que accuracy sola no dice si el sistema es seguro para usuarios reales. Un RAG puede acertar 92 de 100 preguntas y seguir siendo peligroso, porque las 8 que falla suenan tan convincentes como las 92 que acierta.
Este texto explica los 3 ejes con los que se evalúa RAG en producción, cómo se pesan y por qué la fidelidad es el eje que más pesa. Está basado en el capítulo 12b de mi libro Ingeniería de Contexto en la Práctica y contrastado con los dos frameworks abiertos más usados de 2026: RAGAS y TruLens.
Los 3 ejes y sus pesos
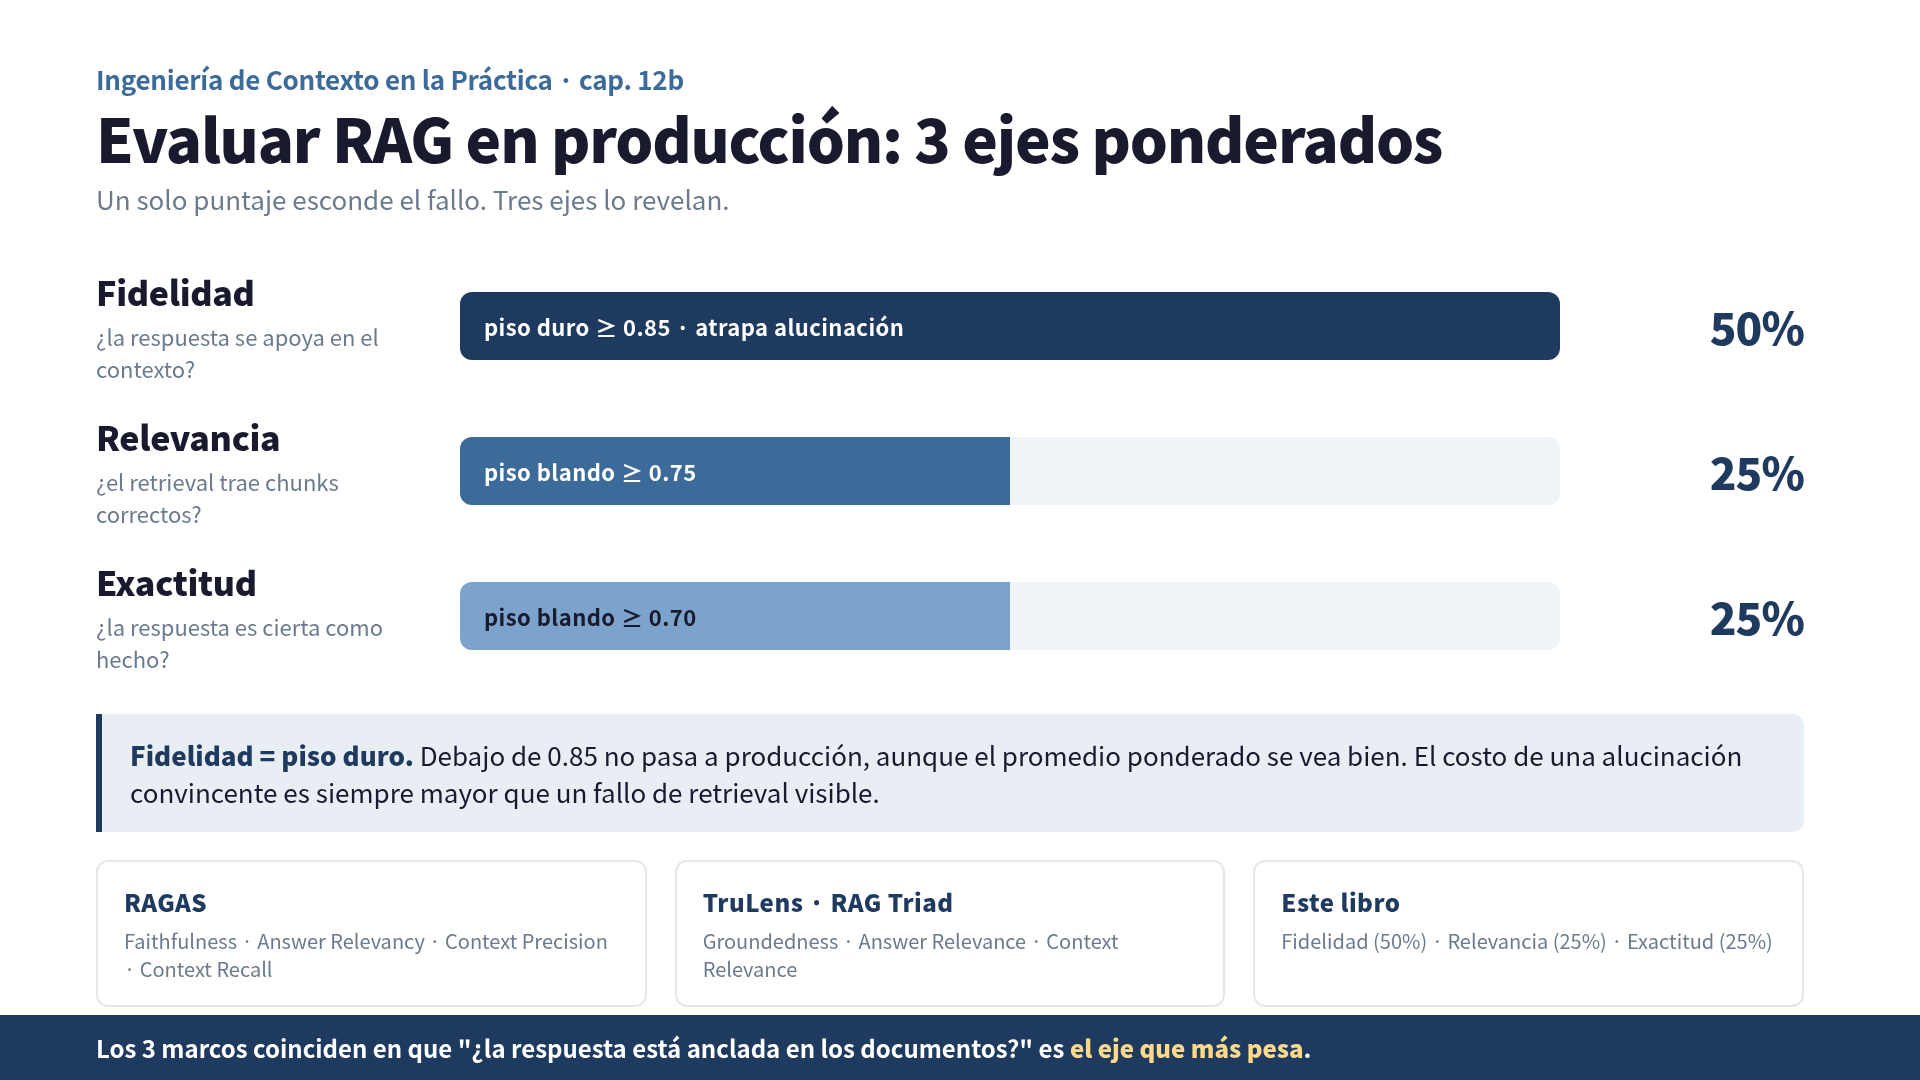
La propuesta del libro es evaluar RAG con estos 3 ejes ponderados:
| Eje | Qué mide | Peso | Métodos |
|---|---|---|---|
| Fidelidad (Faithfulness) | Si la respuesta está sostenida por el contexto recuperado | 50% | Verificación oración a oración + LLM-as-a-Judge + solapamiento de entidades |
| Relevancia (Relevancy) | Si los chunks recuperados responden a la pregunta | 25% | Similitud semántica + solapamiento de keywords + LLM-as-a-Judge |
| Exactitud (Correctness) | Si la respuesta es cierta como hecho | 25% | Comparación contra ground truth, o auto-consistencia si no hay |
El peso importa tanto como la métrica. Un puntaje ponderado de 0.90 con fidelidad al 0.70 no es lo mismo que 0.90 con exactitud al 0.70. La primera versión filtra alucinaciones convincentes; la segunda no.
Por qué la fidelidad pesa 50%
Fidelidad es el eje que atrapa la alucinación. Cuando un LLM inventa un dato que suena verdadero pero no aparece en los documentos recuperados, exactitud puede seguir alta (si el modelo por casualidad sabía la respuesta), relevancia puede seguir alta (los chunks eran del tema correcto), pero fidelidad baja. Es la única señal que se rompe.
En entornos empresariales, la alucinación convincente es el riesgo caro. Un chatbot legal que cita una cláusula que no existe cuesta más que uno que responde “no encuentro esa cláusula”. La regla dura que uso en el libro: umbral mínimo de fidelidad = 0.85. Por debajo de eso el sistema no pasa a producción, aunque el promedio ponderado esté aceptable.
Esta jerarquía la comparten los frameworks abiertos:
- RAGAS define cuatro métricas centrales (faithfulness, answer relevancy, context precision, context recall) según la documentación de RAGAS. La documentación no fija umbrales, pero es práctica común en la literatura de RAG aplicar un umbral más estricto a faithfulness que al resto, porque el costo de un fallo de fidelidad suele ser mayor que el de un fallo de retrieval.
- TruLens define el “RAG Triad”: context relevance, groundedness y answer relevance. Groundedness es equivalente a fidelidad, y la documentación de TruLens marca los tres como necesarios para descartar alucinaciones.
Los tres marcos coinciden en tener al menos un eje que mide “¿la respuesta está anclada en los documentos?”. En el libro ese eje se trata como piso duro; en RAGAS y TruLens el usuario elige cómo pesarlo, pero todos lo tratan como métrica de primera línea.
Fidelidad no se mide con una sola técnica
En el libro proponemos combinar tres técnicas para el puntaje de fidelidad:
# Pseudocódigo del patrón de diseño, no código para copiar y pegar
puntaje_fidelidad = (
    verificacion_oracion_a_oracion(respuesta, contexto) * 0.4 +
    llm_judge_global(respuesta, contexto)               * 0.4 +
    solapamiento_entidades(respuesta, contexto)         * 0.2
)
Por qué tres y no una:
- Verificación oración a oración rompe la respuesta en oraciones y verifica cada una contra el contexto. Es lo más cercano a “citar la fuente”. RAGAS hace esto con “statements” (afirmaciones descompuestas).
- LLM-as-a-Judge mira la respuesta completa contra el contexto completo y asigna un puntaje de 0 a 1. Captura fallas que la técnica anterior no ve, por ejemplo una respuesta cuyas oraciones individuales cuadran pero la conclusión global no.
- Solapamiento de entidades verifica que los nombres propios de la respuesta (personas, empresas, cifras, fechas) también aparezcan en el contexto. Es un check barato y determinista para atrapar el caso “la oración es plausible pero cambia un nombre”.
Cuando los tres se contradicen, hay algo raro en el retrieval. Cuando los tres coinciden en un puntaje bajo, la respuesta se descarta.
Cuando no hay ground truth
En producción, casi nunca tienes un conjunto de datos con respuestas correctas verificadas. Los usuarios preguntan cosas nuevas cada día y nadie va a etiquetar 500 respuestas correctas por semana. Ahí es donde la exactitud tradicional se rompe.
La forma de compensar es sustituir la comparación contra ground truth por 4 indicadores sustitutos:
| Indicador sustituto | Cómo medir | Peso sugerido |
|---|---|---|
| Auto-consistencia | Ejecutar la misma pregunta N veces y medir varianza de respuestas | 30% |
| Cobertura | LLM-as-a-Judge estima qué porcentaje de la intención de la pregunta está cubierta | 25% |
| Claridad | Estructura y legibilidad de la respuesta (puntaje 0-1 por LLM Judge) | 20% |
| Consistencia externa | La respuesta no contradice hechos conocidos (checks contra fuentes externas si están disponibles) | 25% |
Este bloque de 4 indicadores reemplaza el 25% de exactitud cuando no hay ground truth. Los otros dos ejes (fidelidad 50%, relevancia 25%) siguen tal cual.
Dónde diverge la práctica del libro y RAGAS
RAGAS separa el retrieval en dos métricas explícitas: context precision (los chunks relevantes están arriba en el ranking) y context recall (todo lo necesario para responder está en el contexto recuperado). En el libro uso una sola métrica de relevancia (25%) que combina los dos, con el argumento de que en la mayoría de sistemas de producción no vale la pena separar precision de recall si no vas a ajustarlos de forma independiente.
La divergencia es de nivel de detalle, no de dirección. Si tu sistema tiene un componente de retrieval que ajustas por separado del generador, es útil medir precision y recall aparte. Si el flujo es una caja negra que consumes de un vendor, medir una relevancia agregada alcanza.
Cómo se lee un puntaje en producción
El puntaje ponderado no es un número para promediar de un mes a otro. Es un tablero de tres filas donde cada fila tiene un umbral:
fidelidad     ≥ 0.85    ← piso duro. Debajo, no pasa a producción
relevancia    ≥ 0.75    ← piso blando. Debajo, revisar retrieval
exactitud     ≥ 0.70    ← piso blando. Debajo, revisar prompts o modelo
Si fidelidad cae debajo de 0.85 y las otras dos siguen bien, el diagnóstico es alucinación (el generador está inventando datos que no están en el contexto). Si relevancia cae y fidelidad se mantiene, el diagnóstico es retrieval débil (chunks mal indexados o embeddings pobres). Si exactitud cae y las otras dos se mantienen, el diagnóstico suele ser prompt o modelo (la información estaba disponible pero el LLM la reformuló mal).
Ese es el valor real de los 3 ejes: sirven como guía de diagnóstico más que como un puntaje único. Accuracy sola no te dice cuál de los tres fallos tienes.
Límites de este enfoque
Tres cosas que no cubren estos 3 ejes:
- Costo por respuesta. El LLM-as-a-Judge que calcula fidelidad cuesta tokens. En un flujo de 10.000 preguntas por día, evaluar cada respuesta duplica el costo. La solución práctica es muestrear (evaluar el 5-10% de las respuestas) y alertar cuando el puntaje del muestreo cae fuera de rango.
- Latencia percibida por el usuario. Los 3 ejes miden calidad de respuesta, no velocidad. Un RAG con fidelidad 0.90 pero latencia de 8 segundos pierde usuarios igual. Latencia se mide por separado.
- Sesgo del propio LLM-as-a-Judge. El evaluador es un LLM y comparte sesgos con el modelo evaluado. Existen benchmarks públicos como el de Snowflake sobre el RAG triad que comparan el desempeño de distintos jueces sobre estas métricas. La mitigación práctica ante el riesgo de sesgo por familia es usar un juez de una familia distinta del modelo evaluado (Claude evaluando GPT-4, o al revés).
Qué cambia para tu equipo
Si estás midiendo tu RAG solo con accuracy, cambia el tablero a estos 3 ejes esta semana. Es un cambio de una tarde:
- Elige un framework (RAGAS o TruLens) para arrancar. RAGAS es más común, TruLens tiene mejor integración con LangChain.
- Fija los umbrales del piso duro (fidelidad ≥ 0.85 es un buen punto de partida).
- Ejecuta los 3 ejes en el 5-10% de las respuestas de producción y alerta cuando alguno cruza el piso.
Ese setup mínimo ya es un salto sobre “medimos accuracy y todo bien”. Lo que gana el equipo es poder decir en qué componente falló el sistema cuando falla, en lugar de mostrar un número más bonito.
Referencias
- Ken Imoto. Ingeniería de Contexto en la Práctica, capítulo 12b “RAG Empresarial — Evaluación, seguridad y selección de Vector DB”. Kindle, 2026-05. Ficha del libro
- RAGAS. “List of available metrics”. https://docs.ragas.io/en/stable/concepts/metrics/available_metrics/
- TruLens (TruEra). “RAG Triad — Core Concepts”. https://www.trulens.org/getting_started/core_concepts/rag_triad/
- Snowflake Engineering Blog. “Benchmarking LLM-as-a-Judge for the RAG Triad Metrics”. https://www.snowflake.com/en/engineering-blog/benchmarking-LLM-as-a-judge-RAG-triad-metrics/
Si quieres el marco completo de Ingeniería de Contexto con los benchmarks originales sobre por qué “modelo pequeño + buen contexto” gana a modelo grande solo, está en Ingeniería de Contexto en la Práctica.
Cierre
- Accuracy sola no distingue una respuesta correcta de una alucinación convincente. Por eso RAG en producción se evalúa con 3 ejes: fidelidad, relevancia, exactitud.
- Fidelidad pesa 50% y funciona como piso duro (≥ 0.85). Los otros dos ejes son pisos blandos que guían el diagnóstico.
- Cuando no hay ground truth, exactitud se reemplaza por 4 indicadores sustitutos (auto-consistencia, cobertura, claridad, consistencia externa).
- El puntaje ponderado no es un promedio bonito: es un tablero que te dice qué componente falló (retrieval, generador o modelo) cuando la respuesta falla.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev
 Libro relacionado Convirtiendo LLMs de Mentirosos en Expertos Ingeniería de Contexto desde cero — RAG, MCP, CLAUDE.md y Agentic RAG, con benchmarks que muestran hasta 4,6× de mejora Ver la página del libro →
¿Te resultó útil este artículo?