Krisp 6M vs VAD: turn-taking en voice AI
La primera queja recurrente cuando alguien prueba un agente de voz suele ser la misma: “me interrumpe”. La segunda: “se queda callado”. Son la misma queja disfrazada. Las dos vienen del mismo componente: el detector de fin de turno que casi todo el mundo hereda por defecto, el VAD.
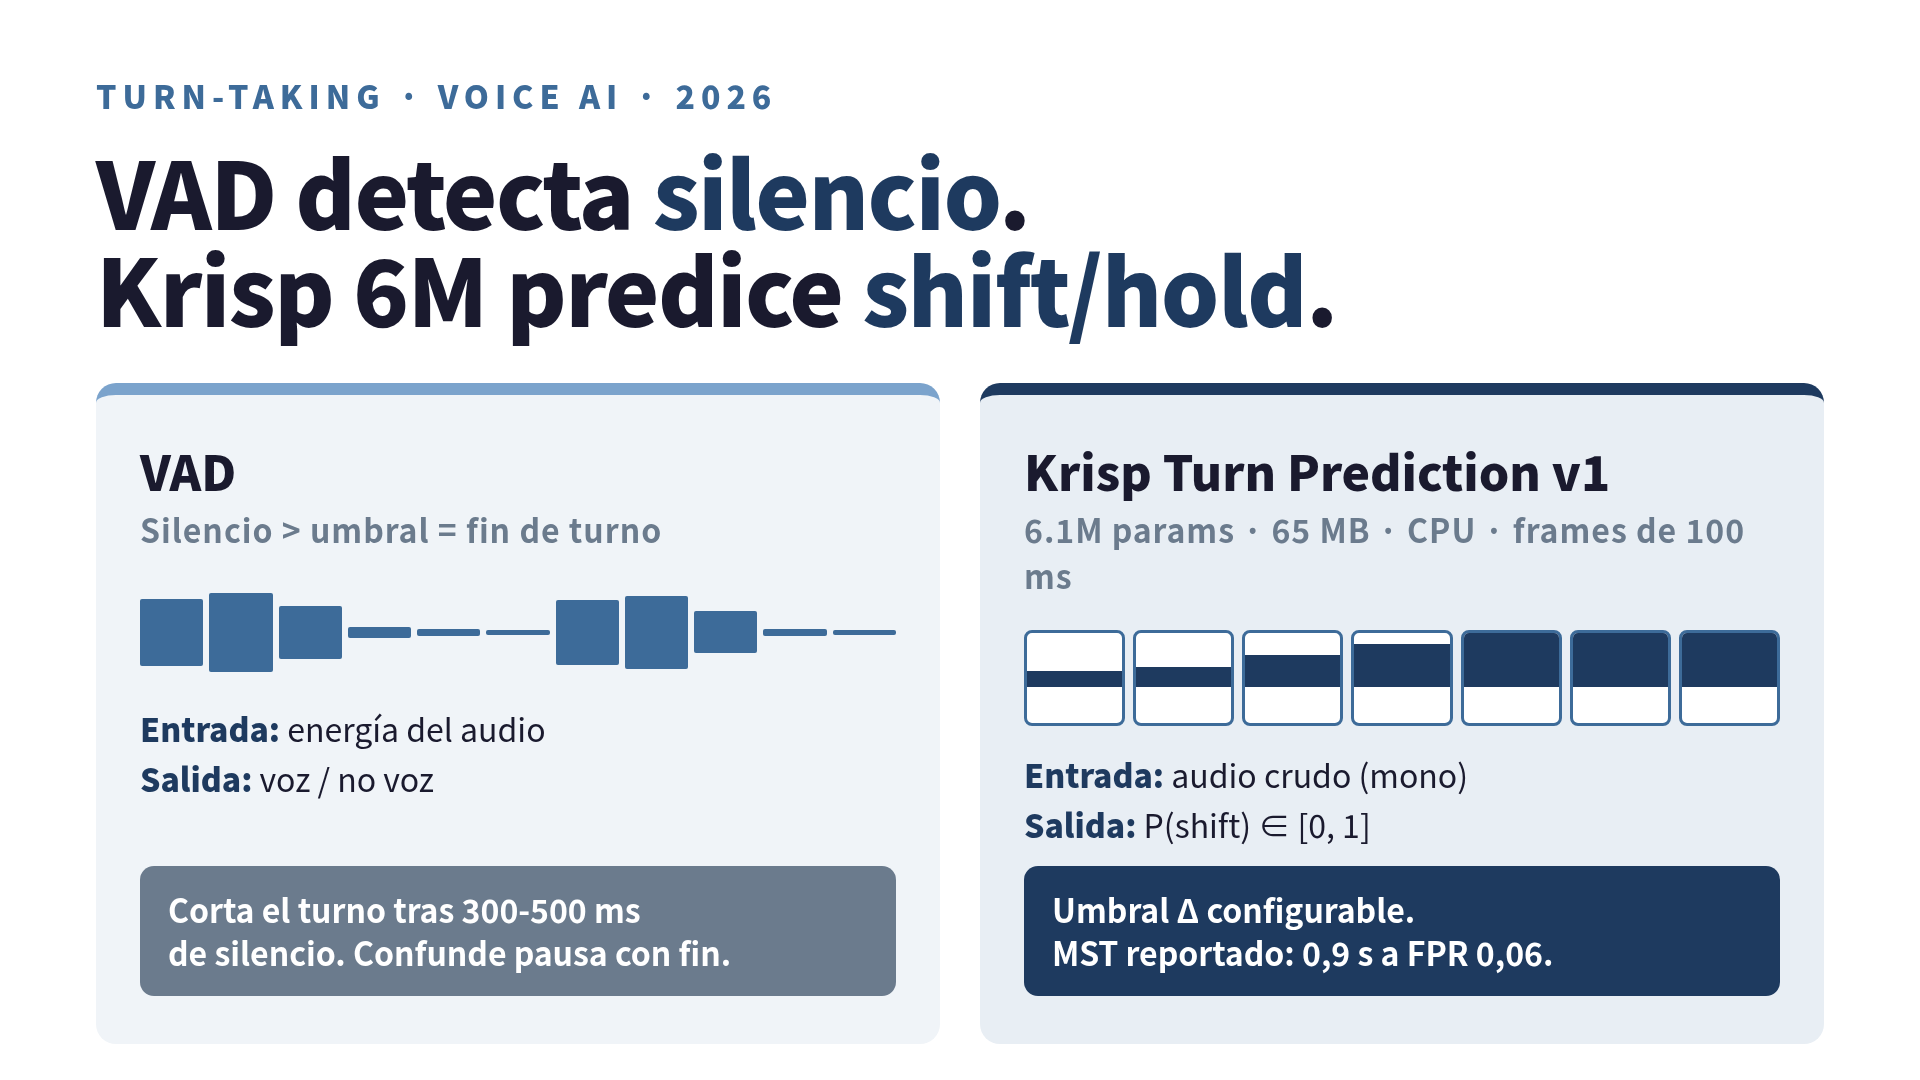
VAD (Voice Activity Detection) decide cuándo terminaste de hablar mirando una sola señal: si hay voz o no hay voz. Si el silencio dura más que un umbral (típicamente 300 a 500 ms), asume “terminó” y le pasa el turno al LLM. Es simple, se ejecuta en el cliente, y es el motivo por el que tu agente empieza a hablar cuando tú apenas hacías una pausa para pensar.
En agosto de 2025 Krisp publicó un modelo de turn-taking de 6.1M parámetros que reemplaza esa lógica: predice, cuadro a cuadro de 100 ms, la probabilidad de que hayas terminado el turno. Este post cuenta qué hace exactamente ese modelo (y qué no hace, porque hay una confusión frecuente con otro modelo del mismo vendor), y qué implica al integrarlo en un agente pensado para LatAm.
El problema real: 200 ms vs 700-1000 ms
La brecha se puede medir. La survey de ACL IWSDS 2025 sobre turn-taking en diálogo hablado reporta que el intervalo humano típico entre “termino yo” y “empiezas tú” está alrededor de 200 ms, mientras que los agentes conversacionales actuales tardan 700 a 1000 ms en tomar el turno. Tres a cinco veces más lento que el interlocutor humano.
El problema no es solo latencia técnica del stack STT + LLM + TTS. Aunque bajes cada componente al mínimo (tema que ya toqué en Anatomía de la latencia en agentes de voz), el detector de fin de turno introduce su propia demora antes de que la carrera empiece. Si esperas 500 ms de silencio para dar por cerrado el turno, ya no hay pipeline que te salve.
Y si el usuario dice “eh… a ver…”, el VAD tampoco distingue entre una pausa pensativa y un turno cerrado. Corta cuando no debe.
Qué hace y qué no hace el VAD
Los VAD más usados en producción (Silero, WebRTC VAD, Deepgram VAD) hacen bien una cosa concreta: separan voz de ruido de fondo con muy poca latencia y sin acceso al contenido. Eso los vuelve indispensables en la primera capa del pipeline (activar STT, cortar audio silencioso, filtrar tos).
Lo que no hacen:
- distinguir una pausa a mitad de frase de un fin de turno,
- separar “eh…” (relleno) de “eh, sí.” (respuesta corta),
- reaccionar a la entonación descendente que en muchos idiomas marca el cierre.
En LatAm se agrega un problema extra que raramente aparece en papers en inglés: el patrón entonacional del español rioplatense o del castellano mexicano cierra turnos con una curva prosódica muy distinta, y el usuario habla más rápido en promedio. Los umbrales de VAD calibrados para inglés US recortan turnos al medio con más frecuencia. El blog de Krisp no publica breakdown por país ni por variedad de español, así que la disciplina básica al trabajar con audio en español es medir el falso positivo (turnos cortados) contra grabaciones reales antes de aceptar el default de cualquier vendor.
Qué hace Krisp Turn-Taking v1
El blog post de Krisp del 5 de agosto de 2025 describe el modelo con precisión que vale la pena leer directamente. Los datos concretos, para no repetir errores que circulan en blogs de terceros:
| Especificación | Valor |
|---|---|
| Parámetros | 6.1M weights |
| Tamaño del modelo | 65 MB (no 24 MB) |
| Ejecución | CPU, no requiere GPU |
| Frame de inferencia | 100 ms |
| Entrada | Audio (mono, sin transcripción) |
| Salida | Probabilidad de shift, valor continuo entre 0 y 1 |
| Duración máxima de hold | 5 segundos (default) |
El punto clave que hay que retener: la salida es un solo escalar entre 0 y 1, la probabilidad de que el turno esté por cambiar (shift) versus continuar (hold). No emite cuatro estados, no clasifica “pausa reflexiva”, no distingue muletillas. Es un predictor binario con umbral configurable.
Cita textual del post oficial que aclara el mecanismo:
“The model is designed such that, during uninterrupted silence, the confidence score gradually increases and reaches a value of 1 precisely at the end of this maximum hold period.”
Es decir: durante silencio continuo, la confianza sube monótonamente hasta llegar a 1 exactamente al terminar los 5 segundos de hold máximo. Tú eliges el umbral Δ. Si pones Δ = 0,5 el modelo va a declarar shift más rápido (respuesta ágil, más falsos positivos). Si pones Δ = 0,8 va a ser más paciente. Es la palanca principal de tuning.
Krisp reporta un Mean Shift Time de 0,9 segundos contra 1,3 s del competidor SmartTurn v2, a false positive rate = 0,06, y siendo 5 a 10 veces más chico en parámetros. Ese número, 0,9 s, no es la latencia end-to-end de tu agente; es cuánto tarda el detector en decir “shift” desde que el usuario terminó. Resta eso del presupuesto y verás cuánto queda para STT + LLM + TTS.
Turn-Taking no es Interrupt Prediction
Este es el equívoco que aparece una y otra vez en blogs cross-postados. Krisp tiene dos modelos distintos que se confunden:
| Turn Prediction v1 | Interruption Prediction v1 | |
|---|---|---|
| Qué predice | Cuándo empezar a hablar (fin de turno del usuario) | Si una intervención del usuario mientras habla el agente es interrupción real o backchannel (“ajá”, “claro”) |
| Parámetros | 6.1M | ~6M |
| Tamaño SDK | 65 MB | 24 MB |
| Frame | 100 ms | 40 ms |
| Idiomas | No publicado en el blog v1 | Solo inglés (v1) |
| Salida | Probabilidad de shift | Probabilidad de interrupción genuina |
Los dos suelen aparecer en el mismo diagrama de arquitectura y se lanzan como parte del mismo SDK (Krisp VIVA), pero son componentes separados que resuelven problemas distintos.
Si ves en algún lado “Krisp 6M de 24 MB para turn-taking”, es que se está mezclando el tamaño del modelo de interrupción con el de turn-taking. Los 24 MB son del clasificador de interrupciones. El de turn-taking pesa 65 MB. La diferencia importa cuando estás dimensionando memoria en un edge box.
Integración práctica en un stack LatAm
Krisp VIVA se expone como SDK server-side. En Pipecat, LiveKit Agents y en el propio Turn Detection Layer de Deepgram/Cartesia, el modelo suele estar detrás de un TurnDetection que emite eventos speech_started / speech_ended en lugar de eventos VAD crudos. La sustitución es local: sigues teniendo VAD para el gating inicial (activar/desactivar el STT) y agregas el turn-taking arriba para decidir cuándo entregar el turno al LLM.
Un pipeline típico queda así:
audio → VAD (gate) → STT streaming → Krisp Turn Prediction → LLM streaming → TTS streaming
                                              ↑
                                    umbral Δ configurable
El VAD sigue haciendo su trabajo (evitar gastar cómputo cuando hay silencio total), y el turn-taking decide cuándo cerrar el turno con criterio acústico. Los dos componentes viven juntos, no se sustituyen.
Para equipos en LatAm hay que sumar dos consideraciones que no vienen en el post de Krisp:
- Región de inferencia. Krisp se ejecuta en CPU, así que se puede desplegar cerca del endpoint de STT sin depender de una GPU con GPU-hours regionales. Un agente que atiende desde São Paulo o Ciudad de México a US-East ya paga 100 a 150 ms de RTT antes de nada; sumar 900 ms de shift time del modelo de turn-taking encima lo deja pegado al techo de 1 s. Conviene poner el turn-taking del lado STT, no del lado LLM.
- Base de test. Los benchmarks de Krisp usan un dataset propio (1.875 audios etiquetados manualmente como shift o hold, según reporta el blog v1). No hay corte por variedad de español ni por país. Antes de aceptar Δ = 0,5 como default en producción, mide contra grabaciones de tus propios usuarios: entre audio en español mexicano y argentino, la curva prosódica del cierre de turno cambia por el hábito de dejar entonación descendente prolongada, y el default del vendor no necesariamente es el óptimo para tu variedad.
Alternativas: Deepgram Flux y VAP académico
Krisp no es la única propuesta. Dos alternativas relevantes según qué compromiso quieras:
- Deepgram Flux (parte de la plataforma Deepgram) combina detección de turno con transcripción semántica: mira tanto el audio como el texto en construcción y usa contexto lingüístico para decidir si el turno está incompleto. Ventaja: capta el “cuando quieras…” que un modelo audio-only puede confundir con final. Desventaja: acopla turn-taking a un vendor de STT.
- Voice Activity Projection (VAP) es la línea académica publicada en 2022 y con extensiones multilingües en 2024. Predice actividad futura de voz sobre horizontes de 2 s en lugar de solo la decisión binaria de shift. Es más rica pero más pesada, no está en producción SDK todavía.
Krisp Turn Prediction v1 es el punto de equilibrio actual para producción: audio-only, multilingüe, CPU, tamaño manejable y con un blog post técnico que documenta el mecanismo (raro en este espacio).
El VAD no se muere
Un error que veo en decks de “voice AI 2026” es pintar el turn-taking model como el reemplazo del VAD. No lo es. El VAD sigue siendo la primera compuerta que decide si vale la pena activar el STT y el modelo de turn-taking. Sin él, la CPU del modelo de 6M parámetros se pasa la noche mirando ruido de aire acondicionado.
La arquitectura correcta es en capas: VAD abajo (rápido, barato, ruido/voz), turn-taking arriba (más caro, semántico acústico, shift/hold). Cada uno hace lo que sabe. El sueño de “un solo modelo que hace todo” es lo mismo que en cualquier otro dominio: sale más caro y menos preciso que dos capas especializadas.
Qué recordar
- El VAD detecta silencio, no fin de turno. Esas dos cosas se parecen solo hasta que el usuario dice “eh…”.
- Krisp Turn Prediction v1 emite una probabilidad continua entre 0 y 1, no cuatro estados. La palanca de tuning es el umbral Δ.
- El modelo pesa 65 MB (no 24 MB, que es el otro modelo, el de interrupciones).
- MST reportado ~0,9 s a FPR 0,06 sobre el dataset propio de Krisp. Antes de aceptarlo, mide contra audio de tus usuarios.
- VAD y turn-taking conviven, no se reemplazan.
Si vas a integrar voice AI en LatAm en 2026, el orden que yo seguiría es: primero medir la latencia real end-to-end como cuento en 5 stacks de voice AI y solo 2 bajaron los 300 ms, después decidir si el detector de fin de turno es el cuello de botella (a menudo lo es), y recién ahí sumar Krisp o Flux al pipeline. Cambiar de VAD a turn-taking model sin haber medido primero es tocar el motor sin saber si el problema estaba en las ruedas.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev
¿Te resultó útil este artículo?