Code review en pytest: mediana 9.2h, no 284.6h
Reporto el promedio y el equipo parece catastrófico. Reporto la mediana y todo parece normal. Son los mismos PRs. Me pasó cuando bajé los datos de pytest-dev/pytest para medir el Time to First Review:
- Promedio: 284.6 horas (casi 12 días)
- Mediana: 9.2 horas (lo que dura una jornada laboral)
Los dos salen de los mismos 107 PRs humanos de 90 días. La aritmética está bien; 5 PRs viejos se llevan el 66 % del tiempo total de espera.
Este artículo es el registro de qué pasa cuando mides las 5 métricas típicas de code review en dos repos públicos (pytest y pydantic) y las lees sin que el promedio te engañe. No son los números de mi equipo: para eso necesitaba más PRs de los que tiene mi repo personal, así que bajé datos públicos.
Lo que medí
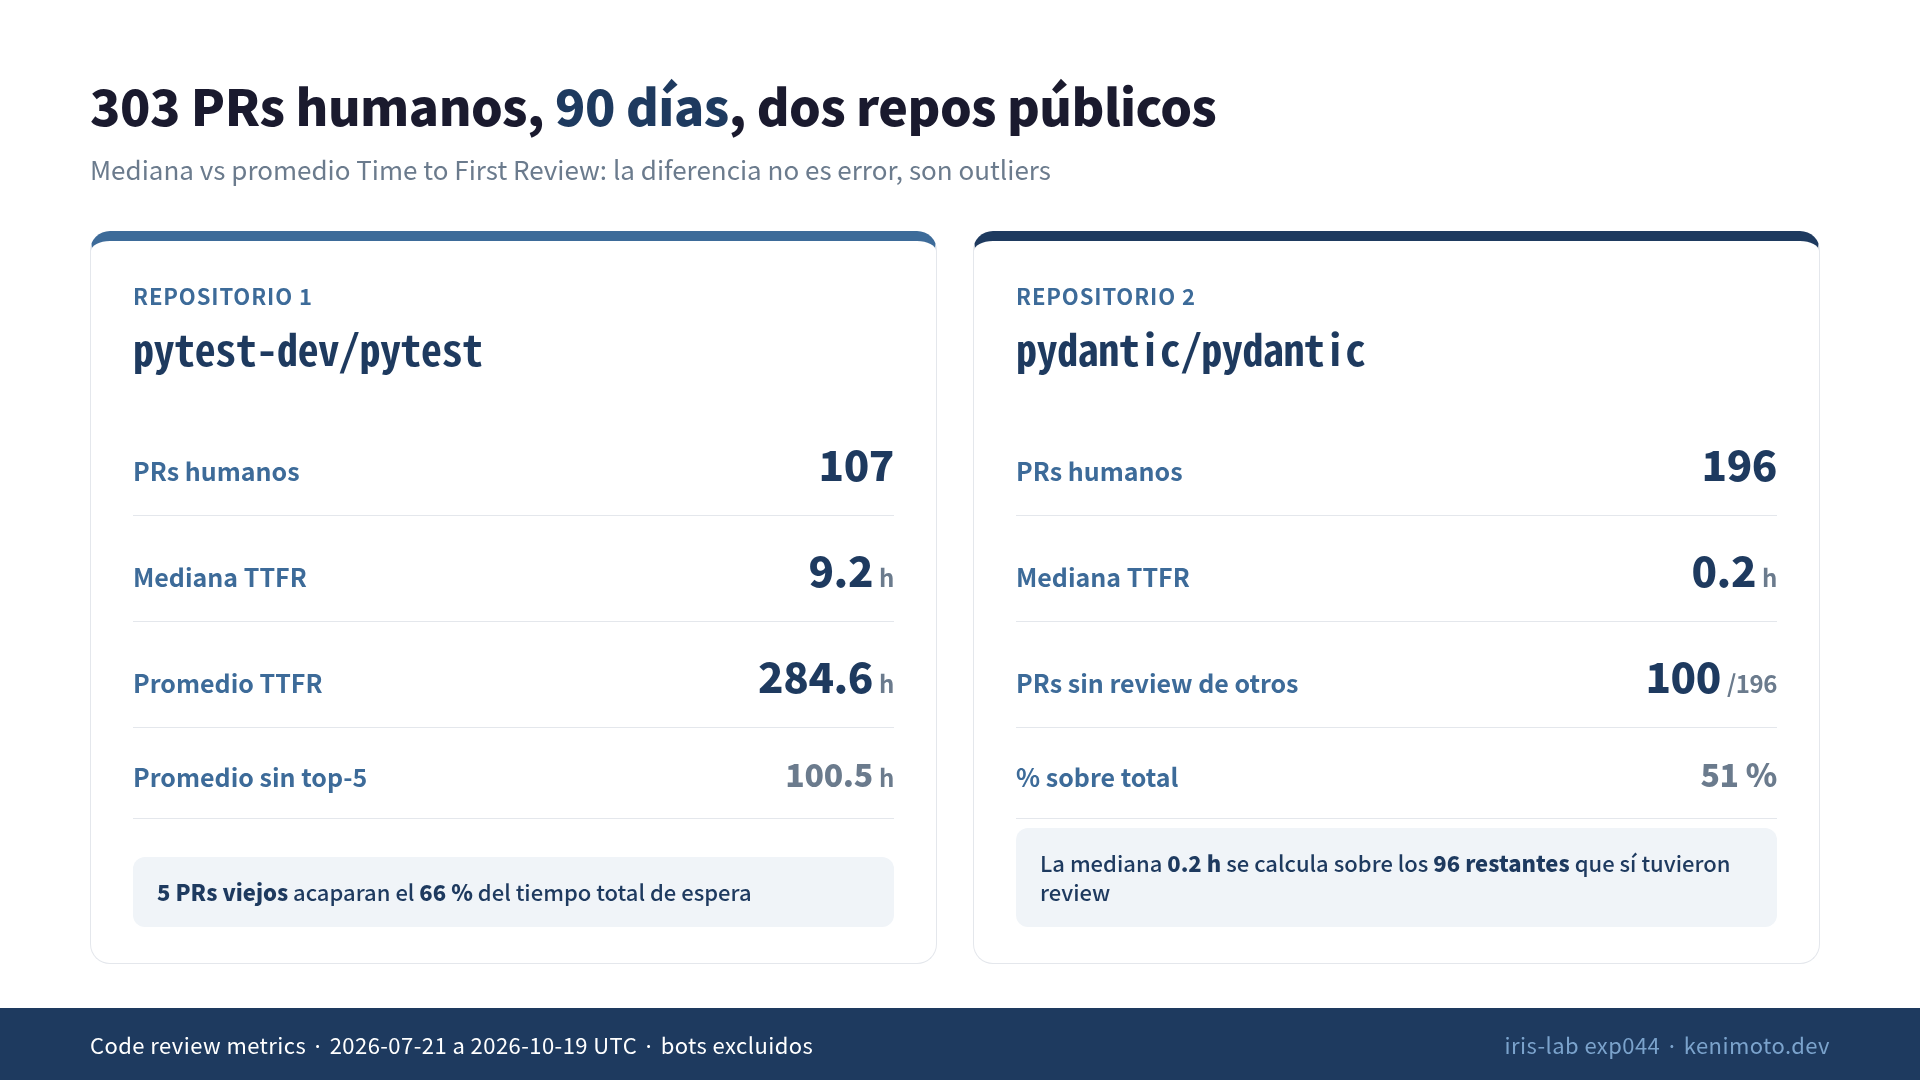
| Repo | PRs humanos | Mediana TTFR | Promedio TTFR | PRs sin review de otros |
|---|---|---|---|---|
| pytest-dev/pytest | 107 | 9.2 h | 284.6 h | 0 |
| pydantic/pydantic | 196 | 0.2 h | — | 100 (51 %) |
Bots excluidos. Período: 2026-07-21 al 2026-10-19 UTC. Script completo en el experimento 044 de iris-lab.
Dos lecturas obvias si te quedas con el titular:
- “pytest tarda 12 días en revisar” (promedio).
- “pydantic revisa en 12 minutos” (mediana de pydantic).
Las dos son ciertas y ninguna sirve para decidir nada. Vamos por qué.
pytest: 5 PRs viejos acaparan el 66 % del tiempo
Cuando el promedio y la mediana están a 30x de distancia, hay outliers tan grandes que doblan la aritmética. Llamarlo “distribución pesada” se queda corto. Los 5 PRs con mayor Time to First Review en pytest fueron:
5568 h  (232 días)
5415 h  (225 días)
4261 h  (177 días)
3305 h  (138 días)
1650 h  ( 69 días)
Suma: 20 199 horas. Suma total de los 107 PRs: 30 452 horas. Los 5 PRs viejos se comen el 66.3 % del tiempo de espera agregado.
Si los quito del cálculo:
- Promedio sin top-5: 100.5 h (bajó de 284.6 a 100.5, 65 % menos)
- Mediana: 9.2 h (igual — por eso existe la mediana)
El patrón es común en OSS: PRs que nadie quiere integrar, que no se cierran “por si acaso” y que suman cientos de días hasta que alguien escribe “closing stale”. El promedio los paga en cada reporte semanal; la mediana los ignora.
Cuándo usar cuál:
- Mediana para “¿cuánto tarda un PR típico?” (el que verás esta semana).
- Promedio para “¿cuánto tiempo-persona está parado el equipo?”: presupuesto, no experiencia.
- Promedio sin top-5 para “¿cuánto tarda si quito los PRs que ya nadie va a integrar?” (más útil que el promedio puro cuando el repo tiene cola).
Reportar solo el promedio en la reunión diaria es declarar al equipo culpable de 2 PRs olvidados. Reportar solo la mediana es ocultar los 2 PRs que llevan 200 días bloqueados.
pydantic: la mitad merge sin review de otros
El dato más incómodo del experimento salió de pydantic:
- 196 PRs humanos
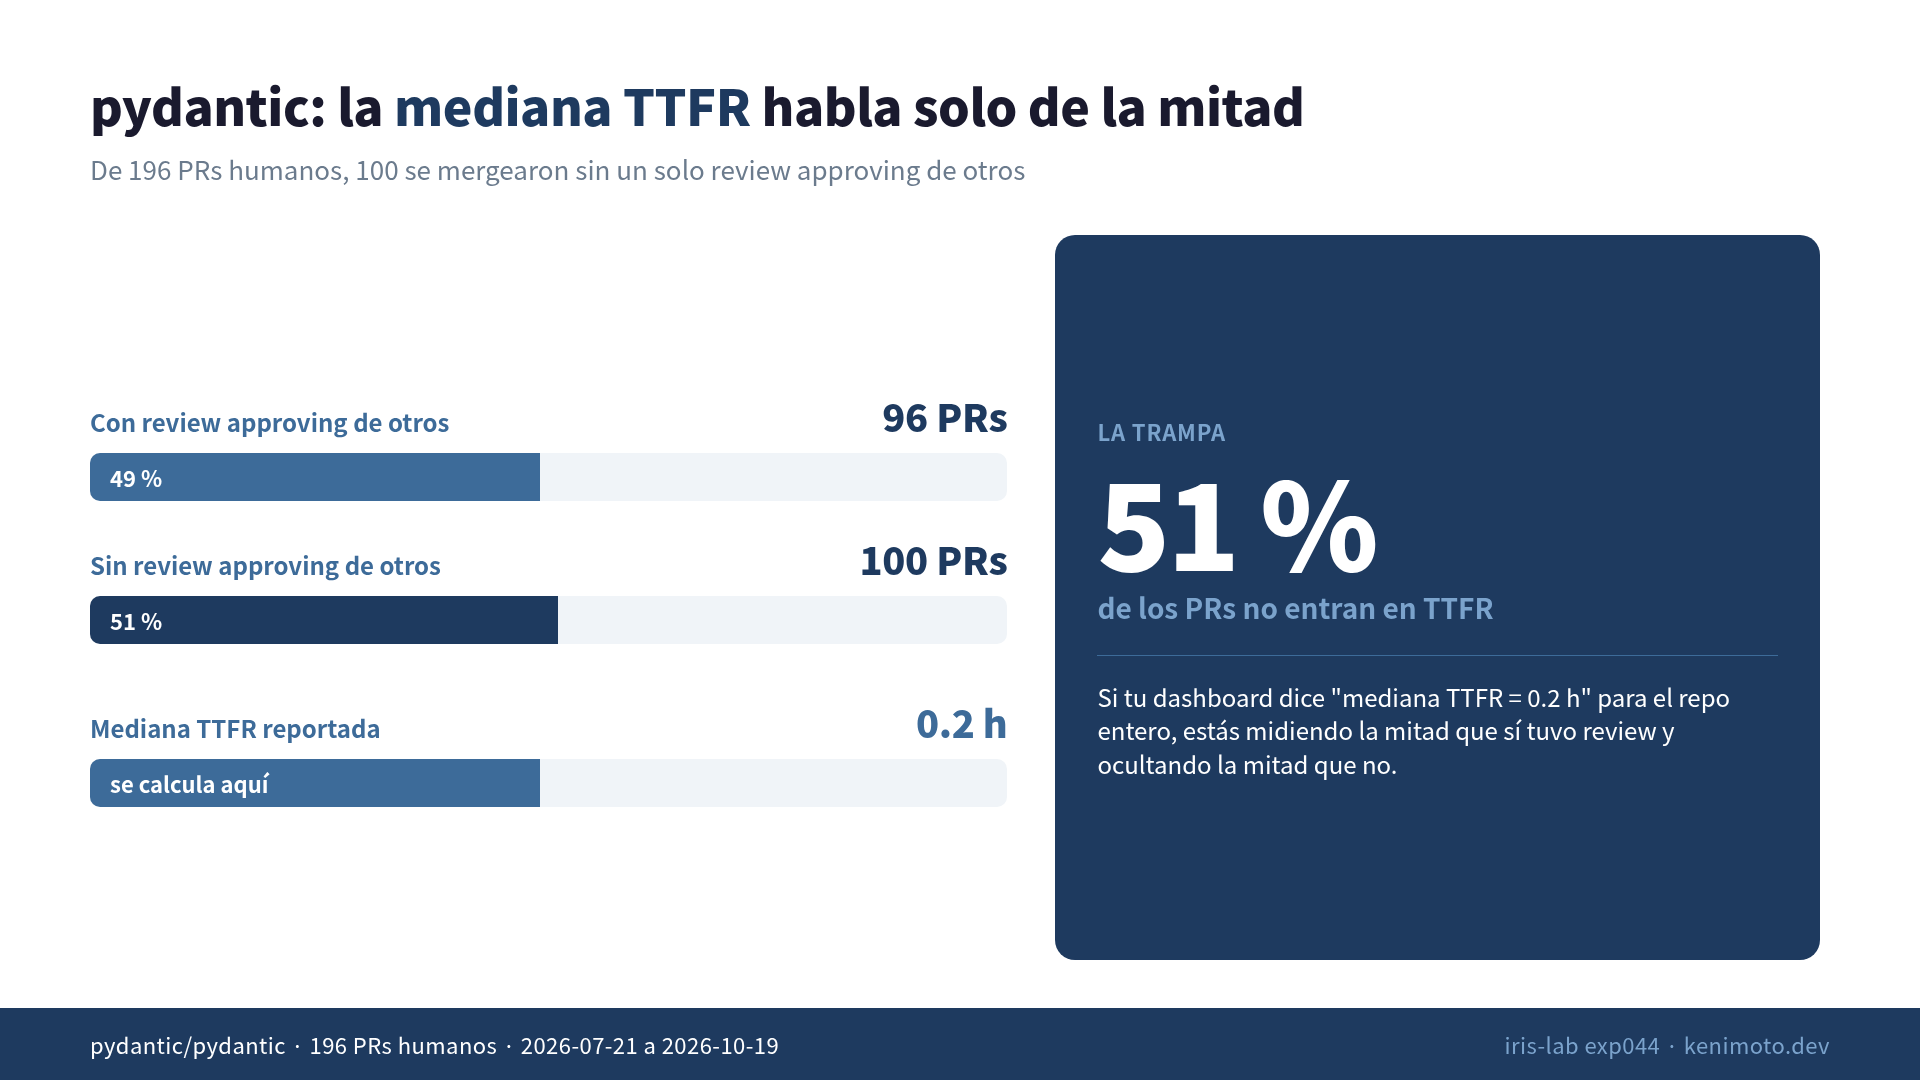
- 100 (51 %) se integraron sin un solo review aprobatorio de alguien que no fuera el autor
La “mediana TTFR = 0.2 horas” sale de los 96 PRs restantes: los que sí tuvieron review. Si lees la métrica sin saber esto, concluyes “pydantic revisa en 12 minutos”. La realidad es “pydantic revisa en 12 minutos cuando revisa, y la mitad no revisa”.
Esto no es un juicio sobre pydantic. Un maintainer con permisos de merge decide que ciertos cambios no necesitan segunda opinión: típicamente docs, preparación de release, dependabot manuales, deshacer un commit. Pero sí es un dato que tu panel de métricas tiene que mostrar separado:
| Tipo de PR | Mediana TTFR |
|---|---|
| PR con review aprobatorio de otros | 0.2 h (sobre 96 PRs) |
| PR sin review de otros | — (no aplica, no hubo first review) |
Si tu panel dice “mediana TTFR = 0.2 h” para el repo entero, estás midiendo solo la mitad.
Dónde se gasta el tiempo entre PR abierto y merge
Para los 107 PRs de pytest, descompuse el Time to Merge en 3 tramos:
- A: desde PR abierto hasta el primer review de otros
- B: desde el primer review hasta la aprobación
- C: desde la aprobación hasta el merge
| Tramo | % del tiempo total | PRs donde fue el tramo más largo |
|---|---|---|
| A — esperando primer review | 35 % | 44 |
| B — ida y vuelta de review | 49 % | 29 |
| C — mergeando ya aprobado | 16 % | 34 |
La intuición común es “lo que mata el flujo es que nadie revisa” (tramo A). Los datos de pytest dicen otra cosa: el tramo B (ida y vuelta) consume más del total que A. Una vez empieza la conversación, el PR gasta más días hablando que esperando.
Para los 34 PRs cuyo tramo más largo fue C (ya aprobado, esperando merge), la lectura es distinta: hubo review rápido, hubo aprobación rápida, pero algo (CI roto, conflicto con main, el autor estaba de vacaciones) retrasó el merge. Estos PRs no necesitan “más revisores”: necesitan destrabar el camino al merge.
Si tu equipo mide un solo número y es “Time to First Review”, estás ignorando el 65 % de donde se va el tiempo.
Comments por PR y Review Cycles: la correlación con el tamaño
Dos correlaciones de Spearman del mismo conjunto de datos de pytest:
- Comments por PR ↔ líneas cambiadas: ρ = 0.53 (moderada-alta)
- Review Cycles ↔ líneas cambiadas: ρ = 0.19 (débil)
Lectura concreta: los PRs grandes sí reciben más comentarios inline (lo esperable), pero no disparan más ciclos de review. Los ciclos los dispara el tipo de cambio, no el tamaño. Un PR de 10 líneas que toca el core puede tener 4 ciclos; uno de 500 líneas que renombra variables puede tener 1.
Dato extra: el 63 % de los PRs de pytest tienen 0 comentarios inline. “Zero inline comments” no significa “aprobado sin pensar”: en muchos casos la discusión ocurre en el hilo general del PR o fuera (Discord, email). Pero sí significa que si tu política dice “todo PR debe tener comentarios inline”, el 63 % de los PRs de un proyecto maduro violan esa política.
Qué cambiar en el panel de tu equipo
Si tu equipo mide Time to First Review hoy, probablemente mide una sola de las cosas que importan. La lista corta de lo que valdría sumar, basada en lo que vi en pytest y pydantic:
- Mediana y promedio por separado, nunca uno solo. Si el promedio es > 5x la mediana, hay cola de PRs viejos; repórtalos aparte.
- Promedio sin top-5 cuando el repo tiene más de 50 PRs. Da la base real.
- % de PRs integrados sin review de otros. Si es > 20 %, tu “mediana TTFR” habla de la minoría.
- Descomposición de Time to Merge en 3 tramos (A/B/C) para ver dónde se va el tiempo. No asumas que es “nadie revisa”.
- Correlación comments ↔ size y cycles ↔ size separadas, porque tu política de reviews probablemente mezcla las dos.
Lo que no medí (y por qué)
- AI Resolution Rate (porcentaje de comentarios resueltos por el autor sin discusión adicional). GitHub REST no expone el estado resolved/unresolved de un hilo de review en el campo público. Habría que hacer scraping de GraphQL o del HTML del PR.
- Mi propio equipo. Mi repo personal (kenimo49) tenía 8 PRs en 90 días: insuficiente. Por eso bajé pytest y pydantic. Esto es una observación de dos proyectos OSS populares, no la métrica de un equipo privado.
- Repos privados comparables. No tengo acceso a datos de empresas que me den consentimiento para publicar. Si tu equipo quiere comparar, el script del experimento corre contra cualquier repo accesible por
gh api. - Causalidad. “Spearman 0.53 entre comments y size” no dice “PRs grandes causan más comentarios”. Dice “cuando uno es alto, el otro tiende a serlo también”. El experimento no diseña intervención, solo describe lo que hay.
Cómo reproducir con tu repo
El script completo son 2 archivos: review_metrics.py (5 métricas) y analyze.py (descomposición y correlaciones). Dependencias: PyGithub + variable GITHUB_TOKEN + Python 3.11+.
git clone https://github.com/kenimo49/iris-lab
cd iris-lab/experiments/044-pr-review-metrics-pytest-pydantic
export GITHUB_TOKEN=...
python3 review_metrics.py owner/repo > tu-repo-output.txt
python3 analyze.py owner__repo.json > tu-repo-analysis.txt
Si tu repo privado tiene menos de 30 PRs integrados en 90 días, los percentiles son ruido; amplía la ventana a 180 o 365 días.
La próxima vez que alguien me enseñe un dashboard con solo un promedio, voy a preguntar por los 5 PRs que decidió no graficar. Suele ser ahí donde está el 66 %.
Para los números de un segundo artículo relacionado, los revisores de las 3pm aprueban casi 0 %; también de datos públicos, mismo enfoque.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev
¿Te resultó útil este artículo?