Self-Evolving Agents: 4 pasos del feedback loop
Hay una tentación cuando uno monta su primer agente útil: dejarlo congelado. Funciona hoy, pasa los tests, deja de tirar errores. Lo firmas en producción, te vas a dormir tranquilo. Dos semanas después vuelve exactamente el mismo bug que supuestamente ya habías arreglado en junio.
OpenAI publicó una guía en su Cookbook oficial pensando en eso, Self-Evolving Agents — A Cookbook for Autonomous Agent Retraining. La idea central es un bucle de retroalimentación que lleva al agente de “requiere correcciones detalladas” a “basta con supervisión de alto nivel”. La trampa es que el ejemplo publicado está especializado en un dominio muy puntual, y si copias los graders tal cual te vas a quedar con un agente que evalúa aire.
Desarmo la guía en 4 pasos, y separo qué parte viaja entre dominios y qué parte no.
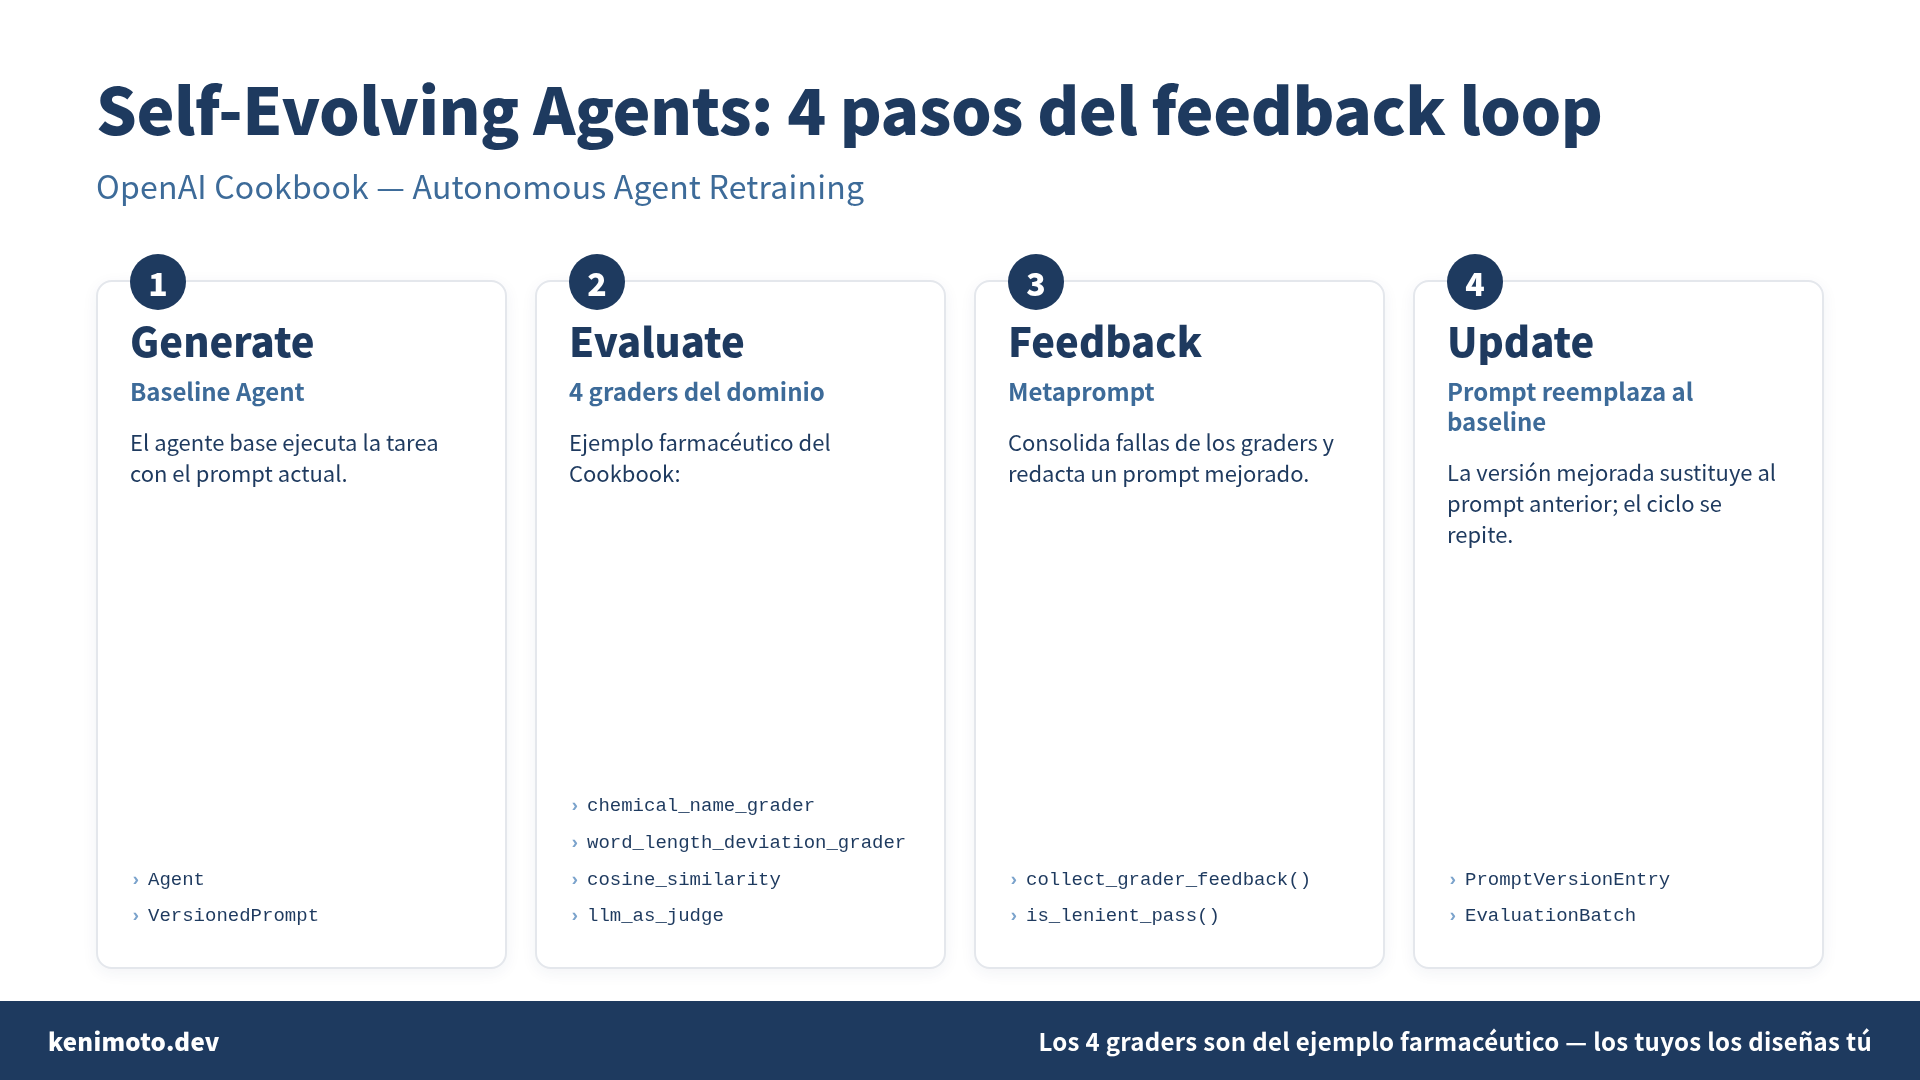
Los 4 pasos del feedback loop
El Cookbook define el ciclo así:
- Baseline Agent (Generate). Un agente base ejecuta la tarea. En el ejemplo oficial, resume secciones de documentos regulatorios para una solicitud FDA de medicamentos (el caso de prueba es una inyección de piruvato hiperpolarizado).
- Graders (Evaluate). Un conjunto de evaluadores corre contra la salida del agente. El Cookbook define exactamente cuatro graders complementarios. Los veremos en detalle en un momento.
- Feedback collection (metaprompt). La función
collect_grader_feedback()consolida las razones de las fallas en guía accionable. Esa guía entra a un metaprompt que redacta una nueva versión del prompt del agente base. - Prompt update. Si la nueva versión supera el umbral, reemplaza al baseline. El código del Cookbook llama a esto
VersionedPrompt, una clase que guarda cada revisión con timestamp, eval ID, run ID y metadata. Después se vuelve al paso 1.
La definición operacional de “pasó o no pasó” tampoco es intuición. is_lenient_pass() devuelve True si el 75% de los graders aprueba o el promedio es ≥ 0.85. No es votación mayoritaria ni promedio puro; es un OR entre dos criterios. Ese detalle importa cuando un grader estricto sigue tirando False pero el promedio ya está en zona aceptable.
Hasta aquí todo viaja entre dominios. Los pasos, las clases (VersionedPrompt, PromptVersionEntry, EvaluationBatch), la función is_lenient_pass, y la cadena run_eval → poll_eval_run → parse_eval_run_output → collect_grader_feedback son reutilizables tal cual.
Lo que no viaja son los graders.
Los 4 graders del Cookbook son del dominio farmacéutico
El ejemplo publicado está especializado en documentación regulatoria de medicamentos. Los cuatro graders que define reflejan ese dominio:
| Grader | Tipo | Umbral | Qué chequea |
|---|---|---|---|
chemical_name_grader | Python rule-based | 0.80 | Que todos los nombres químicos exactos de la sección aparezcan en el resumen |
word_length_deviation_grader | Python rule-based | 0.85 | Que el resumen se mantenga en ~100 palabras |
cosine_similarity | Similitud de texto | 0.85 | Ancla el resumen al contenido fuente para evitar inventos |
llm_as_judge | Rúbrica evaluada por LLM | 0.85 | Señales cualitativas que las reglas rígidas no capturan |
Si tu dominio es, digamos, generación de respuestas de soporte técnico, un chemical_name_grader no te sirve para nada. Si es análisis de contratos, el word_length_deviation_grader a 100 palabras te va a rechazar cualquier resumen útil. Y cosine_similarity contra “el texto fuente” asume que existe un texto fuente singular; en un agente conversacional multi-turn no hay tal cosa.
El error más barato que vas a cometer con este Cookbook es copiar los nombres de los graders y creer que los estás usando. Tu chemical_name_grader pasando al 100% en un chatbot de soporte no significa nada. Pasa porque no hay nombres químicos que detectar, no porque el agente esté bien.
Qué graders diseñar en su lugar
El trabajo mental que ahorra el Cookbook es la estructura: un rule-based que chequea invariantes duras del dominio, un rule-based que mide forma (longitud, formato), un similarity que ancla a la fuente, y un LLM judge para los matices. No los nombres.
Para un agente de soporte técnico, un mapeo plausible sería:
required_code_block_grader(rule-based) — que la respuesta incluya al menos un bloque de código cuando la pregunta lo requiere.response_length_deviation_grader(rule-based) — longitud dentro del rango aceptado del canal (≤ 500 palabras en chat, ≤ 2000 en ticket).cosine_similaritycontra la base de conocimiento consultada. Esta sí viaja, porque mantiene el ancla.llm_as_judgecon rúbrica de tono + precisión + accionabilidad.
Lo importante es que los tres primeros sean chequeables sin un LLM. Si todos tus graders son LLM judges, estás pagando OpenAI dos veces por cada ciclo y abrazando una señal correlacionada con el modelo base: si el baseline que escribe es generoso con las imprecisiones, el judge que evalúa también lo va a ser, porque es el mismo modelo con otro prompt.
Las 3 estrategias de mejora del prompt
El Cookbook contrasta tres formas de cerrar el bucle en el paso 3-4:
- OpenAI Platform UI. Iteración manual con feedback humano. Rápida para prototipar, pero no automatizable.
- Static metaprompt loop. Un metaprompt fijo le dice al LLM cómo mejorar el prompt del agente base a partir del feedback de los graders. Automatiza el bucle, pero hay riesgo de overfitting al eval set. Si tu eval set tiene 20 ejemplos de resúmenes de dosis, el prompt termina sobreajustado a “escribir sobre dosis”.
- GEPA. Reflexiona sobre las trayectorias de ejecución con lenguaje natural, entrena en un subset y valida en otro. El Cookbook muestra que produce prompts más generalizables, a cambio de un pipeline más complicado.
La guía oficial no dice “usa GEPA siempre”. Dice que si tu eval set es chico (lo habitual al empezar), el static metaprompt sufre overfitting, y ahí GEPA ayuda. Si tu eval set es grande y variado, el static metaprompt alcanza.
Qué llevarse
Si tuviera que resumirlo para alguien que va a montar su primer bucle de autoevolución mañana:
- Los 4 pasos son reutilizables. Baseline → graders → feedback → metaprompt → prompt update. Esa estructura funciona para cualquier dominio.
- Los nombres de los 4 graders del Cookbook son del dominio farmacéutico. Léelos para entender cómo se combina rule-based + similarity + LLM judge, no para copiar los nombres.
is_lenient_pass(75% pasa O promedio ≥ 0.85) yVersionedPromptsí viajan. Son infra, no dominio.- Static metaprompt vs GEPA depende del tamaño del eval set. Empieza con el static si tu set es pequeño, migra a GEPA si ves overfitting.
- El bucle no está completo hasta que el último paso (prompt update) corre sin tu intervención. Si tienes que apretar “merge” cada vez, no es autoevolución, es revisión asistida con pasos extra.
El autor de este blog documentó en otra publicación en portugués el ejercicio de aplicar este patrón contra su propio harness. Es un caso específico y el aprendizaje principal fue casi todo sobre lo que el bucle no logra capturar; vale la pena leerlo si quieren contrastar la teoría del Cookbook con un harness pequeño en producción. Para el punto de partida del contexto que necesitan los agentes antes de entrar al bucle, están los 7 archivos de Claude Code para un harness mínimo.
Si hay una sola línea para quedarse: la estructura del Cookbook la pueden copiar hoy; los graders los tienen que diseñar ustedes para su dominio. Los que vinieron en la guía evalúan nombres químicos.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev
 Libro relacionado Harness Engineering Harness Engineering desde cero — cinco interpretaciones (OpenAI, Anthropic, LangChain, Martin Fowler, academia) unificadas en un solo sistema para ingenieros en producción Ver la página del libro →
¿Te resultó útil este artículo?