Harness: 4 feedback loops (seg → semanas)
Me tomó más tiempo del que me gusta admitir ordenar esta secuencia en la cabeza: Prompt Engineering → Context Engineering → Harness Engineering. La primera era se trataba de cómo pedirle algo al modelo. La segunda, de qué contexto le entregabas. La tercera, de qué entorno lo rodea — y es la que decide si el agente llega a producción o se queda en la demo.
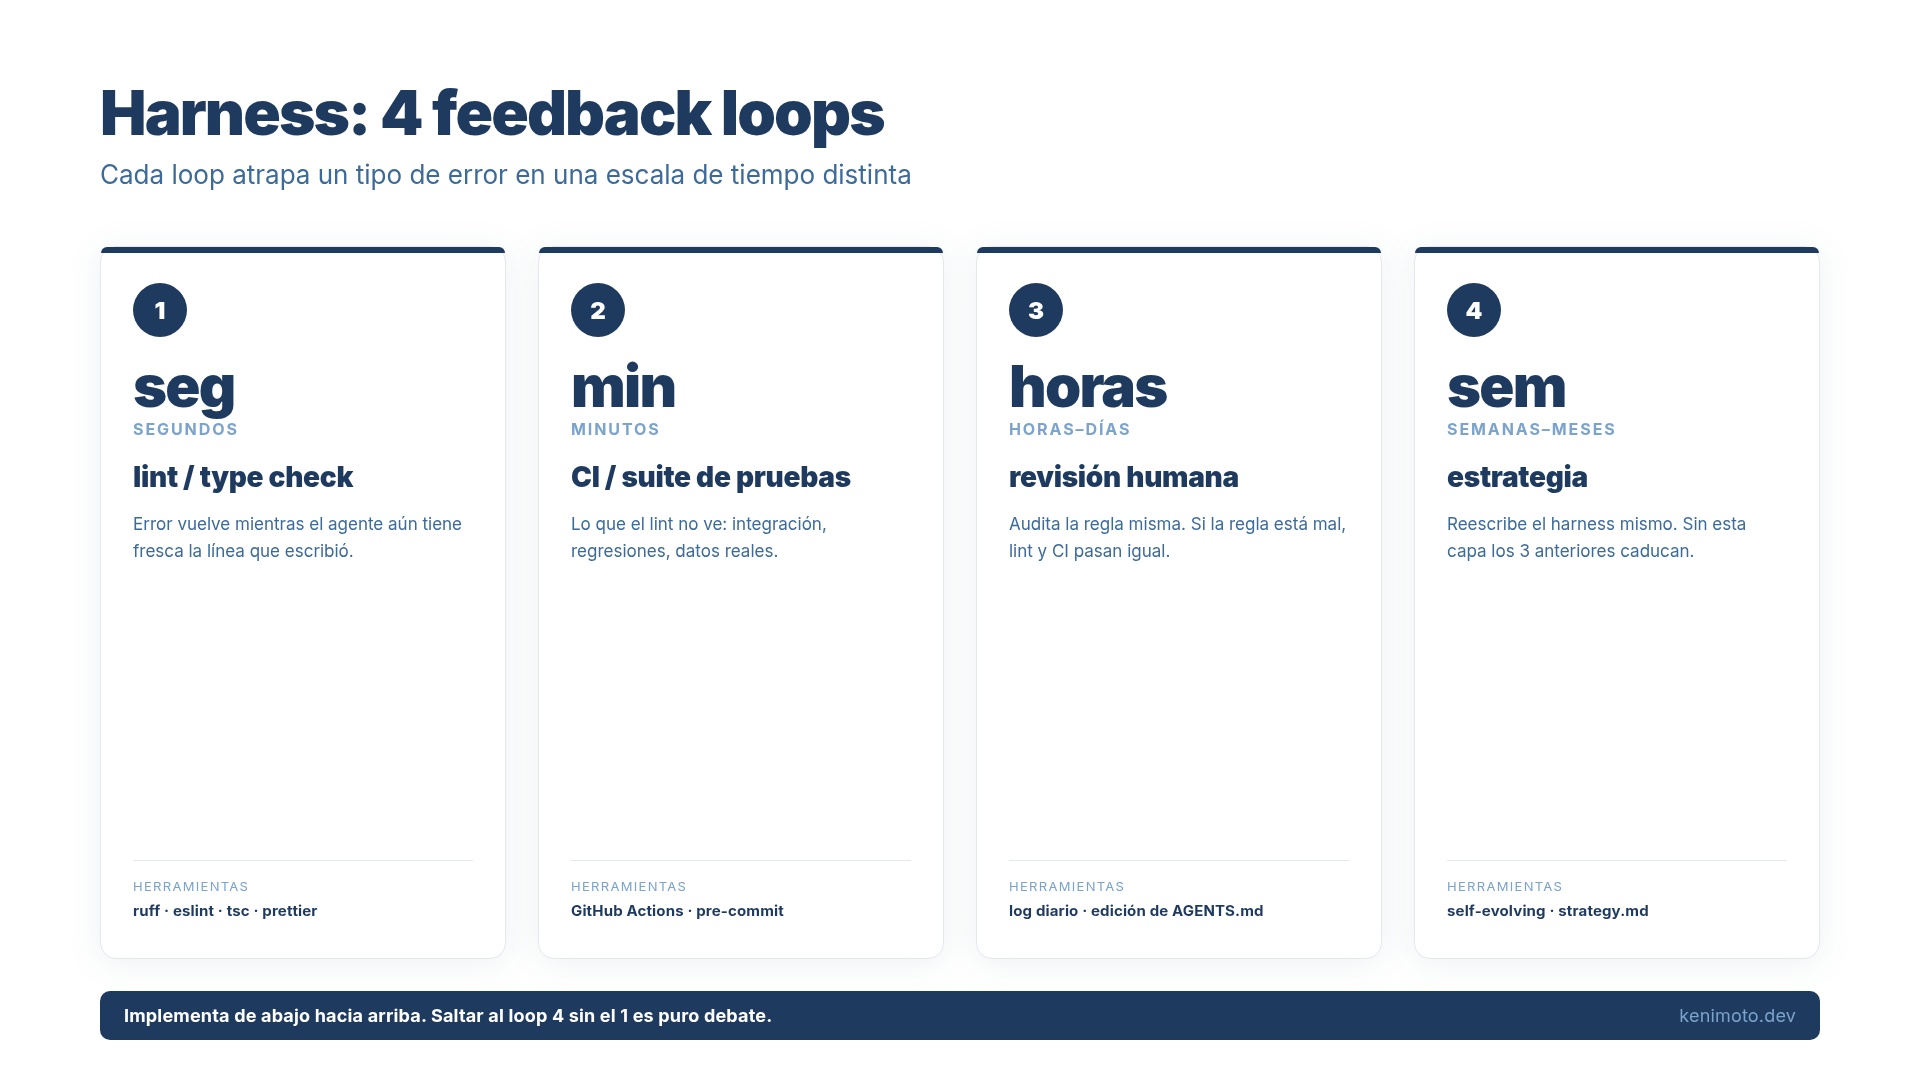
Dentro del harness, la pieza que más subestima la gente son los feedback loops. Un harness no funciona porque tiene buenos prompts. Funciona porque tiene 4 loops de feedback encadenados, cada uno midiendo el error en una escala de tiempo distinta: segundos, minutos, horas y semanas.
Si cambias cuántos loops tiene tu agente, cambias cuánto tarda en aprender de su propio error. Y eso es casi todo el juego.
Por qué los loops importan más que el prompt
SmartScope lo resumió en una frase que resuelve el debate:
Escribir “corre el linter” en CLAUDE.md y forzarlo con un Hook es la diferencia entre “casi siempre” y “sin excepción.”
CLAUDE.md / AGENTS.md son restricciones blandas. El agente las “olvida” el 10% de las veces. Los hooks son restricciones duras. 100%, sin excepción.
Los 4 loops del harness no son más que 4 maneras de convertir “casi siempre” en “sin excepción”, cada una en una escala de tiempo distinta.
Loop 1 — Segundos: lint y type check
El loop más corto se dispara justo después de que el agente escribe una línea.
Herramientas típicas:
ruffoeslintpara estilotsc --noEmitomypypara tiposprettieroblackpara formato
Se engancha fácil: un PostToolUse hook en Claude Code que ejecute el linter cuando el agente edita un archivo. El error vuelve en 3 segundos.
Esa latencia corta no es decorativa. El agente todavía tiene fresca en memoria la línea que acaba de escribir. Si el error llega 10 minutos después (cuando ya cambió de tarea), el costo de repararlo se multiplica. No es por capacidad del modelo, es por economía de atención.
Este loop atrapa errores sintácticos y de tipo. No atrapa nada estructural — pero es la base sobre la que se apoyan los otros tres.
Loop 2 — Minutos: CI y suite de pruebas
El segundo loop corre al final de la tarea, no de cada línea.
Herramientas típicas en equipos LatAm:
- GitHub Actions con la matriz de tests
pytestovitestejecutados localmente porpre-commit- Un checker de ligaduras / smoke test de integración
Lo que atrapa es lo que el lint no ve: una función que pasa el type check pero rompe cuando la llamas con datos reales. Integración entre módulos. Regresiones en flujos que el agente no sabía que existían.
El error más común en este loop no es técnico, es de diseño. Hooks demasiado ruidosos (100+ invocaciones por semana es mi umbral de alerta) terminan ignorados o deshabilitados. Si la mayoría de las invocaciones son triviales, el loop se corrompe. Hay que medir la señal contra el ruido, no solo si el loop “está activo.”
Loop 3 — Horas a días: revisión humana
Aquí entra el humano.
El agente deja un log de sus decisiones (qué eligió, por qué, qué dato leyó), y una persona lo revisa a diario o cada pocos días. En mi harness yo mismo ejecuto esto: cada mañana reviso lo que escribió el agente el día anterior y, si la regla parece torcida, edito el AGENTS.md.
Lo que atrapa este loop es lo que los dos primeros no pueden ver: si la regla misma está mal. Un linter revisa que el código cumpla la regla. El CI revisa que las funciones se comporten. Ninguno de los dos sabe si la regla era la correcta.
Una advertencia: este loop se pudre si no defines con qué frecuencia lo abres. “Lo revisamos cuando podemos” es la fórmula para no revisarlo nunca. Yo separo “mirar rápido” (diario) de “sentarme a leer” (semanal). Cada equipo tiene su cadencia; lo que no vale es no tenerla.
Loop 4 — Semanas a meses: estrategia
El loop más largo reescribe el harness mismo.
Lo que cambia aquí:
- Reglas estratégicas (qué temas trabaja el agente, cuáles no)
- Estructura del harness (qué hooks agregar, qué skills eliminar)
- Métricas de éxito (qué KPI mirar, qué CTR es “normal”)
En mi repo harness-ops tengo una skill “self-evolving” (por ahora corriendo en cron solo para el dominio Dev.to, los sábados a las 09:00) que lee los logs de la semana y me propone cambios al strategy.md. La notificación llega a Telegram y yo apruebo o rechazo desde CLI. Esa pequeña fricción (ken revisa, ken aprueba) es intencional: el loop 4 no debería ser automático en los dos sentidos.
Sin este loop, los tres anteriores se vuelven obsoletos en meses. Las reglas que escribiste en agosto ya no describen la realidad de noviembre, y nadie se da cuenta porque el linter y el CI siguen pasando.
El orden de implementación importa
Un patrón de falla común: intentar montar los 4 loops a la vez. No funciona.
El orden correcto es de abajo hacia arriba:
- Primero el lint (loop 1). Es barato, se engancha solo, y si no está, los otros loops no sirven de nada
- Después CI / tests (loop 2). Captura lo que el lint deja escapar
- Después revisión humana (loop 3). Solo tiene sentido si las dos capas automáticas ya atrapan lo mecánico
- Al final, el loop estratégico (loop 4). Requiere datos de los tres de abajo para ser útil
Si saltas al loop 4 primero — “vamos a revisar la estrategia cada semana” — pasas semanas discutiendo decisiones que un linter hubiera atrapado en segundos. Es el síntoma típico de priorizar la reunión sobre la automatización.
Resumen
Un harness no se diferencia por tener mejores prompts. Se diferencia por tener 4 sensores de error, cada uno escuchando en una banda de frecuencia distinta.
- Loop 1 (segundos): lint, type check, formato. Costo barato, cobertura amplia
- Loop 2 (minutos): CI, tests, integración. Captura lo que el lint no ve
- Loop 3 (horas-días): revisión humana. Audita la regla misma
- Loop 4 (semanas-meses): estrategia. Reescribe el harness
Cuando los 4 están en su lugar, “casi siempre” (90%) se convierte en “sin excepción” (100%). Ahí es donde empieza el harness de verdad.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev
 Libro relacionado Harness Engineering Harness Engineering desde cero — cinco interpretaciones (OpenAI, Anthropic, LangChain, Martin Fowler, academia) unificadas en un solo sistema para ingenieros en producción Ver la página del libro →
¿Te resultó útil este artículo?