ローカルLLMの本は、いま2冊あります。
- ローカルLLMシリーズ
- 2冊
- すべてKindleで購入可
- 合計 ¥2,200
2冊を通して読むとできること
- 家庭用GPUのVRAMに収まる量子化とオフロードの設定を、実測値から決められる
- llama.cpp のパラメータが速度のどこに効くかを切り分けられる
- LLMが事前学習から推論までに何をしているかを、コードの行として追える
- 「なぜ遅いのか」を体感ではなく計測で答えられる
読む順番
- 1
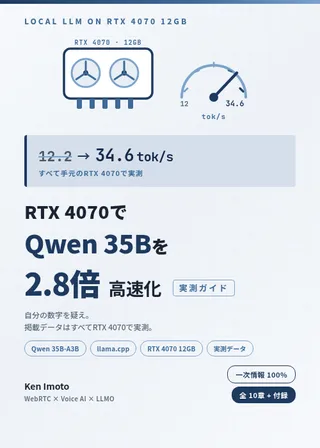
速くするRTX 4070でQwen 35Bを2.8倍速くする
まず動かして速度が出ると、中身を知りたい理由が具体的になる
- 2
中を読む8000行でわかる大規模言語モデル
設定をいじって速くなった理由が、ここで構造として分かる
手元でローカルLLMが遅いという実害があるなら1冊目の『RTX 4070でQwen 35Bを2.8倍速くする』から。GPUを持っていなくても読めるのは2冊目の『8000行でわかる大規模言語モデル』です。こちらはコードを読む本なので、実機が要りません。
それぞれの担当

他の言語版について
この2冊は日本語版のみです。英語版・ポルトガル語版はありません。
まとめて買う
Amazonでのシリーズ名は「ローカルLLMシリーズ」です。上の順番がそのまま巻数になります。
よくある質問
- 2冊とも必要ですか?
- 必要ありません。速度の問題を抱えているなら1冊目、仕組みを知りたいなら2冊目で完結します。扱っている層が違うので、片方だけ読んでも困りません。
- RTX 4070 を持っていないと読めませんか?
- 1冊目は 4070 の12GBを前提に実測しているので、VRAM量が違うと数値はそのまま使えません。考え方は流用できます。2冊目はコードを読む本なので、GPUが無くても読めます。
- プログラミングの知識はどこまで要りますか?
- 1冊目はコマンドを打てれば読めます。2冊目は Python のコードを読むので、読める程度の知識が要ります。書ける必要はありません。
- Zenn でも読めますか?
- 2冊とも Zenn Book 版があります。Kindle 版は加筆と再構成が入っていて、オフラインで読めます。各書籍ページから Zenn 版を確認できます。