ナレッジグラフ4つの型を6軸で比較する
ナレッジグラフを作ろうとすると、まず Neo4j と RDF のどちらかという記事に当たります。その分岐の1つ手前に、決まっていることがあります。何をグラフにするかです。
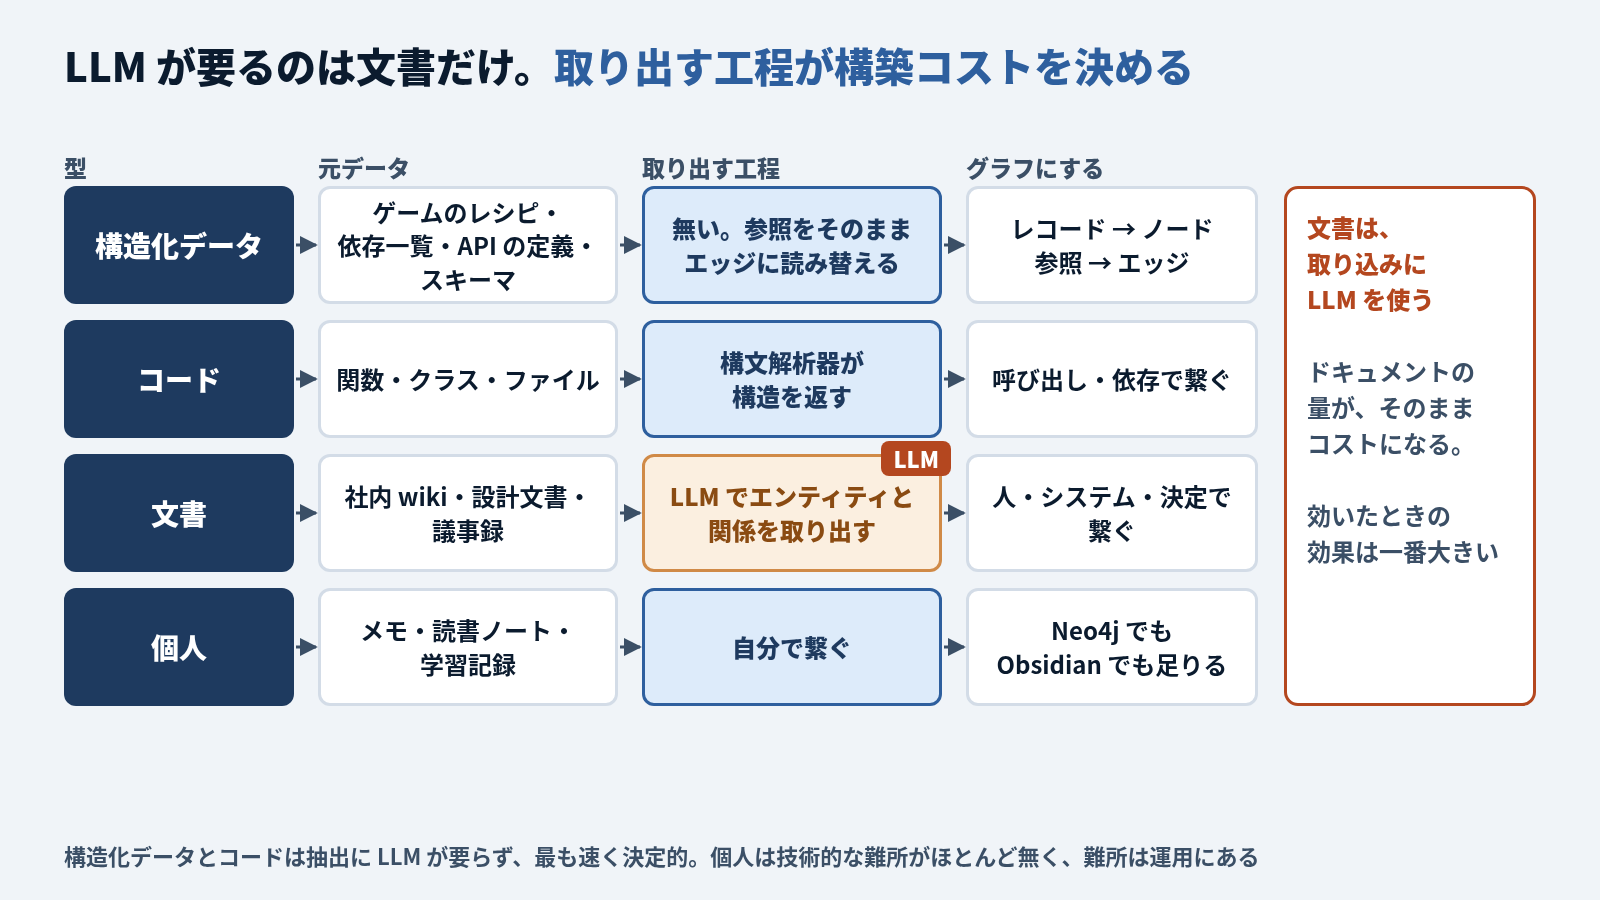
多くの場合、答えは構造化データかコードのどちらかです。 元データが既に構造を持っているなら、抽出という工程がまるごと要りません。コードベースも同じで、構文解析器が構造を返すので LLM は不要です。文書は効果が一番大きい代わりに、取り込みにコストが乗ります。そして4つ目の個人のメモ。技術的には一番簡単で、続かないという理由で一番よく死にます。
この4つを混ぜて設計すると、だいたい更新のところで詰まります。同じ仕事をさせたときにどう割れるのかを、6軸で並べます。
揃える課題
比較を成立させるために、4つの型に同じ問いを投げます。
「A と B はどう繋がっているか」に答えさせる。
ベクトル検索で解ける問いをわざわざグラフにしても意味がないので、対象は、2つ以上のものを繋がないと答えが出ない問いに絞ります。
| 型 | この問いの具体例 |
|---|---|
| 構造化データ | この材料が手に入らないと、何が作れなくなるのか |
| コード | この関数を直すと、どのファイルに影響が出るのか |
| 文書 | この方針はいつ、どの決定を受けて変わったのか |
| 個人 | 去年読んだあの本と、いま調べているこの技術はどこで繋がるのか |
どれも「似た文書を上位8件返す」では答えになりません。関係を辿る必要があります。
4つの型
構造化データのグラフ。 元データが既にレコードと参照を持っているものです。ゲームのレシピ、依存パッケージの一覧、API の定義、データベースのスキーマ。抽出という工程が存在しないので、読み替えるだけでグラフになります。4つのうち最も速く、最も決定的です。
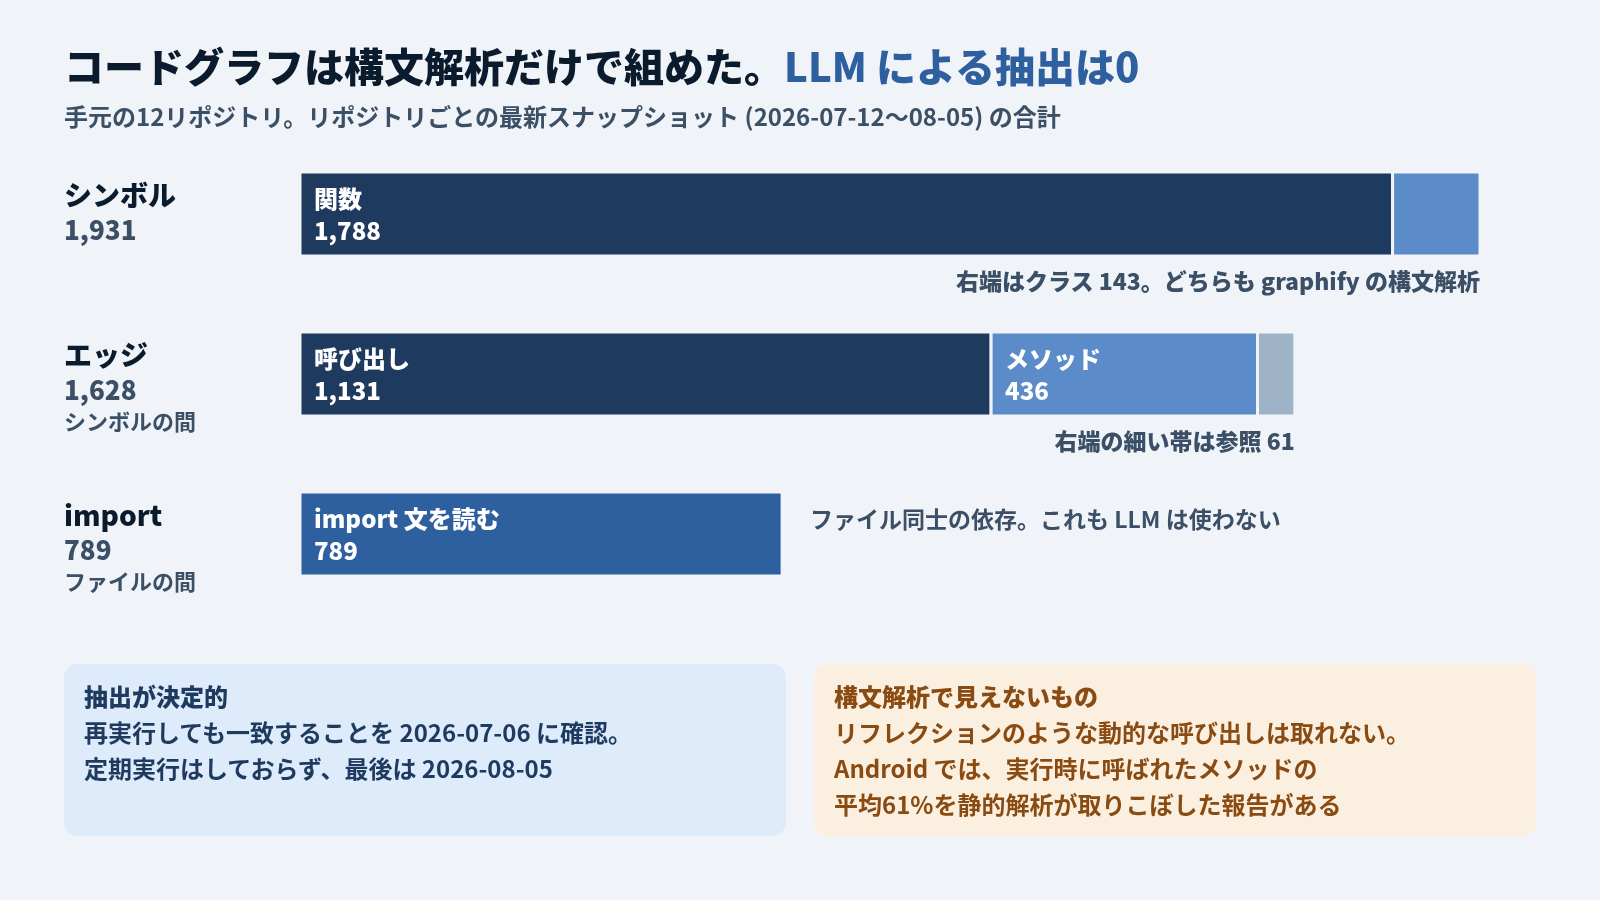
コードグラフ。 関数・クラス・ファイルをノードにして、呼び出しと依存で繋ぎます。構文解析で取れるので LLM が要らず、更新も git の差分から機械的に組み直せます。
文書グラフ。 社内 wiki、設計文書、議事録をノードにして、人・システム・決定で繋ぎます。作るのが一番大変で、効いたときの効果も一番大きい型です。取り込みに LLM を使うので、ドキュメントの量がそのままコストになります。
個人グラフ。 自分のメモ、読書ノート、学習記録を繋ぎます。ツールは Neo4j でも Obsidian でも足ります。技術的な難所はほとんどありません。難所は運用のほうで、参照しなくなった瞬間に更新が止まり、止まった瞬間に価値がゼロになります。
マトリクス
| 軸 | 構造化データ | コード | 文書 | 個人 |
|---|---|---|---|---|
| 構築コスト | 最低 (抽出が不要) | 中 (構文解析だけ) | 高 (LLM抽出が要る) | 低 |
| 更新の自動化 | できる (元データ追従) | できる (git差分) | 難しい | 手動 |
| 腐りやすさ | 最低 | 低 (自動更新なら) | 中 | 高 |
| 多段の効き | 大 | 大 | 最大 | 中 |
| 説明可能性 | 大 | 大 | 最大 (経路を出せる) | 小 |
| 必要な道具 | グラフDB だけ | 構文解析器 + グラフDB | グラフDB + LLM | メモアプリで足りる |
| 検証状態 | 実測済み | 実測済み | 未検証 | 未検証 |
コードの「構築コスト: 中」と「更新の自動化: できる」は、構文解析で取れる範囲に限った話です。リフレクションのような動的な呼び出しは構文解析では見えず、Android の静的解析ツールが実行時に呼ばれたメソッドの平均61%を取りこぼしていたという報告があります (別の記事「静的解析コードKGが落とす61%の動的呼び出し」で扱っています)。
6つの軸
表の行に並べた6つが、この比較の物差しです。最後の行の検証状態は軸ではなく、その型を手元で動かしたかどうかを示しています。
構築コストは、最初にグラフを作るまでの手間です。文書は非構造化テキストからエンティティと関係を取り出す工程があり、そこに LLM の API コストが乗ります。コードは構文解析器が構造を返すのでこの工程が要りません。構造化データに至っては、元データの参照をそのままエッジに読み替えるだけです。
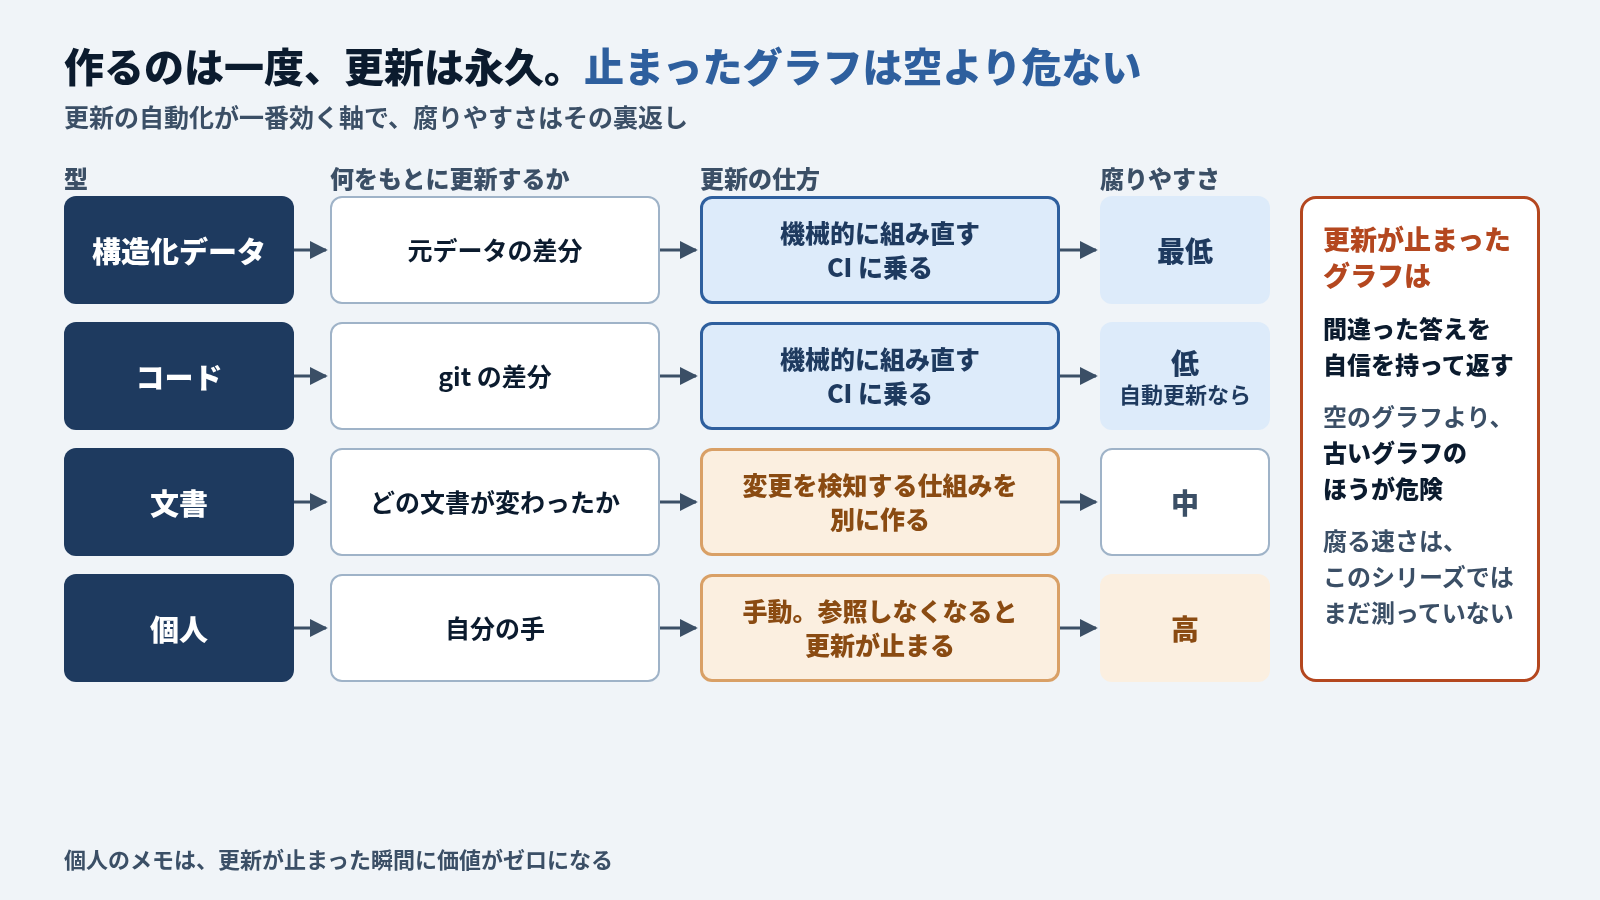
更新の自動化が、実は一番効く軸です。作るのは一度きりですが、更新は永久に続きます。構造化データとコードは元データの差分から組み直せるので CI に乗ります。文書グラフは「どの文書が変わったか」を検知する仕組みを別に作ることになります。
腐りやすさは、更新の自動化の裏返しです。更新が止まったグラフは、間違った答えを自信を持って返すようになります。空のグラフより、古いグラフのほうが危険です。
多段の効きは、グラフにする価値そのものです。1段 (ホップ。関係を1本辿ると1段) で答えが出る問いなら、ベクトル検索とリランカーで足りると見ています (ベクトル検索の側は測っていません)。2段以上を辿らないと答えられない問いがどれだけあるかで、投資の是非が決まります。ここは段数の実測で測りました。
説明可能性は、なぜその答えなのかを経路として提示できるかどうかです。監査の要る業務や規制業界では、精度よりここが採用条件になります。ベクトル検索は「似ている文書」までしか示せません。
必要な道具は、そのまま着手の障壁です。個人グラフは既存のメモアプリで始められます。
自分ならどれか
| 状況 | 残る候補 | 効いている軸 |
|---|---|---|
| 依存やレシピの影響範囲を出したい | 構造化データ | 構築コスト・更新の自動化 |
| コードレビューの範囲を絞りたい | コード | 更新の自動化 |
| 社内の「これ誰が決めたんだっけ」に答えたい | 文書 | 説明可能性・多段の効き |
| ベクトルRAGの精度が頭打ちになった | まず問いの形を見る | 多段の効き |
| メモが増えすぎて繋がりが見えない | 個人 | 必要な道具 |
4行目は、そもそもグラフが要らない可能性があります。 自分の問いが1段で閉じているなら、リランカーを足すほうが安上がりなはずです。
5行目も注意が要ります。個人グラフは着手が軽いぶん、続けられるかどうかの見積もりを先にするほうが確実です。参照しない日が2週間続いたら危ない、というのが私の目安ですが、これは測った数字ではありません。
最初に作るなら構造化データから
4つのうちどれを本命にするかとは別に、最初の1つは構造化データで作るのを勧めます。
そこにしか無いものが1つあります。答え合わせができることです。元データが構造を持っているなら、グラフが正しく組めたかどうかを機械で検算できます。文書グラフでは、抽出が正しかったかを人が読んで判断するしかありません。
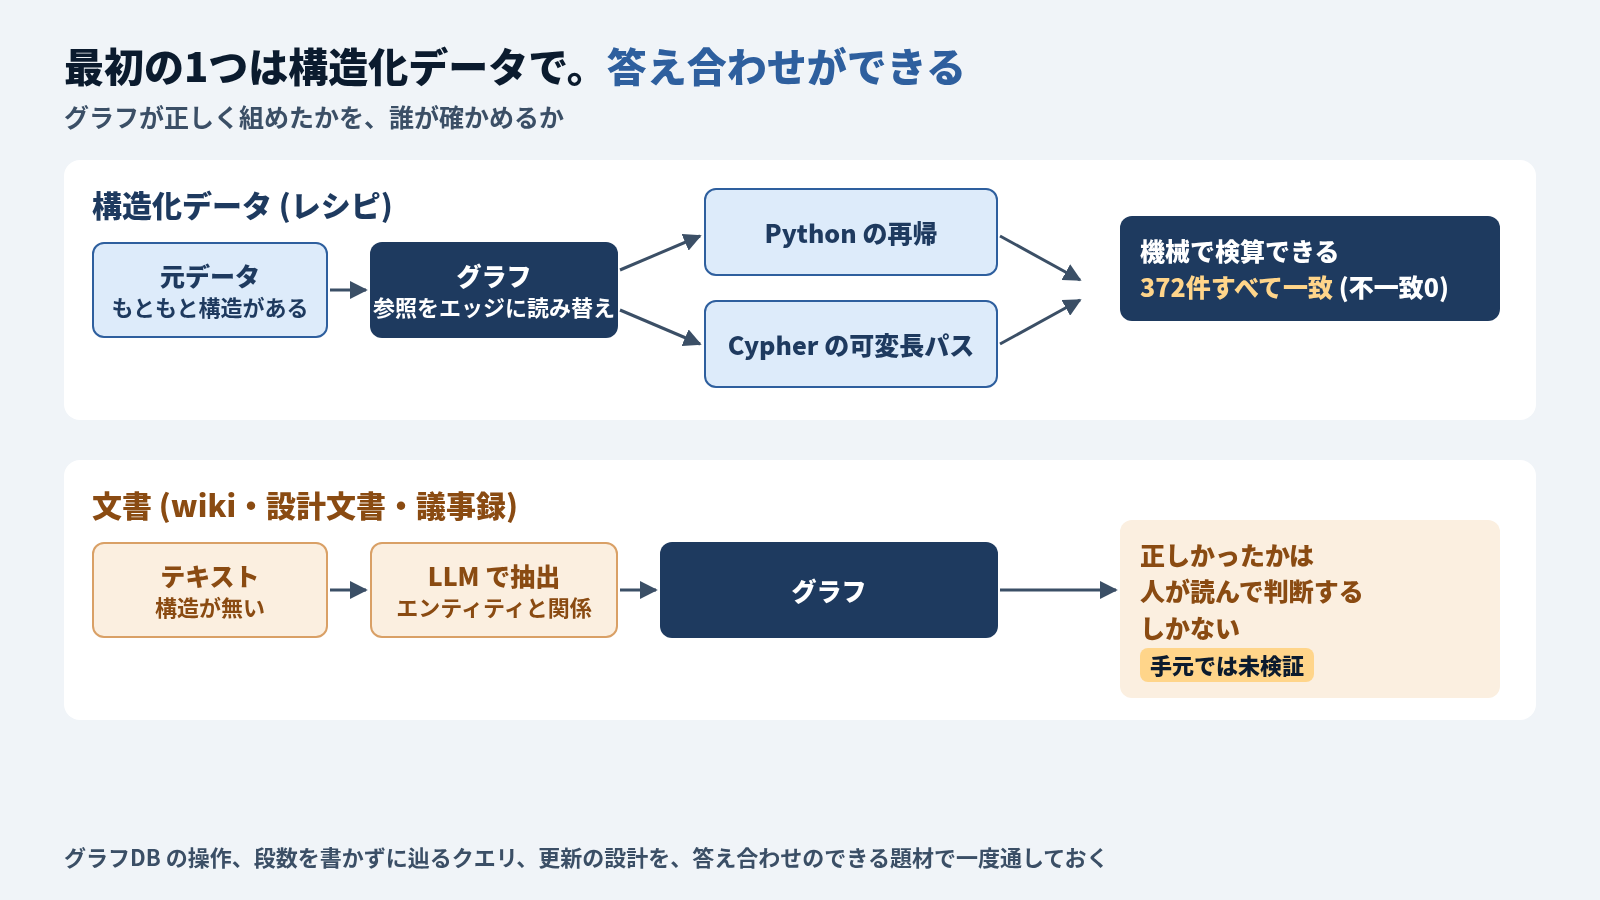
グラフDB の操作も、段数を書かずに辿るクエリの書き方も、更新の設計も、答え合わせのできる題材で一度通しておくほうが速く身につきます。作り方はナレッジグラフ1050ノードを作って踏んだ3つの罠で扱います。
この記事は役に立ちましたか?