ナレッジグラフが効く段数をマインクラフトで実測
ナレッジグラフの説明は、たいてい「LLM は関係を辿れないから」で始まります。では関係を何段 (ホップ。関係を1本辿ると1段) 辿ったところで崩れるのか。グラフを渡すと何が変わるのか。マインクラフト (Minecraft) のクラフトレシピを正解データにして、5つのサイズのモデルに1,010回聞いて測りました。
qwen3.5:9b で崩れ始めるのは3段目でした (2段 70% → 3段 37%)。35b と 4b は2段の時点で既に落ちています。グラフを1歩ぶん渡して効いたのは 9b と 35b で、これは思考 (thinking) を切った条件です。4b に渡すと、2段以上の完全一致率は 12.7% から 1.4% に下がり、渡さないほうがましという結果になりました (0.8b と 2b はどちらも 0%)。35b も思考を有効にすると逆転します。
マインクラフトのクラフトツリーで測った理由
正解が公開されていて、機械が読める形で配られているからです。理由はこれだけです。
この種の評価は「公開された正解データが無いので人手でアノテーションする」のが通例で、そこが弱点になっています。評価する側が正解を書くと、書いた側の理解が上限になります。 ゲームのクラフトレシピにはその問題がありません。ゲーム自身が正解を配っています。
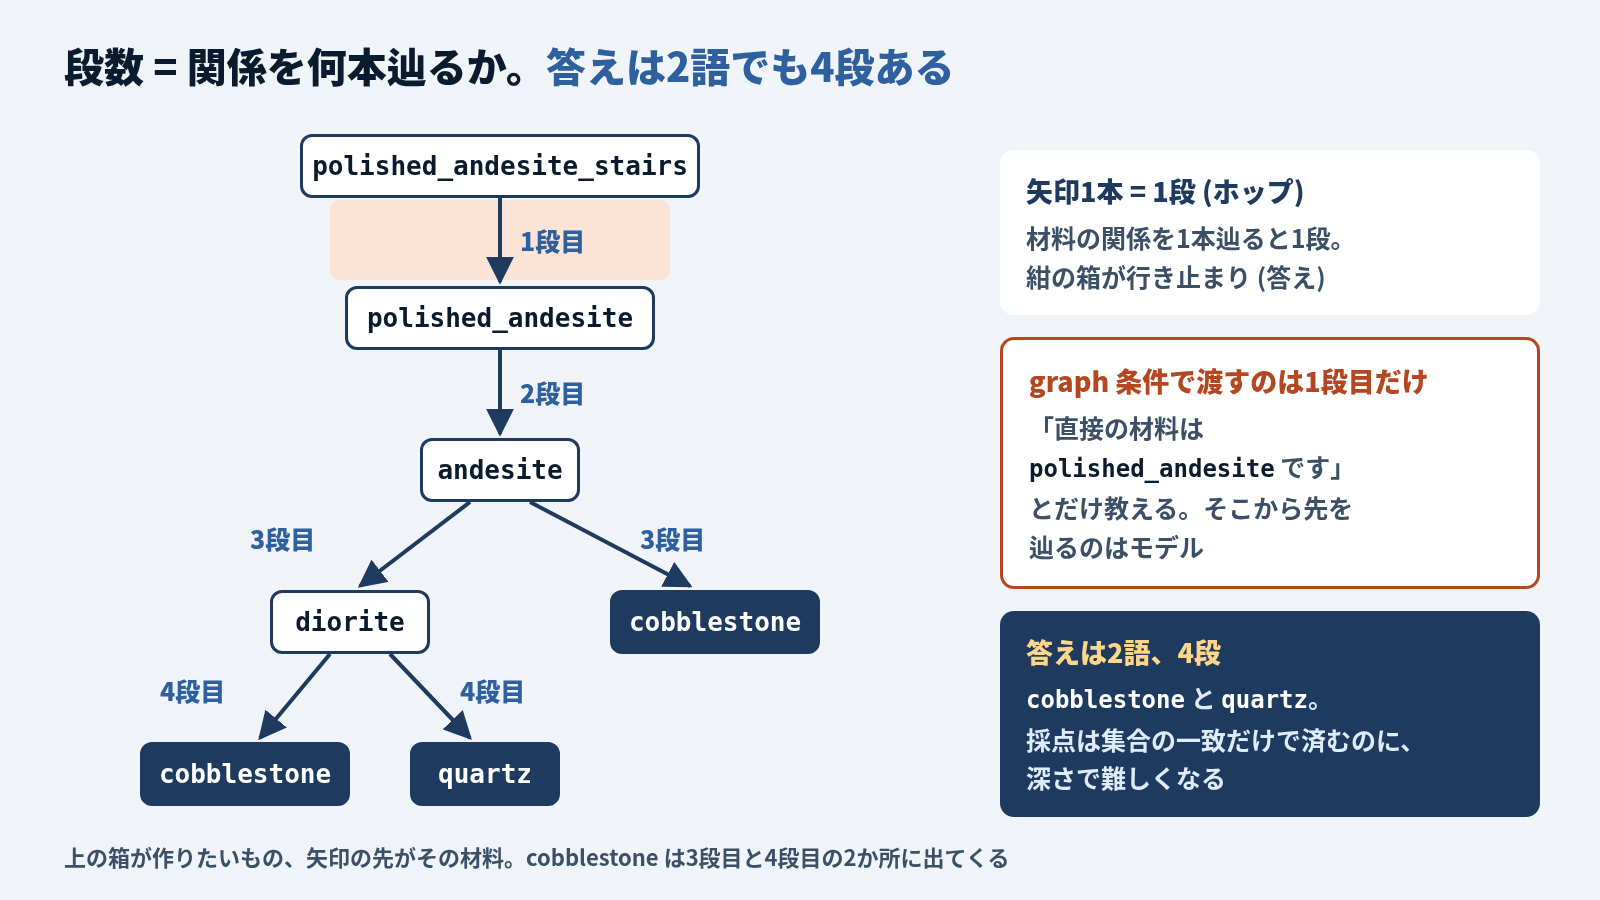
そしてクラフトは、そのまま有向グラフです。
polished_andesite_stairs
  → polished_andesite
    → andesite
      → diorite → cobblestone, quartz
      → cobblestone
Polished Andesite Stairs の材料を最後まで展開すると、答えは cobblestone と quartz の2つだけです。答えは2語なのに、4段辿らないと出てきません。 採点は集合の一致だけで済むのに、深さで難しくなります。
何を聞いたか
質問は1種類だけです。
この道具を1個作るのに最終的に必要な材料を、全部挙げてください。採掘・精錬・収穫・取引・モブドロップで手に入るものが、止まる場所です。
条件は2つです。
| 条件 | 渡すもの |
|---|---|
bare | 何も渡さない。モデルの記憶だけで答えさせる |
graph | 直下の材料だけを渡す。葉までの答えは渡さない |
graph は「ナレッジグラフから1段ぶん引いた状態」に相当します。Polished Andesite Stairs なら「直接の材料は polished_andesite です」とだけ教えます。そこから先を辿るのはモデルの仕事です。
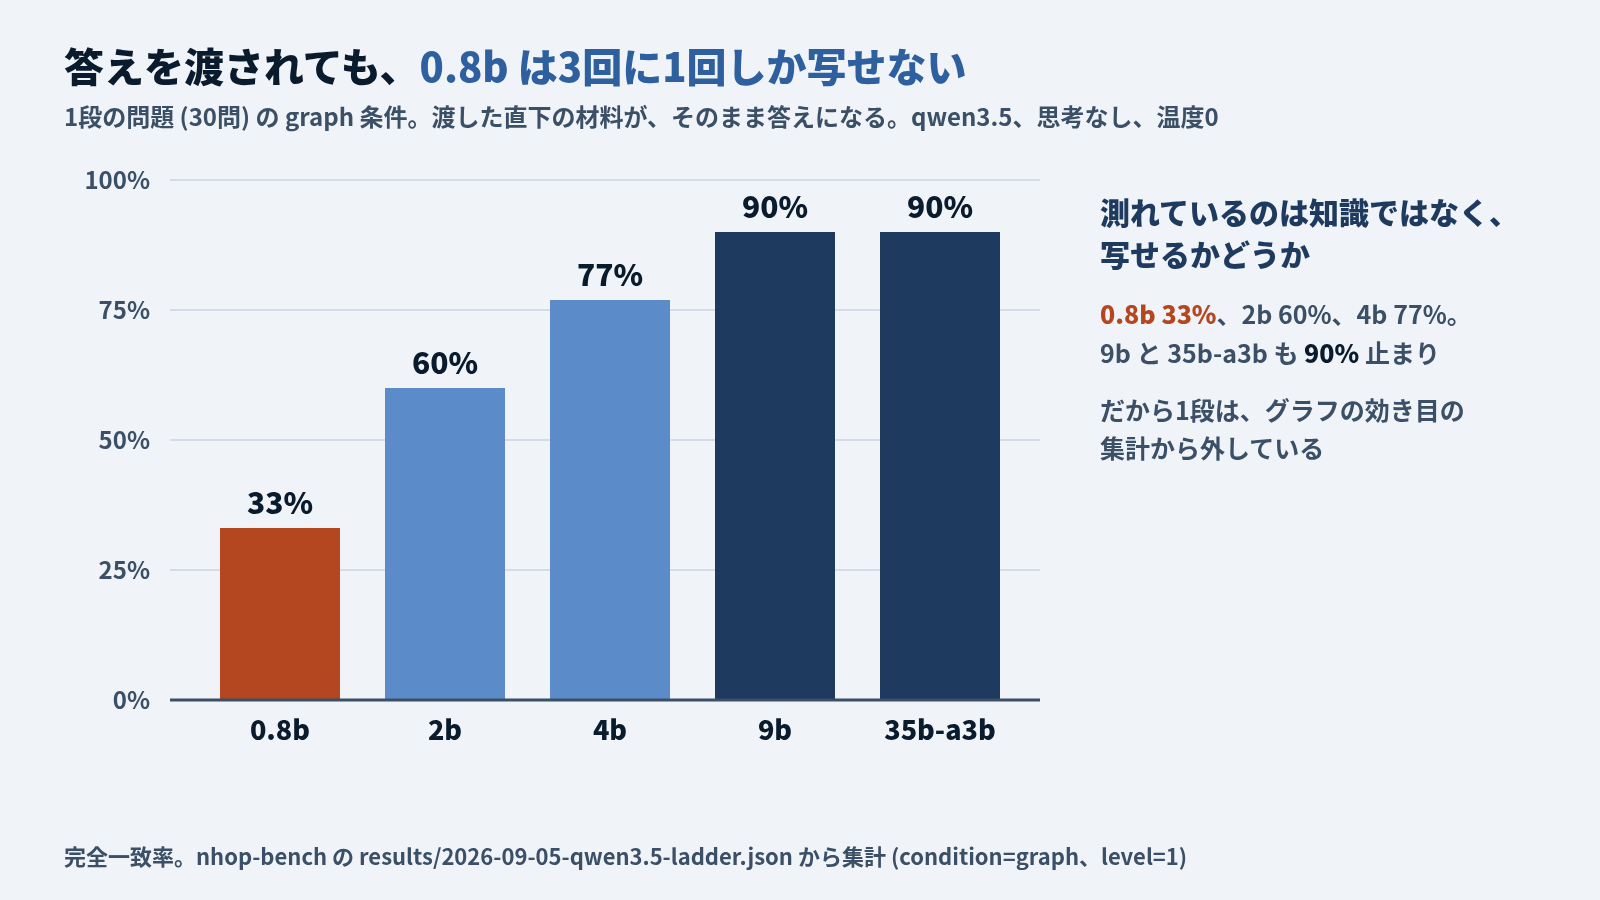
1段の問題は集計から外しています。 段数1では直下の材料がそのまま答えなので、graph 条件は答えそのものを渡すことになります。そこで見えるのは、渡されたものを写せるかどうかです。知識ではありません。
写せるかどうかも、それはそれで差が出ました。答えを渡された状態で、0.8b は33%、2b は60%、4b は77%、9b と 35b は90%しか正解しません。一番小さいモデルは、答えを見せられても3回に1回しか写せません。
段数で崩れる
段数を横に並べると、どのモデルも同じ形で落ちます。グラフを1歩渡した条件の完全一致率です。
| モデル | 1段 | 2段 | 3段 | 4段 |
|---|---|---|---|---|
| qwen3.5:4b | 77% | 3% | 0% | 0% |
| qwen3.5:9b | 90% | 70% | 37% | 22% |
| qwen3.5:35b-a3b | 90% | 50% | 13% | 11% |
1段はどのモデルも取れます。 直下の材料をそのまま渡しているので、写せるかどうかの問題です。差が開くのはその先で、2段から4段にかけて 9b が 70% から 22% へ、35b が 50% から 11% へ落ちます。どちらも3分の1以下です。
4b は2段の時点で 3% なので、実質1段で頭打ちです。
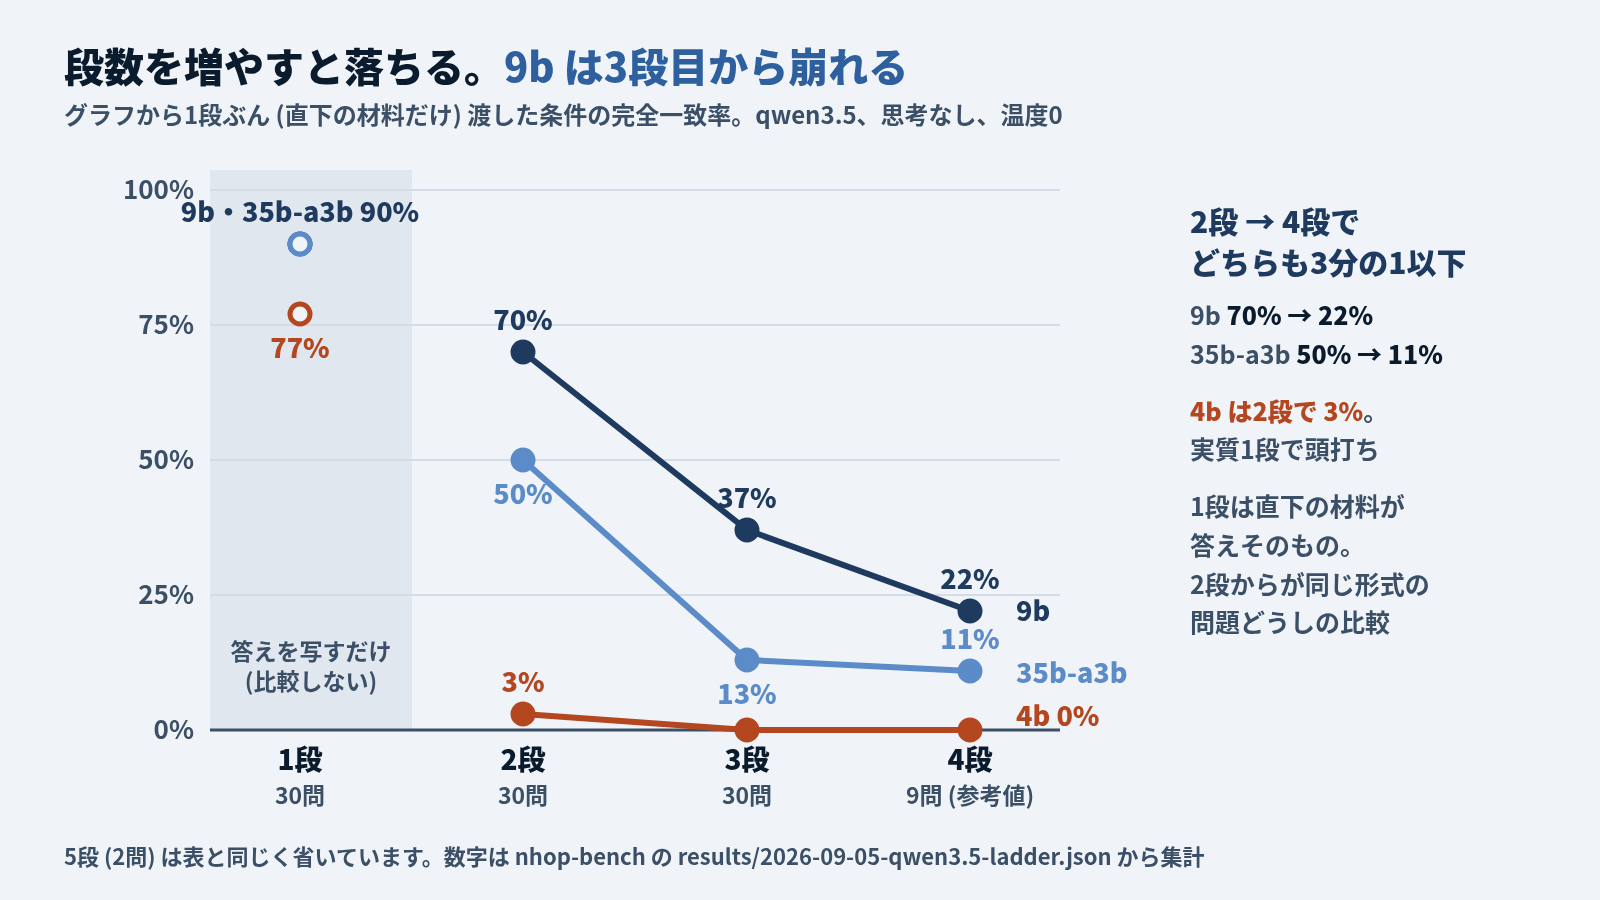
1段と2段は比較していません。問題の難しさが揃っていないためです。1段のなかには Mace ← breeze_rod + heavy_core のように、そもそも知名度の低い組み合わせが混ざります。2段から4段への低下は同じ形式の問題どうしの比較なので、これが段数そのものの効果です。
落ち方には差があります。9b は2段で 70% を保ちますが、35b は 50% まで落ちています。同じ「2段」でも、モデルによって崩れ始める位置が違います。 自分の使うモデルで測る意味があるのはここです。
何段まで持つかは、問いの側から決まる
この結果を運用に持ち込むときは、モデルの限界ではなく問いの分布を見ることになります。
主要なクエリが1段で閉じる      → グラフを足す理由が薄い
2段が混ざる                   → 9b・35b (思考なし) ではグラフが効いた
                                4b と 35b の思考ありは、渡すと下がった
3段以上が主要                  → グラフを渡しても半分は落ちる。
                                辿る処理をモデルに任せず、外で完結させる設計にする
3段目で 9b が 37% というのは、3回に2回は間違えるということです。そこをモデルに辿らせる設計にはできません。グラフ側で葉まで展開してから渡す、という形に寄せる必要があります。
グラフは再現率を上げる。適合率を保てるのは容量次第
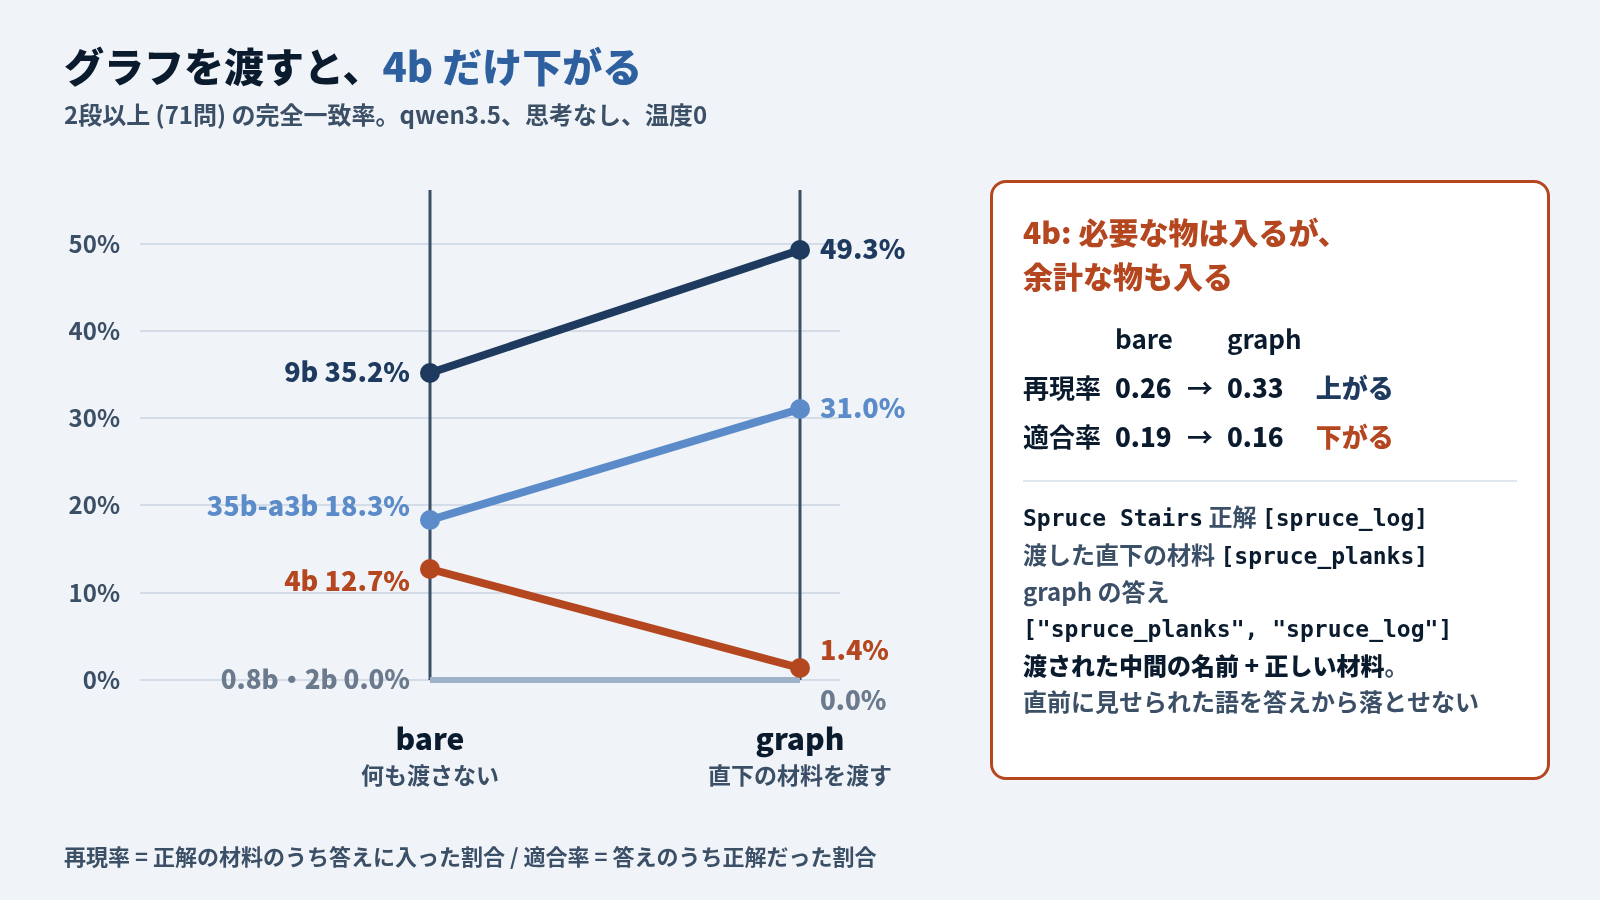
2段以上、71問の平均です。
| モデル | bare 再現率/適合率 | graph 再現率/適合率 | 完全一致 bare→graph |
|---|---|---|---|
| qwen3.5:0.8b | 0.11 / 0.02 | 0.05 / 0.04 | 0.0% → 0.0% |
| qwen3.5:2b | 0.10 / 0.04 | 0.09 / 0.05 | 0.0% → 0.0% |
| qwen3.5:4b | 0.26 / 0.19 | 0.33 / 0.16 | 12.7% → 1.4% |
| qwen3.5:9b | 0.41 / 0.39 | 0.56 / 0.53 | 35.2% → 49.3% |
| qwen3.5:35b-a3b | 0.24 / 0.23 | 0.36 / 0.35 | 18.3% → 31.0% |
4b の行だけ、向きが逆です。グラフを渡すと完全一致が 12.7% から 1.4% に落ちます。
ただし再現率は 0.26 から 0.33 に上がっています。正しい材料は受け取れています。 落ちているのは適合率のほうです。
理由は答えを見れば分かります。
Spruce Stairs      正解 [spruce_log]      渡した直下の材料 [spruce_planks]

  bare   → ["spruce_wood"]                     間違い
  graph  → ["spruce_planks", "spruce_log"]     渡された中間の名前 + 正しい材料
質問文には「途中の作りかけのものは挙げないでください」と書いてあります。それでも 4b は、直前に見せられた語を答えから落とせません。
もう1つ、材料が2つある例です。
Respawn Anchor  正解 [crying_obsidian, glowstone_dust]  渡した直下 [crying_obsidian, glowstone]

  graph → ["crying_obsidian", "obsidian", "glowstone", "glow_dust", "glowstone_dust"]
正解の2つは入っています。そこに、渡された glowstone と、存在しない glow_dust と、まったく関係のない obsidian が混ざって出てきます。
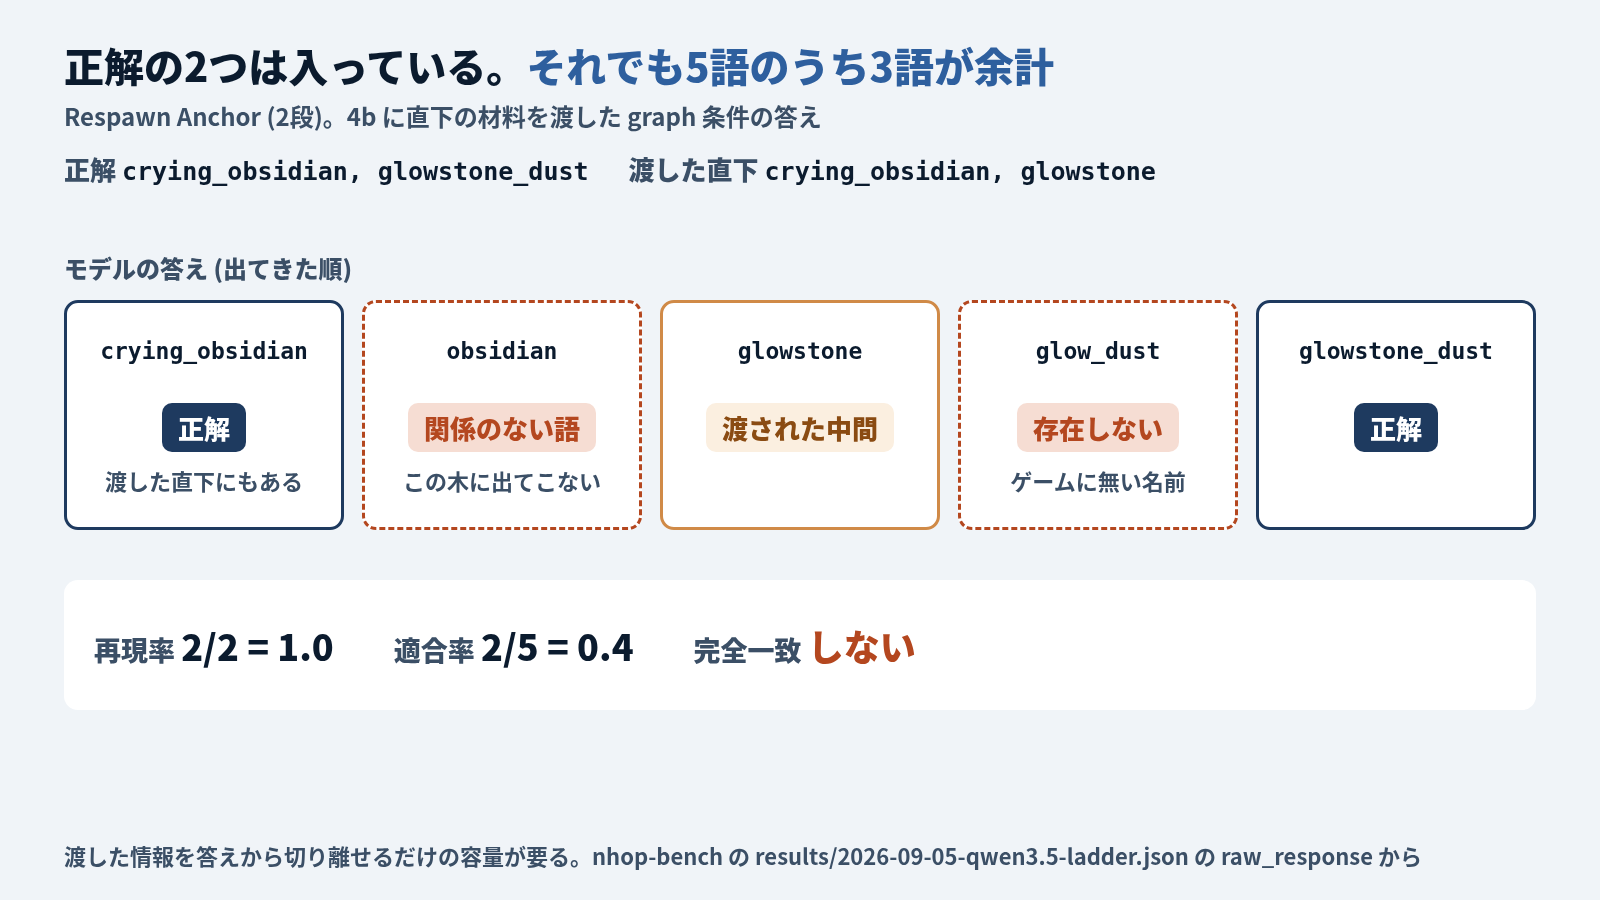
ナレッジグラフを足せば答えが良くなる、とは限りません。 渡した情報を答えから切り離せるだけの容量が要ります。それが無いモデルでは、渡すほど答えが濁ります。
小さいモデルで文脈が害になる報告は、別にもある
この結果は手元の1つの実験です。小さいモデルでは渡した文脈がかえって邪魔になる、という報告は別の研究にもあります。
Oracle and noisy retrieval cause statistically similar distraction for models below 7B — Can Small Language Models Use What They Retrieve?
7B 未満では、正しい文脈を渡しても、雑音を渡したのと同じくらい邪魔になるという報告です。ただし課題の条件が違います。向こうは 360M〜8B のモデルに単発の事実を問う QA で、失敗の型は渡された文脈を無視する側でしたが、こちらの 4b は多段の展開で、渡された語を答えに写す側に崩れています。重なるのは、容量の小さい側で文脈が害になる点だけです。 境界の位置は比べられません。
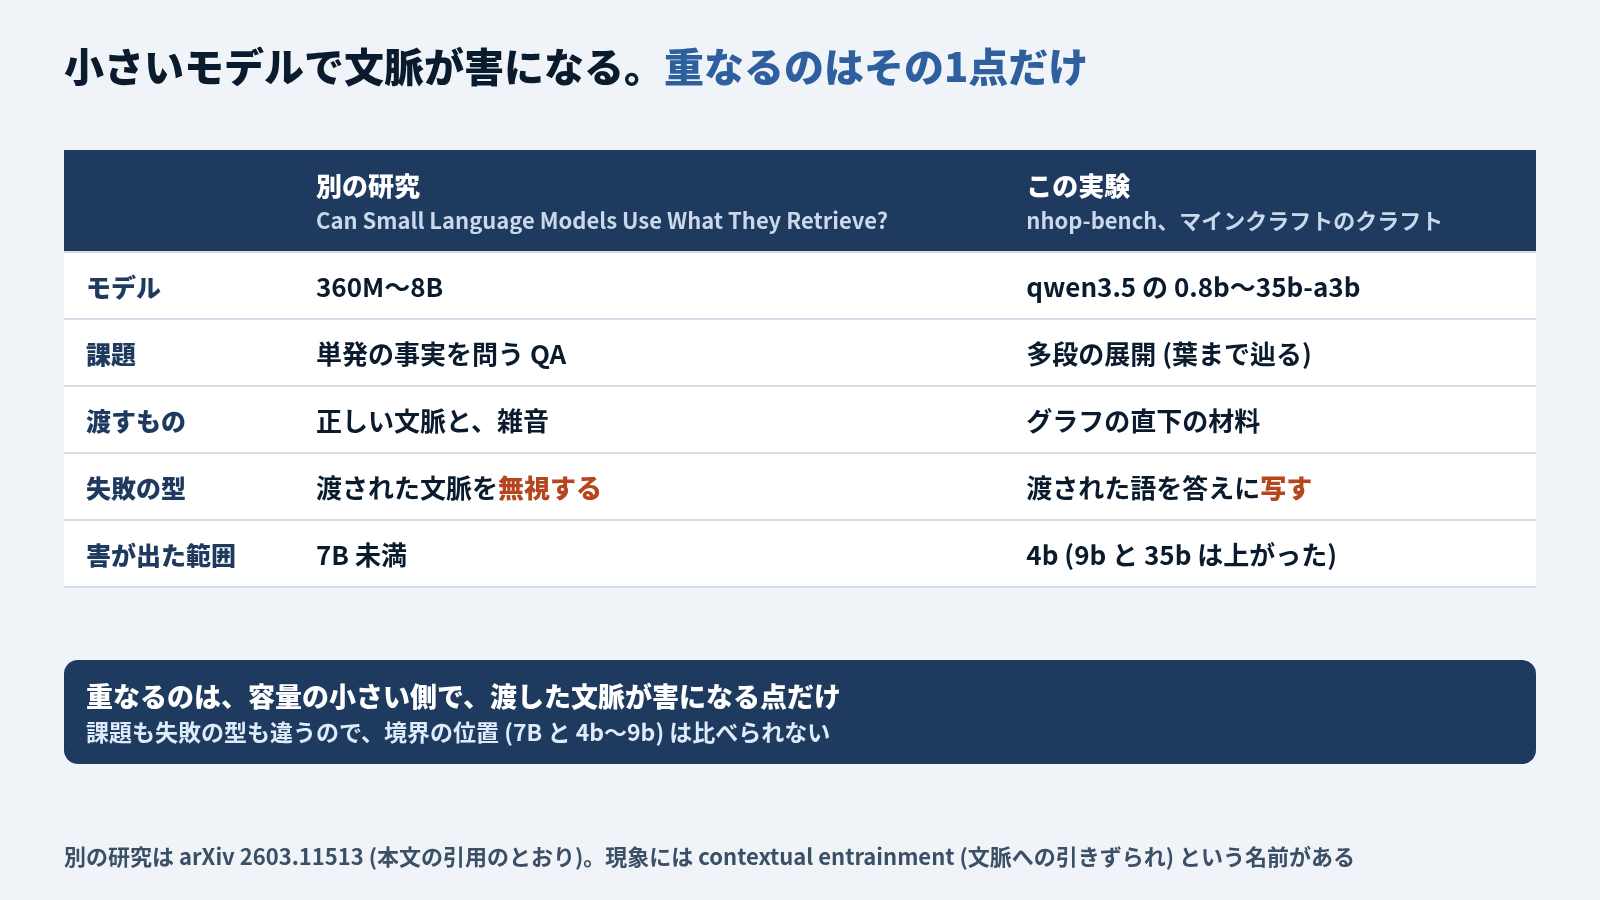
現象そのものには contextual entrainment (文脈への引きずられ) という名前が付いていて、モデルの大きさで現れ方が変わることが報告されています (Better and Worse with Scale)。
大きいほうが強いとは限らない、ただし条件付き
qwen3.5:35b-a3b は qwen3.5:9b に負けました。2段以上で bare が 18.3% 対 35.2% です。このモデルの 35b は総パラメータで、a3b は MoE のため1トークンを出すときに動くのは約3B ぶんです。
ただし、この負けを「MoE だから」で説明するのは行き過ぎでした。 上の測定はすべて思考 (thinking) を切った状態です。この系列は思考を前提にした設計なので、切ったこと自体が効いている可能性があります。35b だけ、思考を有効にして測り直しました。
| 35b-a3b (2段以上) | bare | graph | 差 |
|---|---|---|---|
| 思考なし | 18.3% | 31.0% | +12.7 |
| 思考あり | 28.2% | 19.7% | −8.5 |
符号が反転します。 思考を入れると記憶だけで答える力は上がり、グラフを渡したときの成績は下がります。落ちた問題の中身は 4b のときと同じで、渡された中間の名前を混ぜるか、そこで止まるかでした。思考は、想起には効き、引きずられも強めます。
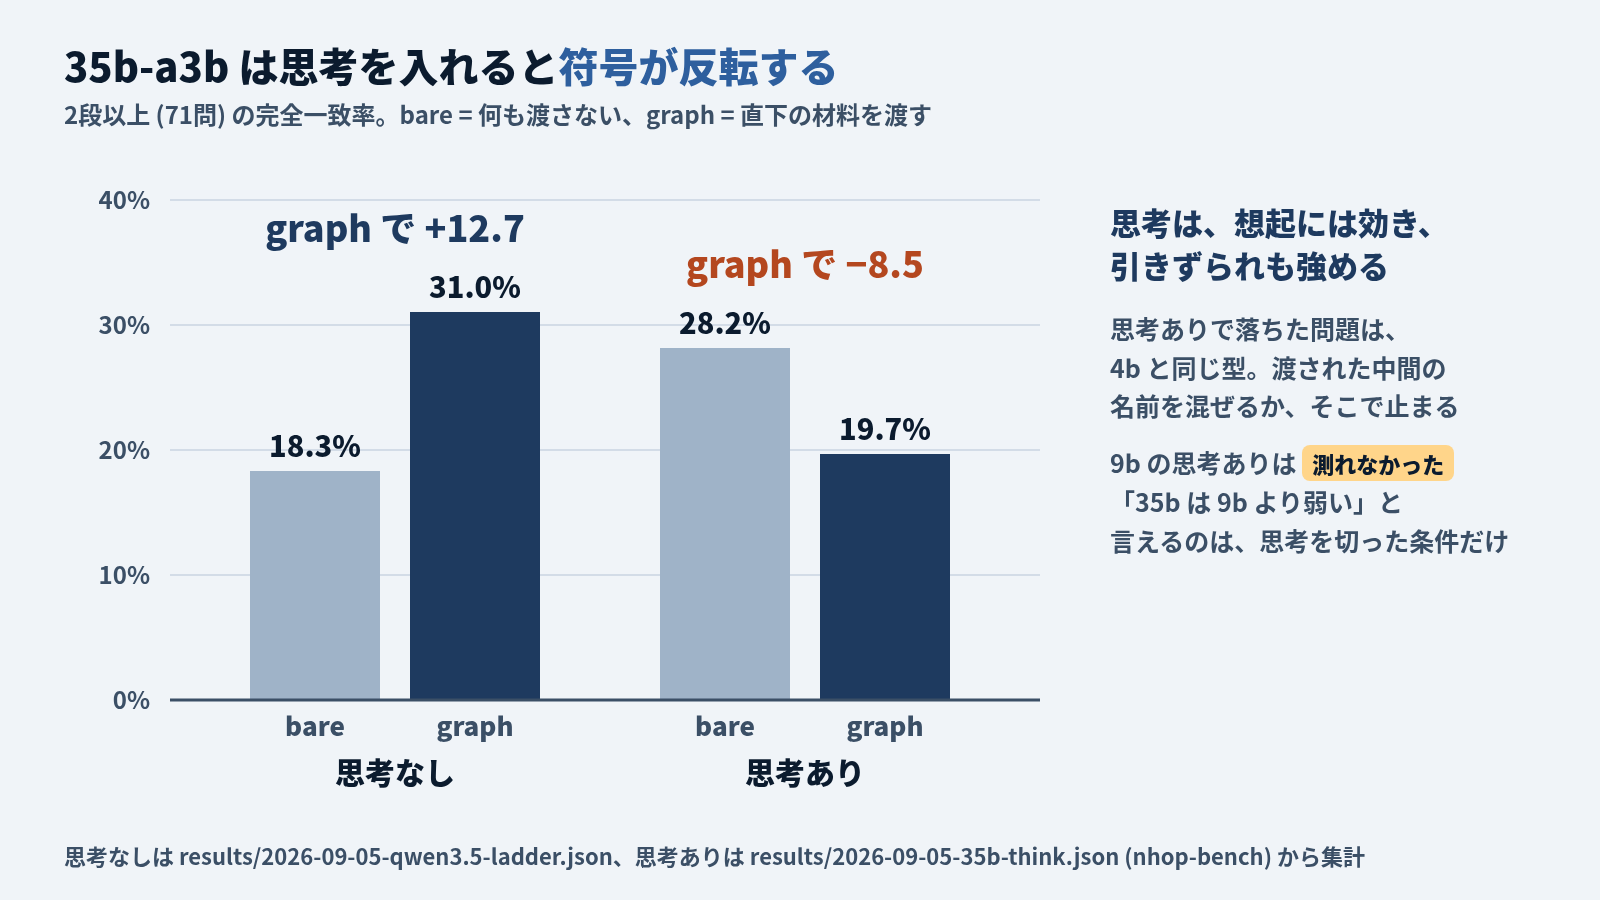
9b の思考ありは測れませんでした。構造化出力を指定すると空の配列を返し、外すと出力上限を思考に使い切って答えに到達しません。したがって「35b は 9b より弱い」と言えるのは、思考を切った条件に限ります。
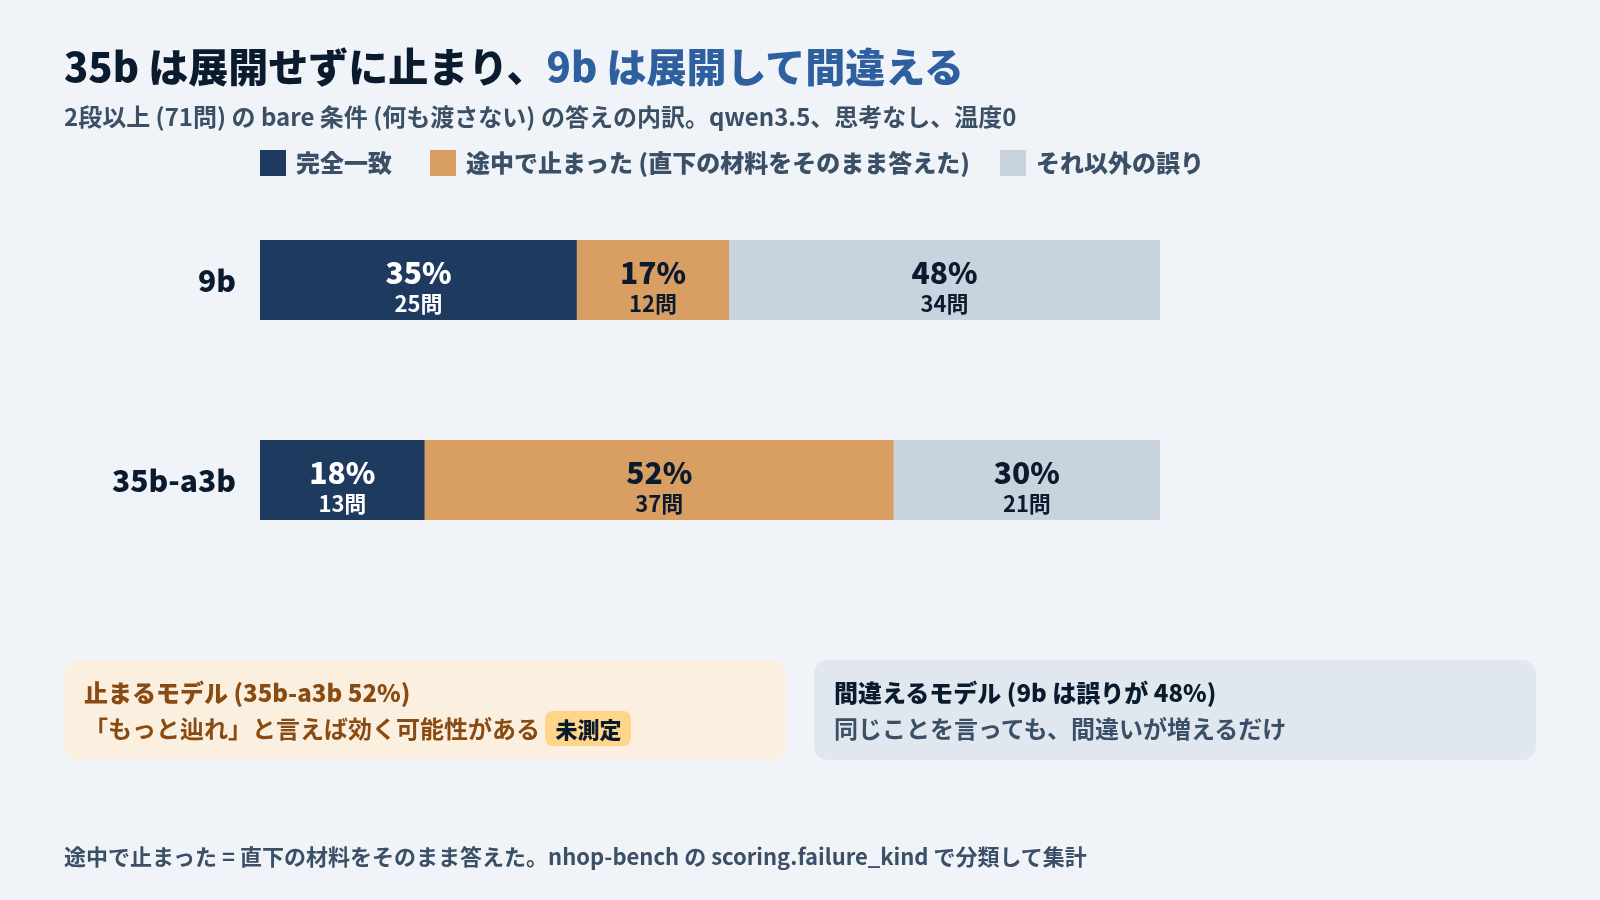
失敗の型が違うことは、思考を切った条件では観察できました。2段以上の bare で「途中で止まった」(直下の材料をそのまま答えた) が 35b は52%、9b は17%。35b は展開せずに止まり、9b は展開して間違えます。 止まるモデルには「もっと辿れ」と言えば効く可能性がありますが、間違えるモデルに同じことを言っても間違いが増えるだけです。
使うときの限界
- 4段の問題は9問、5段は2問しかありません。深い側の数字は参考値として扱ってください
- 段数と難しさは一致しません。 5段の
Bamboo Mosaic Stairsは答えがbamboo1つで、深いのに簡単です - 材料の種類の集合だけで採点していて、個数は見ていません
- クラフトできる887件のうち、分岐439件・自己複製19件・圧縮ペア57件を正解データから外して372件にしています。そのぶん対象が木材と石材に偏ります
- 温度0で各1回です。ばらつきは測っていません
この結果をどう使うか
3つ言えます。
ベクトル検索のままでよいかを、クエリの段数で判断できます。 聞かれることが1段で答えられるなら、グラフを足す理由は薄いです。2段以上のものが主要なクエリに混ざり始めたところが、検討を始める線になります。
グラフを足す前に、使う側のモデルの容量を見てください。 4b では、渡した情報が答えに混ざって完全一致率が落ちました。小さいモデルにグラフを繋いで安く済ませる構成は、この結果の範囲では成立していません。
モデルの名前のパラメータ数を、そのまま実力として読まないでください。 MoE の総パラメータは実効容量ではありません。思考を切った条件では、同じ系列の 35b が 9b に負けました。
生成スクリプトと正解データ、1,010回ぶんの生の応答は nhop-bench に置いてあります。依存パッケージはありません。手元のモデルで同じ手順を再現できます。
グラフを足すと決めたら、次に決めるのは何をグラフにするかです。構造化データ・コード・文書・個人メモで、作る手間も腐り方も違います。ナレッジグラフ4つの型を6軸で比較するで並べています。
Minecraft は Mojang Synergies AB の商標です。このページは Mojang Studios および Microsoft とは無関係で、承認も後援も受けていません。クラフトデータは PrismarineJS/minecraft-data から取得しています。
この記事は役に立ちましたか?