Anthropic soltou context reset no Opus 4.5
Enquanto meio mundo do dev BR ainda está aprendendo a orquestrar dois agentes de LLM em paralelo, a Anthropic publicou em março de 2026 uma engineering note onde faz o oposto: dropou o context reset do próprio harness interno na transição de Sonnet 4.5 para Opus 4.5. Mesmo pipeline, mesmo Planner-Generator-Evaluator, um agente a menos de compensação.
Não foi decisão estética. O padrão implícito é forte: quanto mais capaz o modelo, mais fino o harness precisa ser. Se você está prestes a montar um enterprise agent orchestrator de quatro agentes em cima do Sonnet 3.7, tem chance real de estar construindo um harness que o próximo release note torna redundante.
O que é “context anxiety”
O termo aparece assim, entre aspas, no post oficial da Anthropic:
“Some models also exhibit ‘context anxiety,’ in which they begin wrapping up work prematurely as they approach what they believe is their context limit.”
Traduzindo direto: o modelo detecta que está chegando perto do limite da janela de contexto e começa a fechar a tarefa antes do tempo. Encerra funções sem completar, decide mais rápido e menos cuidadoso, corta canto. Não é bug — é um comportamento aprendido durante o treinamento.
O impacto em uma sessão longa de coding é direto. Você pede 16 features implementadas em ordem, o modelo entrega bem as primeiras 12, e as últimas quatro saem apressadas, com testes ausentes ou lógica truncada. A saída é boa o bastante pra passar em CI, e ruim o bastante pra virar bug em produção uma semana depois.
Como Sonnet 4.5 forçou o context reset
O time da Anthropic tem um harness caseiro pra construir aplicações longas com Claude. Três agentes: um Planner que expande a especificação em sprints, um Generator que implementa por sprint, e um Evaluator que roda testes via Playwright.
No Sonnet 4.5, não era suficiente. Citação exata:
“In our earlier testing, we found Claude Sonnet 4.5 exhibited context anxiety strongly enough that compaction alone wasn’t sufficient to enable strong long task performance, so context resets became essential to the harness design.”
Compaction aqui é a sumarização automática do histórico da conversa — o SDK compacta o começo da janela quando ela enche, pra caber mais no fim. É o que a maioria dos agentes faz por padrão hoje.
Context reset é outra coisa: você aborta a sessão inteira, abre uma nova com prompt limpo, e transfere só o estado essencial via um artefato estruturado — no harness anterior da Anthropic (post de novembro de 2025) esse artefato era um arquivo chamado claude-progress.txt. O agente novo começa descansado, sem os 80 mil tokens de histórico pressionando o comportamento de fim-de-tarefa.
A diferença é psicológica no modelo, não computacional na infra. Compaction preserva a continuidade da conversa; reset preserva a saúde do julgamento do agente.
O que aconteceu quando trocaram para Opus 4.5
Uma frase, direto do post:
“Opus 4.5 largely removed that behavior on its own, so I was able to drop context resets from this harness entirely.”
Mesmo harness, mesmo pipeline, mas rodando em Opus 4.5. A ansiedade sumiu sozinha. Sem tuning, sem prompt engineering extra. O modelo novo simplesmente não tinha o comportamento.
E o time removeu o context reset do harness.
Isso é o inverso do que a intuição de dev sênior sugere. A intuição diz: “modelo mais capaz = pipeline mais complexo, porque agora dá pra fazer mais coisa.” A realidade que a Anthropic mediu diz o oposto — modelo mais capaz = harness mais fino, porque a complexidade que estava no harness era compensação de deficiência do modelo.
Se você tirou dez anos construindo pipelines pra suprir limitações de LLM, essa frase dói um pouco. É a intenção.
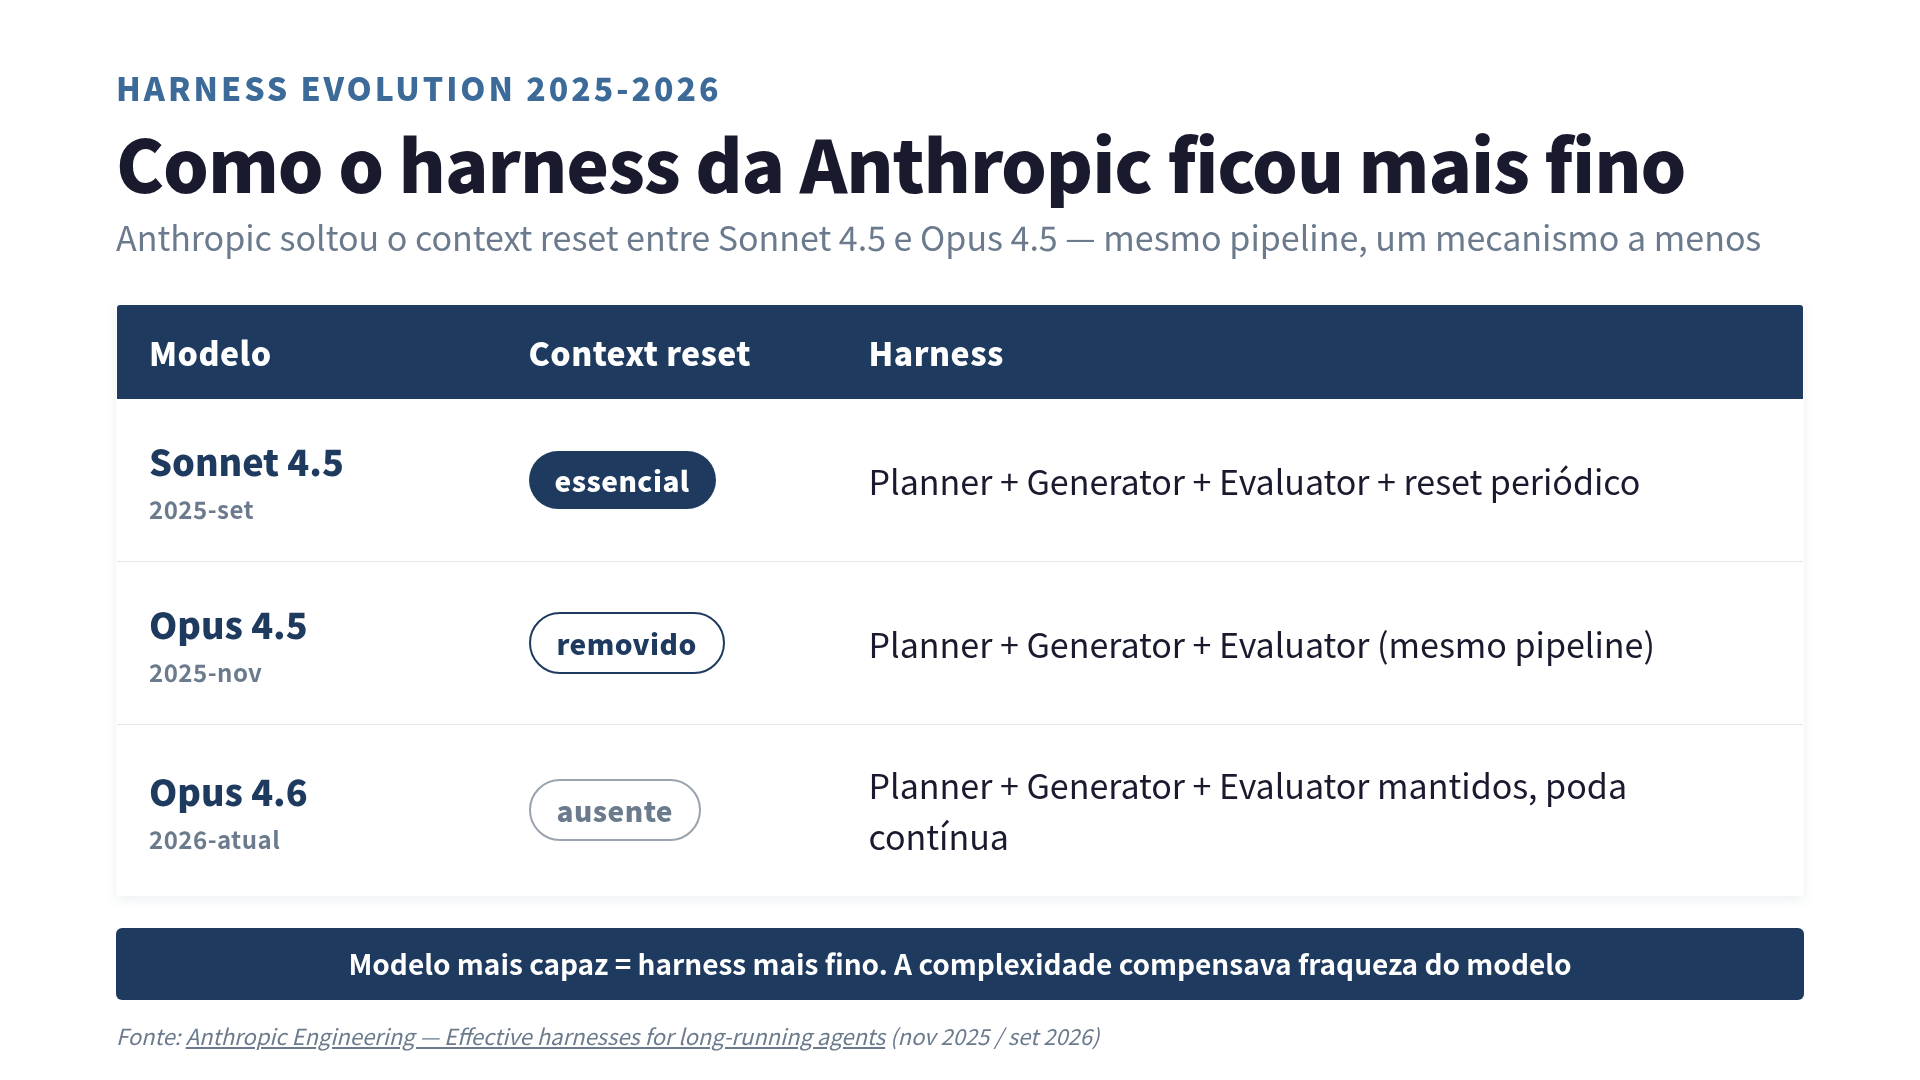
Fonte: Effective harnesses for long-running agents, Anthropic Engineering (novembro 2025 / setembro 2026).
Os números concretos
Duas builds documentadas no post:
| Build | Duração | Custo | Setup |
|---|---|---|---|
| Retro Game Maker (solo prompt) | 20 min | US$ 9 | Só um prompt direto no modelo |
| Retro Game Maker (harness completo) | 6 horas | US$ 200 | Planner + Generator + Evaluator |
| DAW (aplicativo de áudio) | 3h 50min | US$ 124,70 | Planner (4,7 min, US$ 0,46) + 3 build rounds + 3 QA rounds |
O harness completo custou mais de 22 vezes o prompt direto no Retro Game Maker. E entregou uma aplicação melhor. Mas o custo do harness em cima do modelo é linear com o número de agentes que você mantém. Cada nível de orquestração que o modelo consegue absorver internamente vira um agente a menos que você paga.
O DAW ficou em US$ 124,70 com três agentes (Planner + Generator + Evaluator). Se o Planner virar dispensável no próximo Opus, cai pra perto de US$ 124,24. Multiplicado por 100 builds por mês, isso é grana real — e é o tipo de otimização que aparece sozinha quando você para de assumir que o modelo é uma constante.
O que isso significa pra quem está montando um agent-of-agents agora
Especificamente: se você está usando Claude Code, Cursor, Windsurf, ou construindo seu próprio orquestrador de agentes sobre a API da Anthropic hoje, em setembro de 2026, a próxima geração de modelo tem boa chance de reduzir para 60% a 70% da sua orquestração atual.
O que sobrevive na próxima geração:
- Prompts de artefato (arquivos de progresso como o
claude-progress.txtdo post anterior, o feature list estruturado) — porque estrutura da tarefa não é fraqueza do modelo - Sensores externos (Playwright, linter, type checker) — porque validação externa não vira compensação de deficiência interna
- Handoff explícito de estado — porque conversar sobre “o que foi feito” é diferente de “manter todo o histórico”
O que provavelmente vai ser podado:
- Múltiplos agentes especializados por domínio (“agente de backend + agente de frontend + agente de teste”) — se o modelo generalista da próxima geração consegue trocar de contexto sozinho
- Retry loops complexos com fallback entre modelos — se o modelo primário fica confiável o suficiente
- Sumarizações de conversa manuais — se a janela cresce ou a compaction do SDK melhora
Não é pra não construir harness. É pra construir fino e removível. Cada componente do seu harness precisa responder uma pergunta implícita: “isso é estrutura da tarefa, ou é compensação de deficiência do modelo?” A segunda categoria é o que a Anthropic acabou de remover no upgrade Sonnet 4.5 → Opus 4.5.
O que não mudou no harness da Anthropic
Antes que soe como “então joga tudo fora”: o post é claro sobre o que permaneceu no Opus 4.5 e sobreviveu até o Opus 4.6.
- Planner → Generator → Evaluator — os três agentes continuam existindo, cada um com contexto isolado
- Handoff artifacts entre agentes — o formato exato mudou, mas a ideia de passar estado explícito segue
- Sensores externos rodando os testes (Playwright MCP no caso do Evaluator) — validação por observação não é fraqueza do modelo
O que saiu foi mecanismo de compensação: primeiro o context reset periódico no Opus 4.5, depois o próprio sprint construct — com seus 27 critérios de decomposição — foi removido no Opus 4.6, quando o modelo passou a manter tarefas agênticas longas por conta própria. O que ficou foram os componentes de arquitetura que não dependem de fraqueza do modelo pra fazer sentido.
O que fica em aberto
O post anterior da Anthropic — Effective harnesses for long-running agents, de novembro de 2025 — tem uma frase que mais gente do meio dev BR precisa citar antes de vender arquitetura como certeza:
“Most notably, it’s still unclear whether a single, general-purpose coding agent performs best across contexts, or if better performance can be achieved through a multi-agent architecture.”
Ou seja, o time que gastou meses medindo isso — e publicou os números — não fecha a questão “1 agente vs N agentes” pra todos os contextos. Fecha localmente: pra construir aplicações longas, o harness que eles publicaram é o que eles mediram como melhor. Pro seu caso, o harness pode ser mais grosso ou mais fino, e o critério pra decidir é o mesmo: remova o que compensava deficiência de modelo, mantenha o que estrutura a tarefa.
O padrão pros próximos 12 meses
Escreva o harness assumindo que o próximo modelo vai ser mais capaz. Isso não é “não escreva harness” — é “escreva o harness que sobreviva à podagem”. Componentes fáceis de remover ganham valor no médio prazo. Componentes que assumem fraqueza específica do modelo perdem valor no próximo release note.
E se você está construindo enterprise agent orchestrators em 2026 vendendo pra time BR: mostre pro cliente a estratégia de podagem, não só a arquitetura inicial. É o que a Anthropic mostrou publicamente entre novembro de 2025 e agora — só que a evidência é o próprio changelog interno deles, não um whitepaper de marketing.
Referências
- Harness design for long-running application development — Anthropic Engineering (março 2026)
- Effective harnesses for long-running agents — Anthropic Engineering (novembro 2025)
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev · TabNews
 Livro relacionado Harness Engineering Tutorial de Harness Engineering | design de AGENTS.md · implementação de hooks · operação de agentes de IA Ver a página do livro →
Este artigo foi útil?