Não brigue com o modelo: Anthropic mede 150%
Passei três fins de semana reescrevendo o mesmo SKILL.md do Claude Code. Adicionava exemplos negativos, apertava um “IMPORTANT: NEVER do X” em caixa alta no topo, colocava mais uma regra pra cada vez que o modelo me devolvia uma saída ruim. Na quarta semana o arquivo tinha 340 linhas e o modelo ainda fazia mais ou menos o que queria fazer.
O problema não era o meu prompt. Era eu brigando com o modelo.
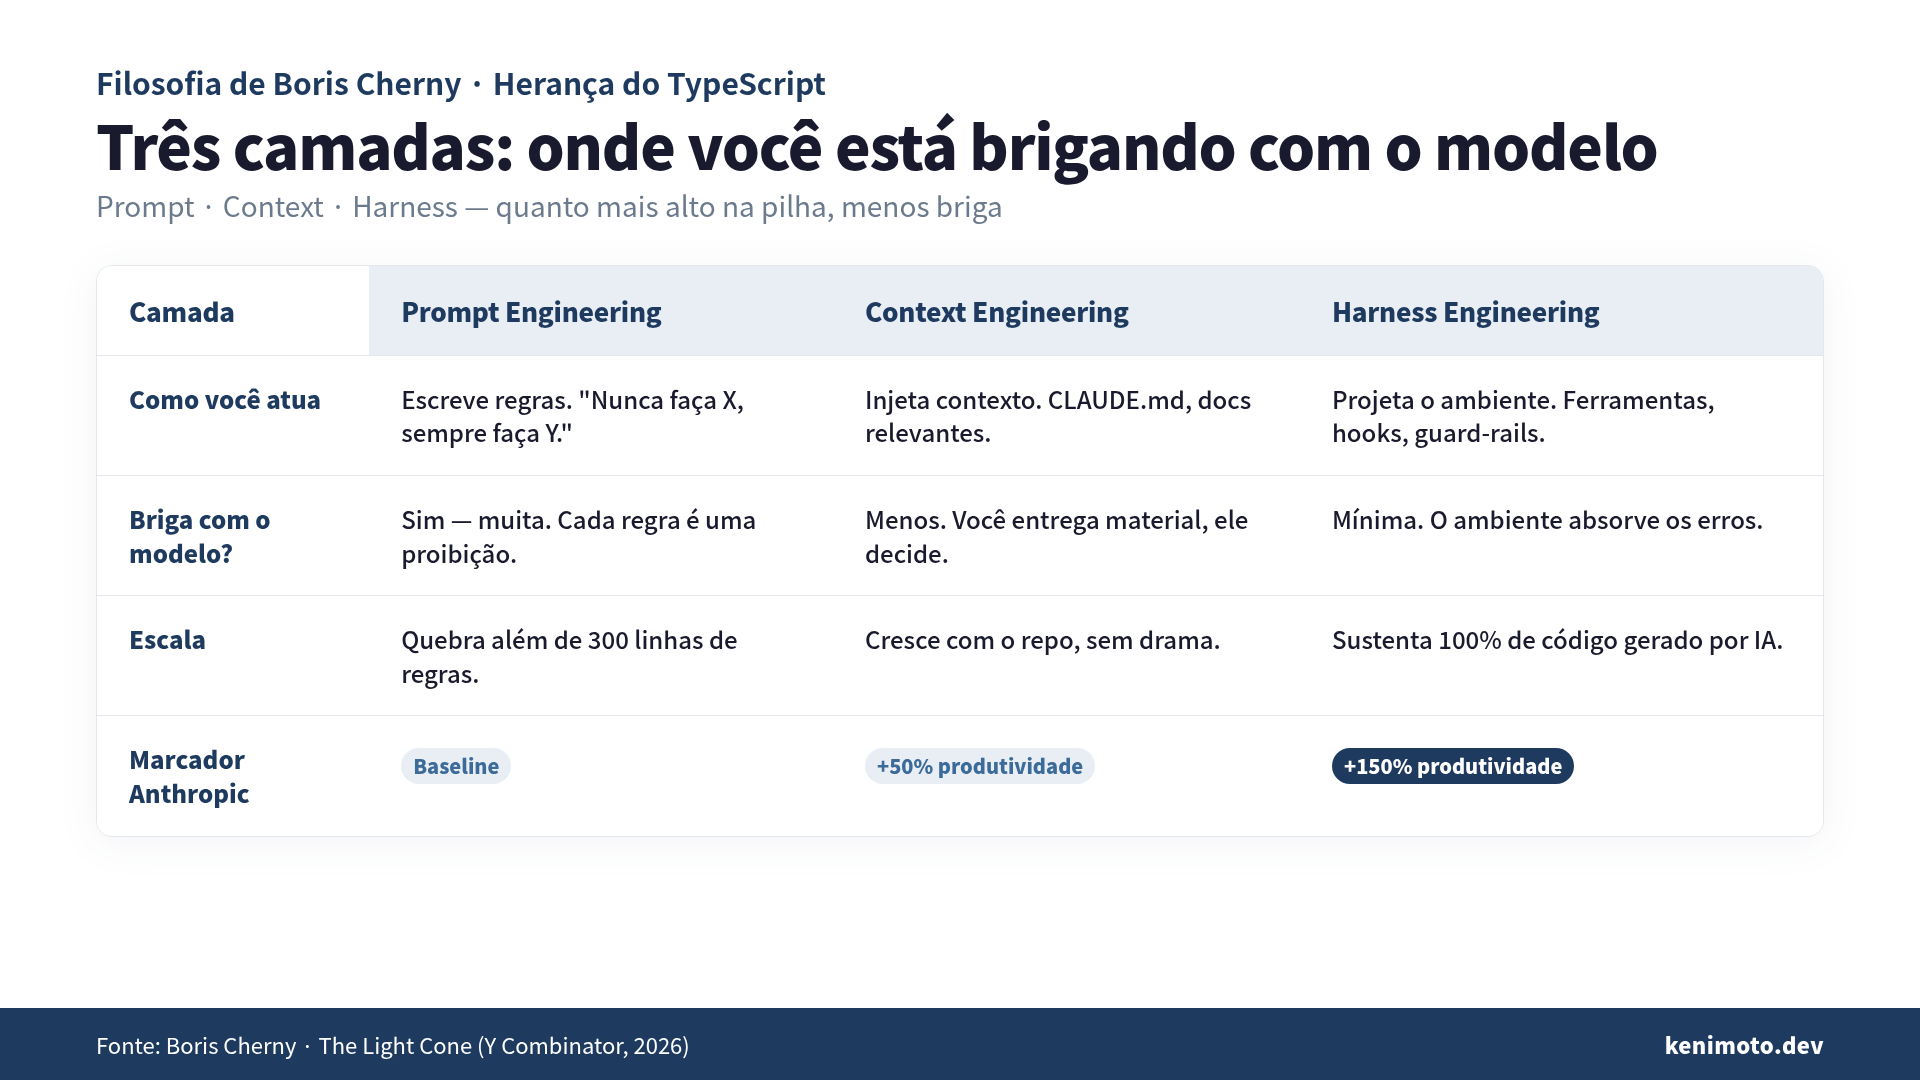
Boris Cherny, criador do Claude Code, deu uma entrevista no podcast The Light Cone da Y Combinator em que soltou uma frase que a comunidade toda repetiu: “o cargo de engenheiro de software vai desaparecer”. O que ficou colado nessa frase, e que quase ninguém compartilhou, é a filosofia por trás. A mesma que sustenta os 150% de aumento de produtividade que a Anthropic mede internamente e os projetos com 100% de código gerado por IA que Boris cita como já rodando na empresa.
A filosofia cabe em quatro palavras: não brigue com o modelo.
É uma diretriz concreta de design de produto, herdada do livro que Boris publicou antes de trabalhar na Anthropic: Programming TypeScript.
A herança do TypeScript
TypeScript ganhou dos concorrentes tomando uma decisão que quase todo mundo ignorou na época: o sistema de tipos se adapta ao jeito que o programador já escreve, não o contrário. Você não precisa reescrever o seu JavaScript pensando em tipos primeiro. O compilador infere, e onde não consegue inferir, você anota o mínimo.
Flow, do Facebook, foi na direção oposta. Exigia mais anotações, um modelo de tipos mais rígido, mais “certeza” do programador antes de compilar. Perdeu.
Claude Code herdou a mesma linha do TypeScript. O SKILL.md é curto. O CLAUDE.md é curto. As ferramentas são poucas. Boris opta por projetar o ambiente para que fazer X seja improvável, e para que quando o modelo faz X, o estrago é limitado.
Compare com o meu impulso inicial. Quando o Claude Code me devolvia um output ruim, minha reação era escrever mais regras. “Não use emoji nos títulos.” “Sempre confirme antes de rodar rm -rf.” “Nunca cite bibliotecas obsoletas.” O modelo continuava colocando emoji, rodando rm sem confirmar, citando bibliotecas de 2019.
Isso é brigar com o modelo. É o equivalente a escrever // TODO: don't do this no código de produção e esperar que o time entenda.
Onde a briga aparece
Se você já usou Claude Code de verdade, provavelmente já brigou. Alguns sintomas comuns:
SKILL.mdcom mais de 500 linhas de “regras”. Cada linha veio de uma vez que você viu o modelo fazer algo errado e reagiu escrevendo uma proibiçãoCLAUDE.mdgigante com trinta instruções de “always follow the coding style”, que o modelo já sabia fazer se você não o distraísse com regras irrelevantes- Prompts do sistema recheados de
<important>e<critical>, todos competindo pela atenção do modelo, que aprendeu a ignorar todos porque estão em toda parte - Templates com dezenas de exemplos negativos que ativam justamente o comportamento que você queria evitar
Nada disso funciona a longo prazo. O modelo tem 200 mil tokens de contexto útil. Você adicionando três mil tokens de “regras” reduz a atenção que sobra para o problema de verdade.
A alternativa é mais chata e menos direta: reprojetar o ambiente para que o comportamento errado não aconteça em primeiro lugar.
O que “não brigar” quer dizer na prática
Três reescritas do meu setup depois do episódio do podcast:
Antes: SKILL.md de code review com 340 linhas listando checkpoints do estilo “sempre verifique X, nunca aceite Y, se ver Z pare”.
Depois: 78 linhas. O que sobrou descreve o objetivo, não a proibição. “O output ideal é uma lista de 5-15 achados, cada um com file:line e severity.” O modelo já sabe o que fazer para chegar lá.
Antes: hooks do Claude Code configurados como muros. “Se o modelo tentar rodar curl, bloqueie.” Vinte linhas de allowlist e denylist que eu atualizava toda semana porque sempre aparecia um caso novo.
Depois: um único hook que audita o comando e me pergunta antes de rodar. O modelo decide, eu supervisiono. A supervisão vira a proteção; a proibição estava proibindo até chamadas legítimas.
Antes: prompt de escrita com quinze exemplos de “não use isso, não use aquilo”. O modelo produzia texto que fugia de todas as proibições e ficava sem alma. Depois: prompt com dois exemplos positivos e uma descrição do resultado desejado. O modelo escreve como o exemplo. Sem lista de proibições.
O padrão é o mesmo nos três: retirar regras, projetar ambiente. Menos briga, mais engenharia.
Isso vale para o modelo pequeno também. Já escrevi antes sobre Haiku e Qwen 4B ganharem do Opus em 30% dos meus casos reais: quando você para de forçar um modelo a se comportar como o outro, o pequeno vence em nichos onde o grande atrapalha. É a mesma filosofia aplicada a outra camada. Adapta o harness ao modelo, não o modelo ao harness.
Por que a Anthropic mede 150%
Dentro da Anthropic, engenheiros que adotaram o Claude Code no fluxo diário estão medindo 150% de aumento de produtividade em relação ao baseline anterior. Em alguns projetos, 100% do código está sendo gerado por IA. Engenheiros humanos revisam, decidem arquitetura, escrevem specs.
O número parece bonito demais, mas o mecanismo faz sentido se você aceita a filosofia. Se o desenvolvedor gastava metade do dia digitando código e a outra metade pensando na arquitetura, e agora a IA cobre o “digitar”, sobra o dobro de tempo para o “pensar”. O ganho vem daí: o humano recupera as horas que gastava no trabalho braçal.
Mas o número só sai se o humano parar de brigar. Se você continuar escrevendo regra sobre regra no CLAUDE.md, você está de volta a digitar código, agora em linguagem natural, com pior latência de feedback.
O engenheiro que ganha 150% é o que aprendeu a projetar o ambiente e sair do caminho.
O outro lado
Nem tudo é vitória da filosofia. Vou ser honesto sobre onde o “não brigue com o modelo” quebra:
Domínios com regulação forte. Se você processa dado sensível sob compliance, você não pode “confiar no modelo para inferir”. A proibição tem que estar explícita, e violá-la tem que quebrar o pipeline. Aqui a briga é feature, não bug.
Ambientes de produção. Em desenvolvimento, dá para deixar o modelo experimentar. Em produção, rm -rf proibido é o padrão certo. O ambiente muda, a filosofia se ajusta.
Modelos pequenos com contexto rígido. Um Qwen 4B rodando local não tem espaço para inferir intenção. Você precisa dizer explicitamente. A filosofia é uma escala móvel: quanto mais capaz o modelo, menos você precisa lutar.
O erro é aplicar como dogma. Ela funciona quando o modelo tem capacidade sobrando. Quando não tem, você trabalha diferente.
Cowork: a filosofia no limite
Cowork é a evolução recente do Claude Code que a Anthropic vem citando publicamente. Claude Code seguia o modelo “humano instrui, IA executa”. Cowork inverte: a IA trabalha autonomamente, e só chama o humano quando encontra uma decisão que precisa de julgamento.
Isso só funciona se você já levou a filosofia do TypeScript até o fim. Se você ainda está brigando com o modelo, ele te chama a cada 30 segundos. Se você projetou bem o ambiente, ele te chama uma vez por hora, com um problema real.
O gap entre esses dois estados é o que Boris descreve como o papel do engenheiro mudando: builder, PM, engineer virando a mesma coisa. A definição do cargo desliza de “quem escreve o código” para “quem projeta o ambiente onde a IA escreve o código”.
Um teste rápido
Um exercício que rodo no meu próprio setup uma vez por mês:
- Abro o
SKILL.mdouCLAUDE.mdmais longo que tenho - Conto quantas linhas começam com “não”, “nunca”, “sempre” ou uma proibição implícita
- Se passar de 20% do arquivo, é sinal de que estou brigando
Quando isso acontece, o exercício não é adicionar mais uma regra. É perguntar por que o modelo estava fazendo aquilo. Quase sempre é pista de ambiente mal projetado: a ferramenta é ambígua, o input tem ruído, o objetivo do prompt não está claro.
Corrija a raiz. As proibições viram redundantes sozinhas.
É contra o instinto do programador. Quem escreveu código antigo aprendeu a “defender” contra o pior caso: validação, sanitização, fallback. Isso funciona quando o outro lado é um cliente adversário. Cai por terra quando o outro lado é um modelo treinado com dezenas de milhões de exemplos, tentando adivinhar o que você quer.
Adivinhar mal, sim. Adversário, não.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev · TabNews
 Livro relacionado Practical Claude Code Tutorial de Claude Code | padrões de CLAUDE.md, design de Plan Mode e workflows de equipe Ver a página do livro →
Este artigo foi útil?