Claude Code hooks + lifecycle: 33 eventos
Passei três semanas tratando os hooks do Claude Code como um sistema de automação de scripts. Basicamente pre-commit com outra roupa. Só quando o mesmo agente repetiu o mesmo bug pela terceira vez é que caiu a ficha: hooks não são automação, são a camada de feedback loop do agente. E é isso que muda tudo.
Este é o post que eu queria ter lido na semana zero, em vez de me virar sozinho por três.
O erro de framing (o meu)
A documentação inicial do Claude Code apresentava hooks assim: “shell commands que rodam em pontos específicos do ciclo de vida.” Perfeito, entendi: é git hooks para o agente. Escrevi meu pre-commit.sh bonito, rodei eslint --max-warnings 0 antes de cada commit, e segui a vida.
O problema apareceu na semana três. O agente cometeu o mesmo bug de novo: rodou npm test sem primeiro rodar npm run build, e comitou um dist/ desatualizado. O hook pre-commit bloqueou. Consertei manualmente. Duas horas depois, o mesmo agente na mesma sessão fez de novo. E de novo. Três vezes em um dia.
Se hooks fossem “só automação”, eu deveria estar feliz: eles pegaram os três erros. Estavam funcionando. O agente é que estava burro.
Mas isso não é como agentes deveriam se comportar. Um humano júnior que erra três vezes seguidas no mesmo ponto significa que o feedback que ele recebe não está fechando o loop. O hook grita ”❌ Bloqueado”. O agente conserta o commit e tenta de novo, sem processar por que foi bloqueado.
Foi aí que eu abri a documentação de novo e vi o que tinha passado batido: existem 33 eventos de lifecycle no Claude Code, agrupados em fases. Eu tinha adotado 2.
Os 33 eventos, agrupados
A lista completa está no docs oficial da Anthropic. Aqui é o mapa mental que eu queria ter tido:
| Fase | Eventos representativos | Para que serve |
|---|---|---|
| Sessão | SessionStart, SessionEnd, Compact | preparar / recuperar contexto |
| Prompt | UserPromptSubmit, PreCompact | validar entrada, injetar policy |
| Ferramenta | PreToolUse, PostToolUse, PostToolUseFailure | pré-checagem / feedback ao modelo |
| Subagente | SubagentStart, SubagentStop | orquestração de sub-tasks |
| Fim | Stop, StopHook, Notification | limpeza / sinalização |
Se você usa só PreToolUse e PostToolUse, você está usando hooks como pre-commit clonado do git. Se você usa PostToolUseFailure + UserPromptSubmit, você está começando a fechar o feedback loop.
O evento chave que eu tinha ignorado era PostToolUseFailure. Ele não desfaz nada, mas expõe o stderr ao modelo. Isso muda o comportamento do agente na próxima iteração porque o modelo agora vê por que a ferramenta falhou. Sem esse evento, o hook pre-commit bloqueia mas o agente não sabe o quê o bloqueou. Ele tenta de novo cegamente.
4 loops de feedback, não 1
Depois de reescrever meu setup de hooks, cheguei a esta estrutura de quatro loops. Cada um tem uma latência e um propósito diferente.
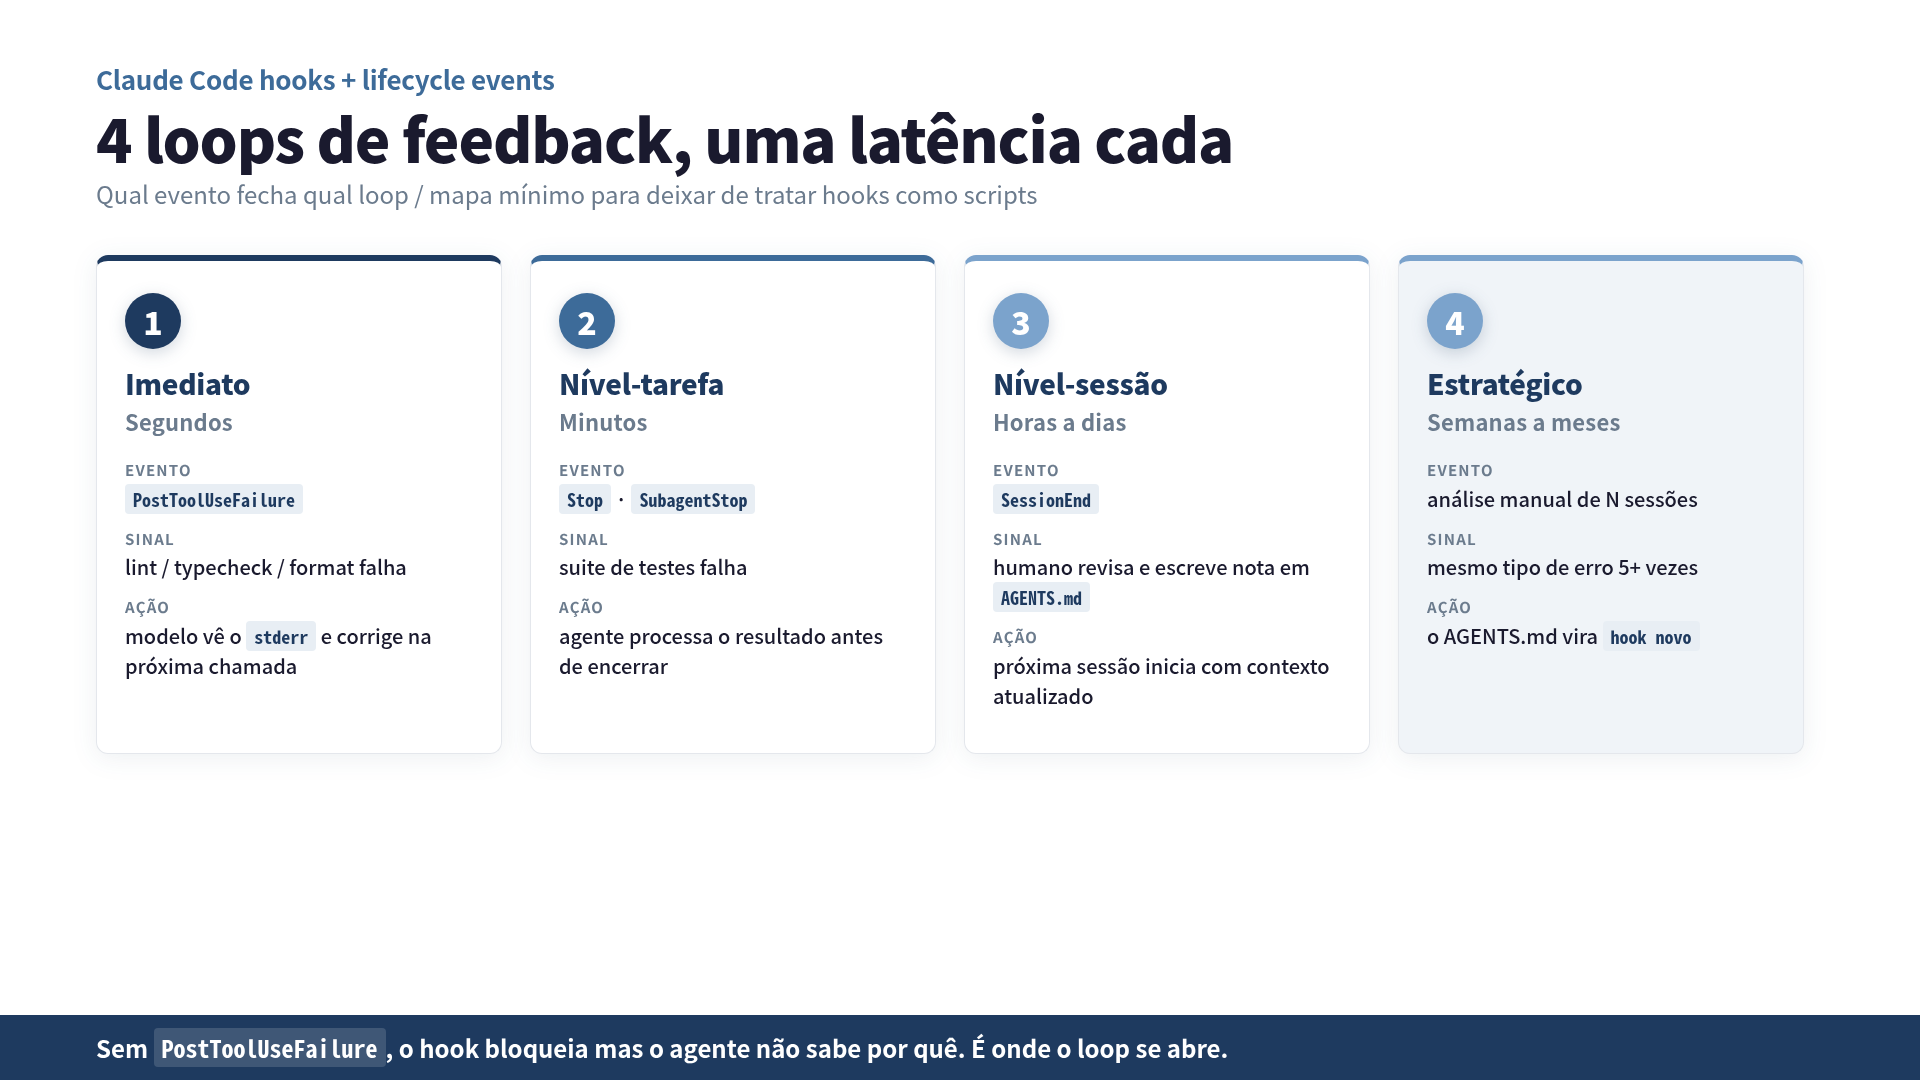
Loop 1: Imediato (segundos)
- Evento:
PostToolUseFailure - Sinal: lint / typecheck / format falha
- Ação: modelo vê o
stderr, corrige na próxima chamada
Type checks, linters e formatadores moram aqui. Não use PostToolUse genérico — use PostToolUseFailure especificamente para não poluir o contexto com sucessos.
Loop 2: Nível-tarefa (minutos)
- Evento:
StopouSubagentStop - Sinal: suite de testes falha
- Ação: agente processa o resultado antes de encerrar
CI, testes automatizados. O agente que roda npm test no fim da tarefa e vê 3 testes vermelhos processa isso antes do SessionEnd.
Loop 3: Nível-sessão (horas a dias)
- Evento:
SessionEnd - Sinal: humano revisa o trabalho e escreve nota em
AGENTS.md - Ação: próxima sessão começa com contexto atualizado
Reviews humanas moram aqui. Eu escrevo uma nota curta em AGENTS.md — três linhas, com o incidente e o que o agente deveria ter checado. A próxima sessão do agente começa com essa nota no SessionStart prompt.
Loop 4: Estratégico (semanas a meses)
- Evento: manual
- Sinal: análise de N sessões
- Ação: repensa a arquitetura de hooks
Todo mês eu leio os logs de PostToolUseFailure do mês anterior. Se um mesmo tipo de erro apareceu 5+ vezes, isso vira um hook novo, não uma linha nova no AGENTS.md. A regra que eu sigo: se o agente esquece 3 vezes, promove a restrição de “quase sempre” para “sem exceção.”
Esse é o insight que a SmartScope resumiu bem: “Escrever ‘rode o linter’ no CLAUDE.md vs. impor via hook é a diferença entre ‘quase sempre’ e ‘sem exceção.’”
O número concreto: 3 → 1 no meu repo
Antes de reestruturar os hooks:
- Meu repo
harness-opsrodava um agente diário para gerar posts - A mesma classe de bug (esquecer de rodar um passo antes de commitar) aparecia em cerca de 3 de cada 10 execuções
- Cada bug custava 15-20 min de rollback manual
Depois de adotar PostToolUseFailure + SessionEnd com nota em AGENTS.md:
- Mesma classe de bug: cerca de 1 de cada 10 execuções
- Redução de ~66% na taxa de repetição
- E principalmente: quando aparece o novo bug, é bug novo, não o mesmo de sempre
Não é um dataset científico. É meu repo, medido ao longo de 12 semanas. Mas o padrão é claro: hooks bem projetados transformam bug crônico em bug transitório.
O contrário do que a intuição diz
A intuição diz: “mais hooks = mais rígido = pior para o agente.” A prática mostra o oposto. Cada hook que exponha por que falhou torna o agente mais autônomo, não menos. O agente para de tropeçar no mesmo lugar porque enxerga o obstáculo.
Onde vale realmente ter cuidado é a quantidade de eventos que o modelo vê no contexto. PostToolUse genérico enche o contexto com sucessos irrelevantes. Isso, sim, degrada o agente. Escolha os eventos: falhas > sucessos, transições de fase > operações individuais.
Já cobri o extremo oposto — o que acontece quando o agente roda sem feedback loop nenhum — no Agente IA por 24 horas: incidentes de segurança. É o outro lado do mesmo problema.
Os 3 hooks que eu recomendo pra começar
Se você está começando com hooks agora, esta é a sequência que me daria o maior ROI em ordem:
PostToolUseFailure— expõestderrao modelo. É o hook que fecha o Loop 1.SessionEnd— grava resumo do dia emAGENTS.md. É o hook que abre o Loop 3.PreToolUsecom filtro de comandos destrutivos — bloqueiarm -rf,git push --force. Não é feedback loop, é guardrail.
Só quando esses três estiverem estáveis eu recomendaria olhar SubagentStart / SubagentStop para orquestração de sub-tasks paralelas. Antes disso, é ferramenta cara para problema que você ainda não tem.
O que eu não faço mais
- Não coloco regras “por favor” no
AGENTS.mdpara coisas que um hook pode fazer cumprir.AGENTS.mdé para intent, hooks são para enforcement. - Não ignoro
PostToolUseFailure. Sem ele, hooks são cegos para o agente. - Não uso
PostToolUsegenérico. Muito ruído, pouco sinal. - Não escrevo hooks sem exit code discipline.
exit 0= OK,exit 2= expõe stderr,exit 1= erro fatal. Confundir isso destrói o feedback loop.
Três semanas para chegar nesses quatro pontos. Espero economizar as suas.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev · TabNews
 Livro relacionado Harness Engineering Tutorial de Harness Engineering | design de AGENTS.md · implementação de hooks · operação de agentes de IA Ver a página do livro →
Este artigo foi útil?