arXiv 2603.25723: 6 campos de Harness formalizados, mapeei meu harness-ops
Até semana passada eu descrevia o que o meu harness-ops faz com uma frase do tipo “cron chama Claude Code CLI que lê uns markdowns e decide o que postar.” Funciona como pitch, mas é o tipo de descrição que me faz passar vergonha quando alguém pergunta “e como você compara isso com o de outro time?”. Não sei. Nunca medimos a mesma coisa.
Em março de 2026, Pan et al. publicaram arXiv 2603.25723 — Natural-Language Agent Harnesses. O paper faz uma coisa chata e útil: define, em uma frase da Section 3.1, os 6 campos que descrevem uma harness em linguagem natural. Com os 6 nomes na mesa, duas harnesses viram comparáveis mesmo quando o código embaixo é totalmente diferente.
Peguei meu ~/repos/harness-ops e tentei mapear as 4 camadas (Observer, Strategist, Marketer e o Evolver que roda em cron à parte) contra os 6 campos do paper. Cinco encaixaram sem ginástica. Um ficou vazio. E dois dos oito módulos opcionais que o paper testa na Table 5 pioraram o benchmark — reforçando a tese de que “mais harness” não é “melhor harness”.
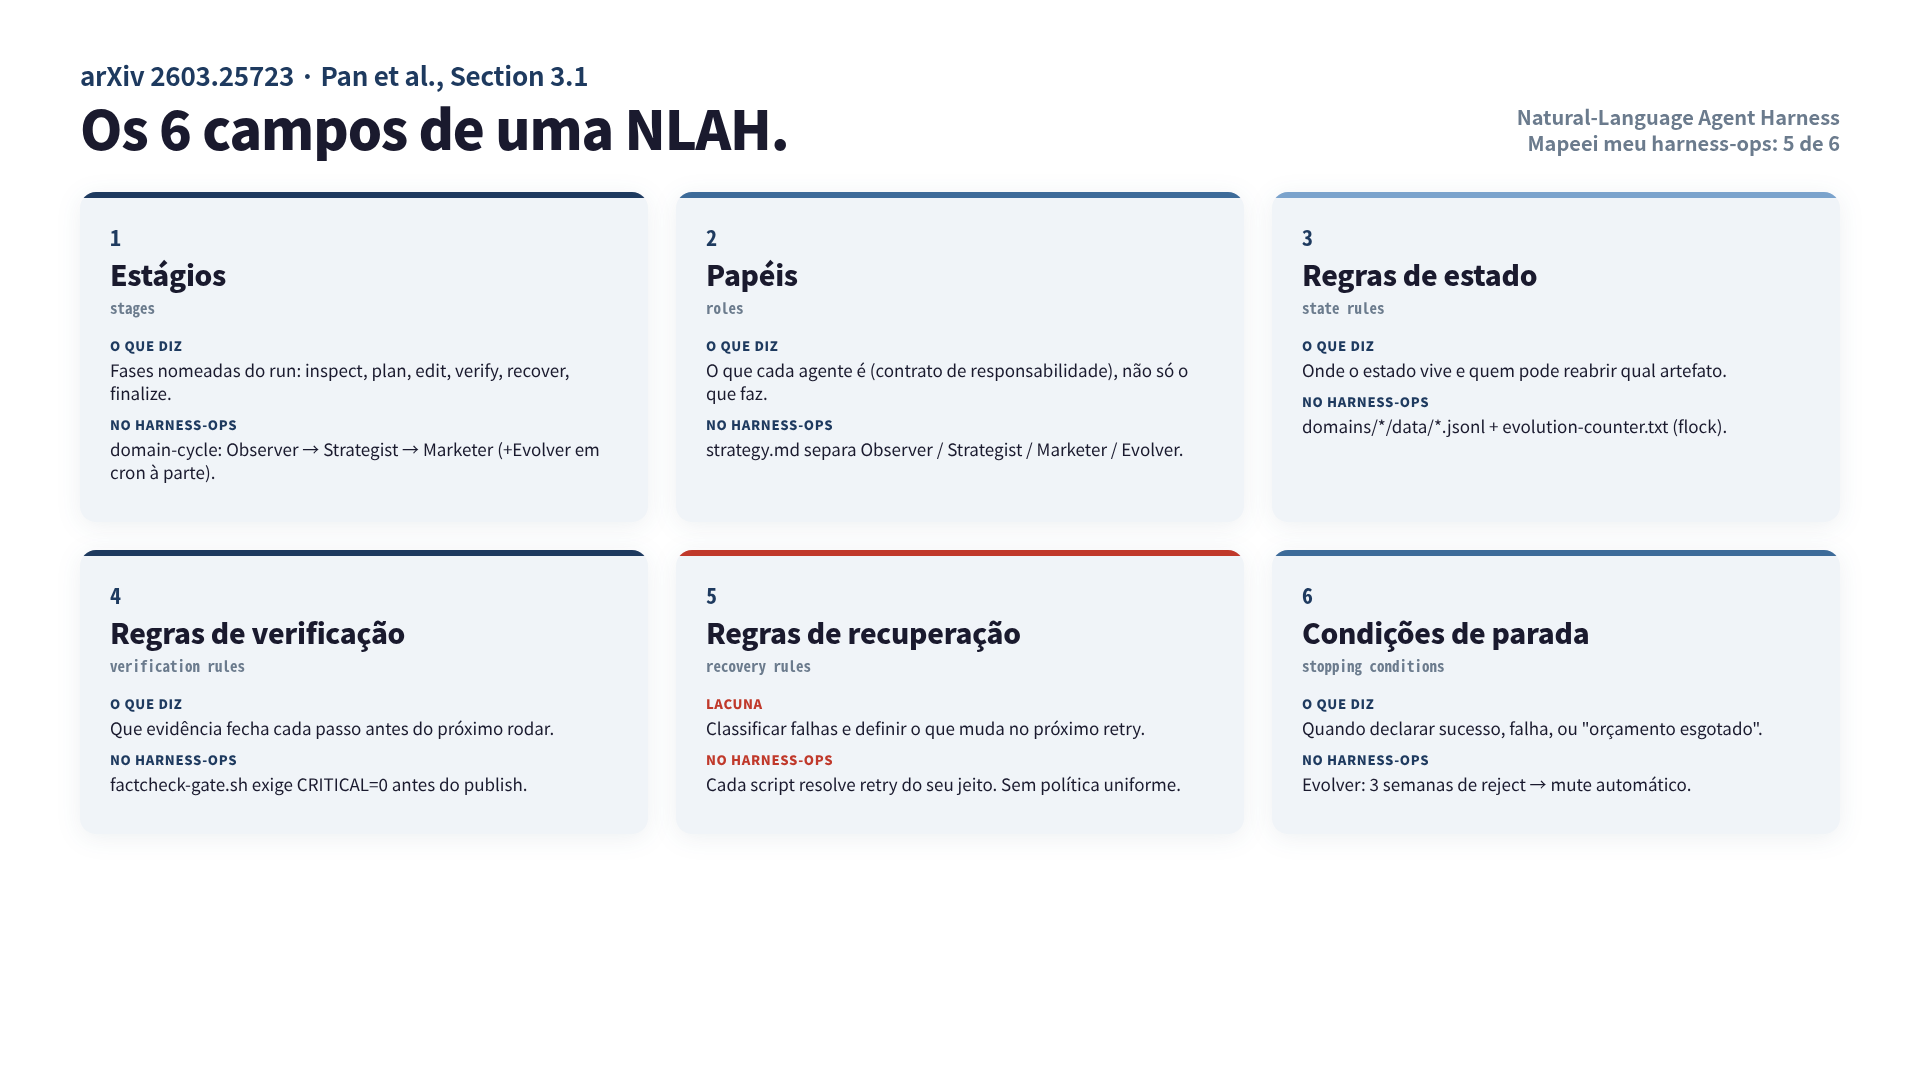
O que o paper realmente diz na Section 3.1
A frase-chave, verbatim do paper (traduzo abaixo):
The third layer is the NLAH: the natural-language policy document that describes the stages, roles, state rules, verification rules, recovery rules, and stopping conditions of a task run.
Em português, os 6 campos são:
- Estágios (
stages) — as fases nomeadas do run. O paper sugere nomes comoinspect,plan,edit,verify,recover,finalize. - Papéis (
roles) — o que cada agente é. Não “o que faz”: o contrato de responsabilidade. - Regras de estado (
state rules) — onde o estado vive entre passos e quem pode reabrir qual artefato. - Regras de verificação (
verification rules) — que evidência precisa aparecer antes do próximo passo rodar. - Regras de recuperação (
recovery rules) — como classificar uma falha e o que muda no retry. - Condições de parada (
stopping conditions) — quando declarar sucesso, falha, ou “orçamento esgotado”.
A escolha dos nomes é mais importante do que parece. Antes de ler o paper, eu misturava livremente “estágios” com “papéis” e tratava “regras de recuperação” como um sub-item de “regras de verificação”. A separação formal expõe lacunas que a prosa confortável esconde.
Por que isso vale 20 minutos de leitura
Pan et al. não estão vendendo IHR (Intelligent Harness Runtime, o executor próprio deles). O paper deixa isso explícito: a parte portável é a especificação em linguagem natural, não o runtime. A separação importa porque significa que você pode adotar o esqueleto dos 6 campos no seu Claude Code / Cursor / Codex sem trocar nada da infra.
O número que mais me chamou atenção é da Table 2: para a família Live-SWE-Agent, a política auditável do harness caiu de 60,1k tokens de código-controller para 2,9k tokens de NLAH. Para MHTBA (Meta-Harness para Terminal-Bench 2.0), caiu de 10,5k para 0,8k. É um fator >20× de compressão sem perda de desempenho — IHR-executed NLAH chegou a 73,0 em Live-SWE, enquanto o code harness original ficou em 67,0 (Table 1).
Traduzindo: a maior parte do “código de harness” não é mecanismo, é política escrita em linguagem natural fingindo ser if/else. Quando você escreve a política em prosa, o código residual é só o mínimo irredutível (parsers, sandboxing, chamadas de ferramenta).
O mapa do meu harness-ops: 5 encaixaram, 1 ficou vazio
Isso é o que eu encontrei quando sentei com o paper aberto do lado direito e tree ~/repos/harness-ops do esquerdo.
| Campo da NLAH | Onde vive no harness-ops |
|---|---|
| Estágios | Cada <domain>-cycle SKILL.md ordena Observer → Strategist → Marketer; Evolver roda num cron separado (sábados 09:00) |
| Papéis | domains/<name>/strategy.md separa Observer/Strategist/Marketer/Evolver dentro das 4 funções (Build, Market, Observe, Strategize) do CLAUDE.md |
| Regras de estado | domains/<name>/data/*.jsonl + core/data/evolution-counter.txt com flock |
| Regras de verificação | core/factcheck-gate.sh + factcheck-approved.jsonl bloqueiam publish-*.sh se CRITICAL>0 |
| Regras de recuperação | vazio — cada script resolve retry do seu jeito, sem política uniforme |
| Condições de parada | Evolver: diff20行 / 週2提案 / 3週連続却下でmute (do CLAUDE.md) |
A primeira reação foi “legal, 5 de 6, bati 83%.” A segunda reação foi “espera, o que exatamente eu faço quando um dos ciclos falha às 03h?” A resposta honesta: depende de qual script quebrou, e cada um resolve de um jeito. Alguns morrem silenciosamente. Alguns mandam Telegram. Alguns deixam partial state em jsonl que o próximo run tenta digerir. Nenhum classifica a falha.
Isso é exatamente a lacuna que o campo recovery rules nomeia. Antes eu teria chamado de “resiliência” ou “o retry está meio capenga” — frases que não permitem medir nada. Agora tem nome e tem lugar na política.
O detalhe inconveniente da Table 5
O paper não para em “6 campos existem.” A Table 5 testa 8 módulos opcionais que você pode adicionar à sua NLAH, e mostra o efeito sobre dois benchmarks (SWE Verified e OSWorld).
Dois módulos pioraram o resultado:
- Multi-candidate search:
-1,60em SWE Verified. O número de agent calls saltou de 1,1 para 5,7, mas o resultado caiu. Mais busca, menos acerto. - Context compression:
-1,00em SWE Verified e-8,30em OSWorld. É o pior resultado da tabela. O resumo “inteligente” do contexto piora as duas tarefas de uma vez só.
O terceiro módulo problemático é mais sutil: markdown memory deu +5,60 em OSWorld e -2,80 em SWE Verified. Útil para computer-use, nocivo para coding. É um “depende” que não vive bem num listão de boas práticas para “o seu agente.”
A conclusão que levei para o harness-ops: antes de adicionar um módulo porque li num blog da LangChain, ler qual benchmark Pan et al. usaram para julgar aquele módulo. Dos ciclos que eu já rodo, o único que seria candidato a “multi-candidate search” é o Evolver — e o paper me acabou de dizer que isso custa 5× mais agent calls para perder 1,6 ponto. Deu certo em não ter construído.
O que eu vou mudar essa semana
Três mudanças pequenas, uma por vez.
Primeiro, criar core/recovery-policy.md como o 6º arquivo canônico da harness-ops e começar com dois estágios: “ignorar e seguir” vs “parar o ciclo e notificar.” É menos do que o paper descreve, mas é algo que pode ser lido na segunda-feira de manhã quando um cron de domingo deu ruim.
Segundo, renomear mentalmente os blocos do strategy.md para os campos do paper. Isso não é um rename de arquivo — é vocabulário. Daqui a seis meses, se eu ou qualquer outra pessoa olhar para harness-ops, “regras de verificação” vai apontar sem ambiguidade para o factcheck-gate.sh, enquanto “o retry está meio capenga” vira discussão filosófica no Slack.
Terceiro, não adicionar context compression. Até num experimento. O paper já fez por mim.
O que isso não resolve
Falar em “6 campos” não transforma uma harness ruim em boa. O paper é um mapa, não um motor. A Table 4 mostra que o próprio IHR tem Information Handoff Recall de 0,322 em Live-SWE quando a execução passa por parent-child agents — ou seja, o handoff perde dois terços da informação que o prompt direto preservaria. Mesmo o autor da taxonomia admite que o próprio runtime ainda vaza nos cantos.
É um começo, não um fim. E para quem (como eu) chamava a própria harness de “o setup” uma semana atrás, começar com nomes certos já é uma mudança não trivial.
A versão original em inglês deste raciocínio, com um ângulo mais pessoal sobre vocabulário de time, está em arXiv 2603.25723 “Natural-Language Agent Harnesses”: 4 Patterns + 3 Anti-Patterns After 12 Weeks in Prod — se seu inglês de leitura técnica estiver afinado, leia os dois lados.
E se o conceito de “6 componentes” soar familiar, é porque eu já escrevi sobre uma taxonomia próxima, do Next Signal Prediction, em Prompt morreu, Context está morrendo: Harness Engineering é a próxima onda. Os dois recortes são compatíveis: Pan et al. é o acadêmico (o que precisa estar na política); NSP é o prático (quais arquivos materializam essa política).
Referências
- Natural-Language Agent Harnesses. Pan, Zou, Guo, Ni, Zheng. arXiv:2603.25723v2, 18 May 2026. Tsinghua / HIT-Shenzhen.
- Harness Design for Long-Running Applications. Anthropic Engineering blog, Nov 2025.
- The Anatomy of an Agent Harness. LangChain Engineering blog, Mar 2026.
Se você quer o passo-a-passo com AGENTS.md, CLAUDE.md, skills e hooks mapeados aos 6 campos, montei o guia completo em Guia Prático de Harness Engineering: do uso ao controle da IA.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev · TabNews
 Livro relacionado Harness Engineering Tutorial de Harness Engineering | design de AGENTS.md · implementação de hooks · operação de agentes de IA Ver a página do livro →
Este artigo foi útil?