GraphRAG perdeu da busca vetorial: 71,7 vs 60,8%
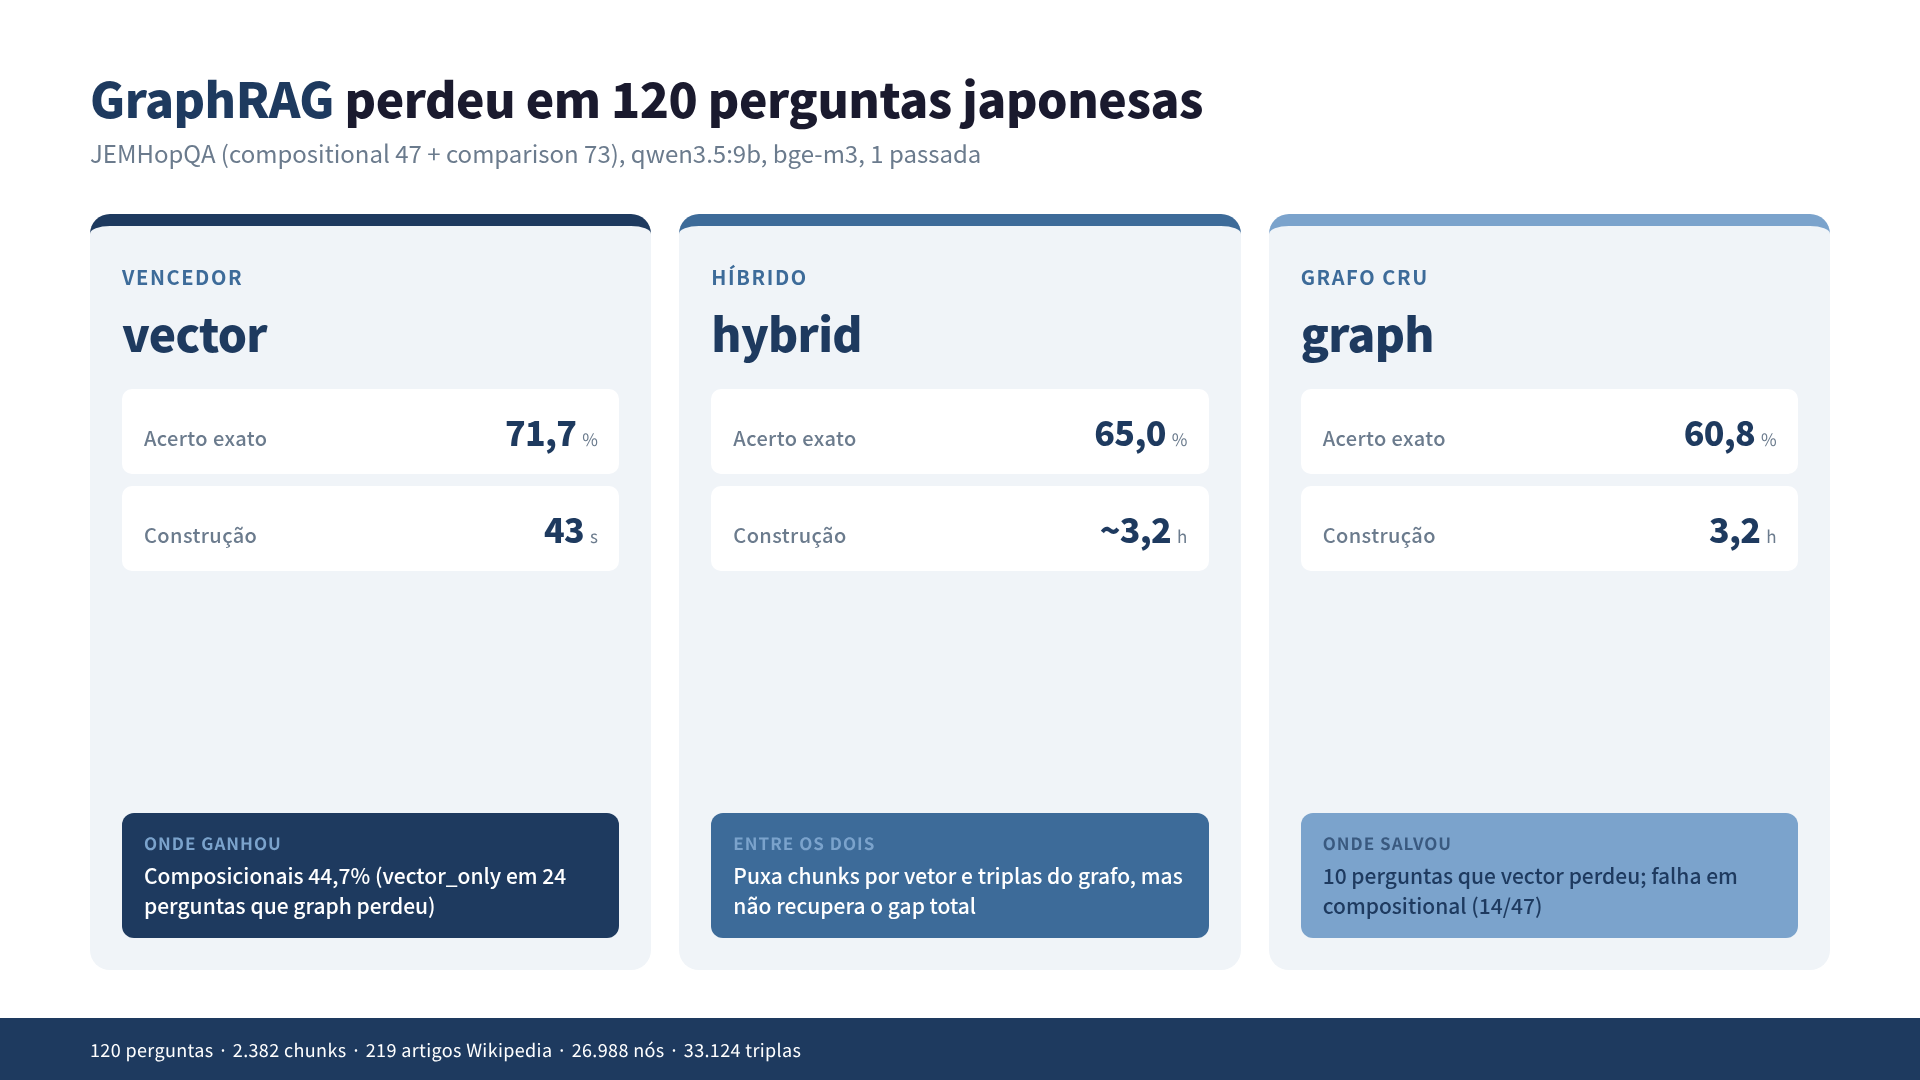
Montei o GraphRAG descrito no capítulo 5 do meu livro, apontei para 120 perguntas de multi-hop em japonês, e perdi para a busca vetorial clássica. 71,7% contra 60,8% de acerto exato. O grafo custou 3,2 horas de extração de triplas; o vetor custou 43 segundos de embedding.
A parte interessante não é a derrota. É onde ela aconteceu.
O que eu estava testando
GraphRAG é a técnica do Microsoft Research (2024-02) que indexa um corpus construindo um grafo de entidades e relações antes da consulta. A promessa é que, em perguntas multi-hop ("onde morreu o general que assinou X?"), a travessia do grafo encontra o caminho que a busca vetorial perde.
Eu descrevi essa mecânica no GraphRAG vs RAG clássico, em 4 projetos e ainda acho que o conceito faz sentido. Mas conceito não é número.
Então peguei o JEMHopQA (dev ver1.2, CC BY-SA 4.0), um benchmark japonês de multi-hop QA com 120 perguntas: 47 composicionais (duas inferências encadeadas) e 73 comparativas (A é maior que B?). Baixei os 219 artigos de Wikipedia referenciados, cortei cada um em 4.000 caracteres, dividi em 2.382 chunks de até 400 caracteres.
Para a camada LLM, usei qwen3.5:9b local via Ollama. Mesmo modelo para extração de triplas, extração de entidades da pergunta, e geração da resposta final. Temperature 0. Embeddings via bge-m3.
A implementação do GraphRAG foi o graphrag.py que escrevi para este teste, seguindo a mecânica descrita no capítulo 5 do livro: extração de triplas por chunk com schema JSON, grafo com networkx MultiDiGraph, busca por entidades da pergunta + vizinhança 1-2 hops. Sem resolução de identidade, sem detecção de comunidade, sem resumos. GraphRAG “cru”, do jeito que você escreve na primeira iteração.
Os resultados
Rodei 6 condições nas 120 perguntas, 1 passada cada, mesmo orçamento de contexto (3.000 caracteres).
| Condição | Acerto exato | Inclusão | Resposta tem o alvo |
|---|---|---|---|
none (só memória) | 46 (38,3%) | 47 (39,2%) | — |
vector | 86 (71,7%) | 88 (73,3%) | 49/75 (65,3%) |
graph | 73 (60,8%) | 74 (61,7%) | 38/75 (50,7%) |
hybrid | 78 (65,0%) | 79 (65,8%) | 45/75 (60,0%) |
graph_rk | 69 (57,5%) | 71 (59,2%) | 36/75 (48,0%) |
hybrid_rk | 76 (63,3%) | 78 (65,0%) | 42/75 (56,0%) |
A busca vetorial pura ganhou. O híbrido (trechos de grafo + chunks por vetor intercalados) chegou mais perto, mas ainda ficou atrás. O _rk é uma variante que reordena as triplas pela sobreposição de bigramas de caracteres com a pergunta — pensei que fosse ajudar e piorou.
Separando por tipo:
- Composicionais (47): vector 44,7%, graph 29,8%. Diferença de 15 pontos.
- Comparativas (73): vector 89,0%, graph 80,8%. Diferença de 8 pontos.
As comparativas são "X é maior que Y?" — 60% já é resolvido só com a memória do modelo. É nas composicionais, exatamente onde o grafo deveria brilhar, que ele mais perdeu.
Onde o grafo salvou (e onde quebrou)
Cruzando as 120 respostas com a métrica de inclusão:
- Vector e graph acertaram: 64 perguntas
- Só vector: 24 perguntas (quase sempre composicionais)
- Só graph: 10 perguntas
- Nenhum acertou: 22 perguntas
Então sim, existe um conjunto de 10 perguntas onde o grafo foi o único a chegar. Esse é o ponto que livros e posts de GraphRAG usam para vender a técnica. O problema é que o conjunto do adversário tem 24 perguntas. Para cada ponto que o grafo ganha, o vetor ganha 2,4.
Olhei caso a caso em que o grafo falhou. Dois padrões dominam.
Primeiro: o grafo não atravessa. 97,1% das linhas de triplas que entraram no contexto conectam diretamente a uma entidade da pergunta (seed). O orçamento de 1.000 caracteres de triplas é consumido pelo 1-hop. Para a pergunta “após qual guerra foi criada a instituição onde morreu Tojo Hideki?”, caíram 33 triplas, todas sobre Tojo. A ponte para Sugamo Prison nunca entrou.
Segundo: a normalização de nós é grosseira. No mesmo exemplo, o local de morte de Tojo virou um nó único de 50 caracteres: 日本・東京都豊島区西巣鴨一丁目(巣鴨拘置所) (“Japão, bairro de Nishi-Sugamo, Prisão de Sugamo”). O nó 巣鴨拘置所 extraído de outro artigo nunca se conecta a esse, porque a minha normalização é só NFKC + remoção de símbolos. Resolução de entidades resolveria, mas isso é um projeto à parte.
O custo de ter perdido
Construir o grafo foi caro, mesmo em LLM local.
| Item | Valor |
|---|---|
| Chamadas de extração ao LLM | 2.382 (uma por chunk) |
| Tempo total de extração | 11.478,7 s (≈ 3,2 horas) |
| Montagem do grafo (networkx) | 0,4 s |
| Triplas extraídas (sem self-loops) | 33.762 (33.124 únicas) |
| Nós / arestas | 26.988 / 33.762 |
| Embedding dos 2.382 chunks (bge-m3) | 43,3 s |
A extração é 99,7% do custo de construção. O grafo em si é instantâneo. Para o vetor, o indexador inteiro cabe em 43 segundos: duas ordens de magnitude de diferença, e isso considerando que a extração usa Q4_K_M em uma RTX 4070.
A inferência também não ajudou o grafo. Em tempo total das 120 perguntas, graph levou 176,3s contra 132,9s do vector — não é a vizinhança do grafo que custa (0,01s por pergunta), é a chamada extra de LLM para extrair as entidades da pergunta.
O que isso quer dizer
Não é “GraphRAG não funciona”. É “GraphRAG cru, do jeito que a maioria escreve na primeira iteração, não bate uma busca vetorial decente num benchmark multi-hop normal”.
A versão do Microsoft Research em From Local to Global adiciona três coisas que eu deixei de fora: resolução de identidade (nós equivalentes se fundem), detecção de comunidade com algoritmo Leiden, e resumos de comunidade por LLM. Esses três passos são caros — centenas de milhares de tokens de output por indexação — e eles existem porque a versão sem eles perde para a busca vetorial. É literalmente o resultado que eu reproduzi.
Então o próximo experimento vai medir se adicionar resolução de identidade e comunidade tira os 60,8% do lugar. Se não mover, significa que o problema é outro: a extração de triplas de qwen3.5:9b é fraca demais, ou JEMHopQA não é o benchmark certo para a técnica. Preciso descobrir qual.
Por enquanto, se você estiver escolhendo entre GraphRAG cru e busca vetorial pura para QA multi-hop em japonês, a resposta tem um número: use o vetor.
Os dados completos (chunks, triplas extraídas, respostas por condição, falhas rotuladas) estão em experiments/048-graphrag-vs-vector-jemhopqa no iris-lab. A implementação do GraphRAG usada no teste segue a mecânica descrita no capítulo 5 de Manual completo de Knowledge Graph.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev · TabNews
 Livro relacionado Manual completo de Knowledge Graph Manual completo de Knowledge Graph | GraphRAG · Neo4j · RDF · Tree-sitter · revisão de código por IA Ver a página do livro →
Este artigo foi útil?