Template de PR: 11 itens não marcam, 5-7 sim
O capítulo 8 do meu livro em PT Revisão de Código com Harness Engineering tem um princípio direto: “com mais de dez itens, ninguém marca tudo. O alvo é cinco a sete”. É uma frase curta que carrega uma decisão de design. Quando eu fui olhar templates de PR reais, descobri que quase ninguém segue — mas também descobri que a diferença entre os templates que funcionam e os que viram teatro cabe em três operações concretas.
Em Template de PR em 9 OSS: 3 renderizam zero eu já tinha medido o estado atual: Angular com 14 checkboxes, Django com 11, Electron com 7, Rails com 4, e três gigantes (Next.js, VS Code, Node.js) com template visível vazio porque tudo está dentro de <!-- ... -->. Este post pega o lado oposto da auditoria: como reduzir um template de 11 para 5-7 sem perder cobertura.
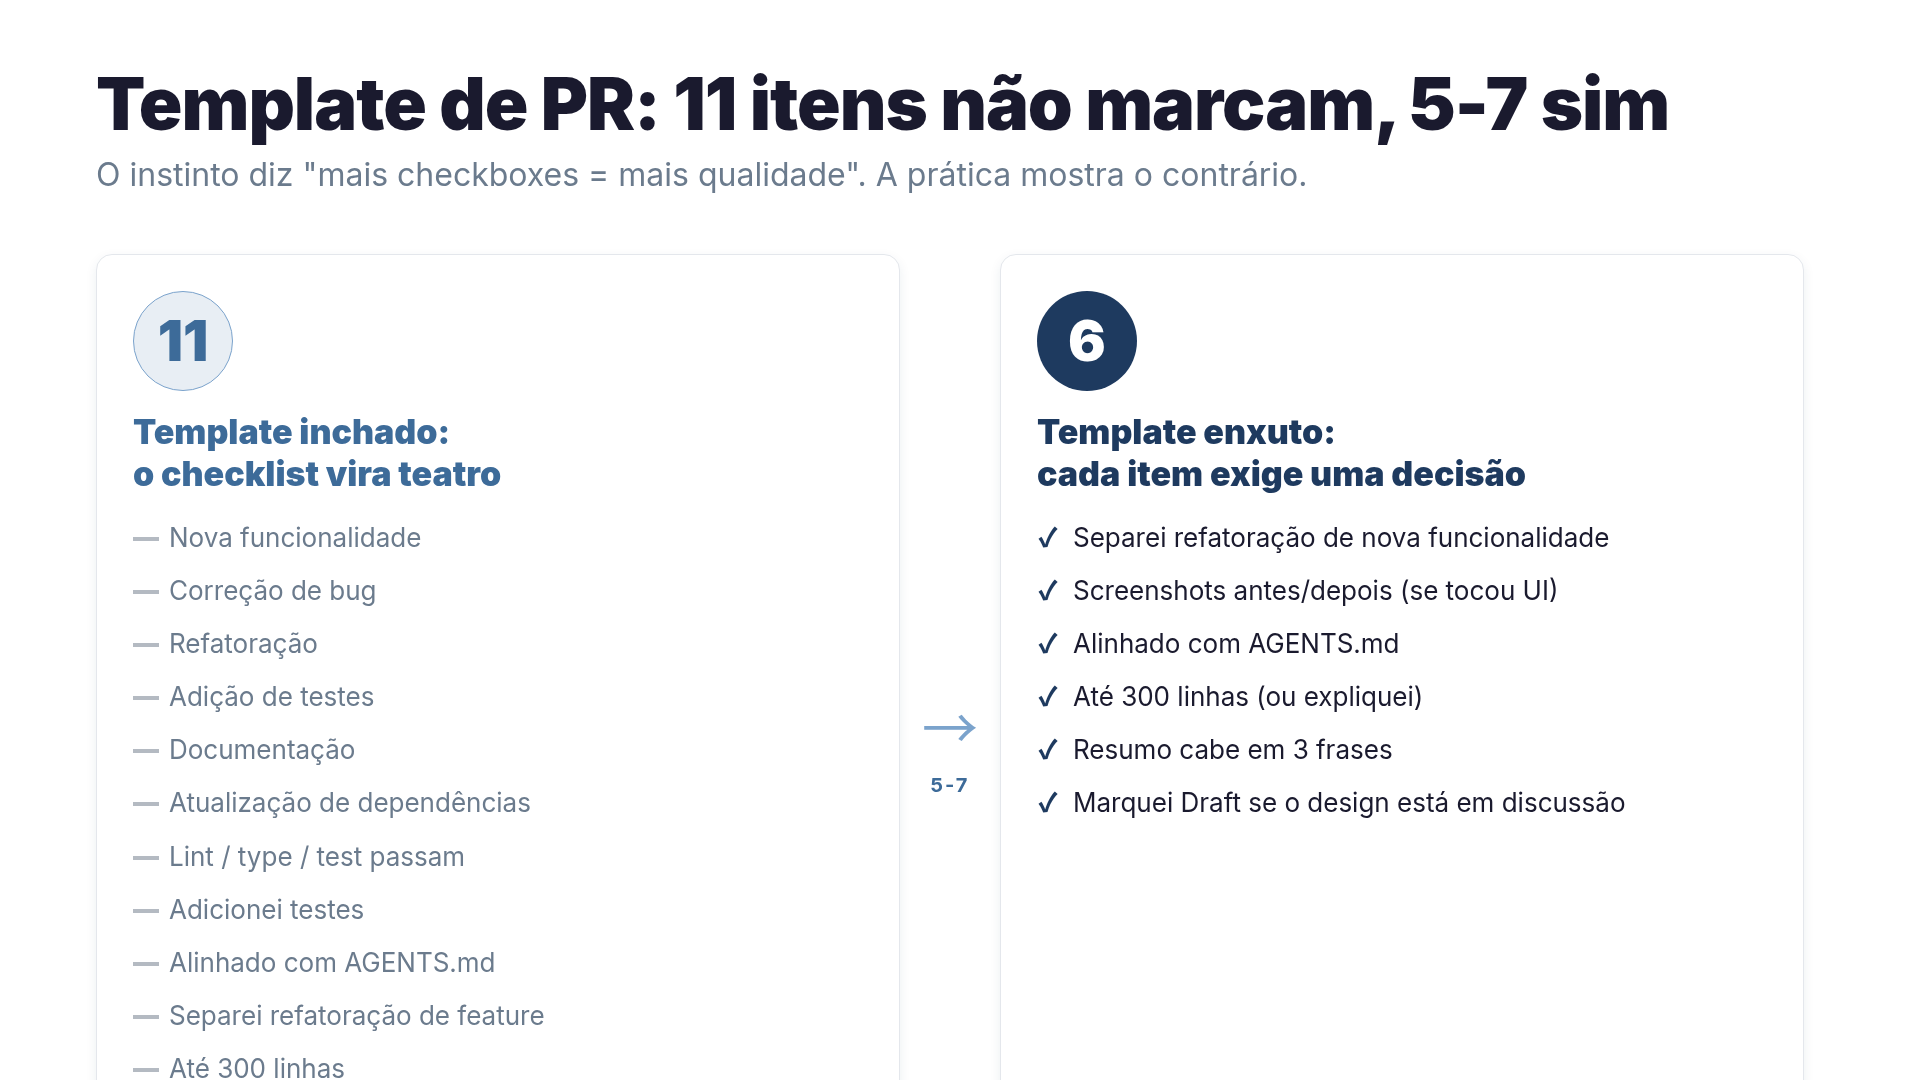
Por que 11 itens não marcam
Não é que o revisor seja preguiçoso. É que a lista grande vira ritual: você marca tudo no automático, ou pula tudo no automático. Nenhum dos dois estados representa uma decisão sobre a mudança.
A mecânica concreta é que o checklist conflita com o CI. Se o item [ ] Todos os testes passam está na lista e o pull_request workflow no .github/workflows/ já bloqueia PR com teste vermelho, o item é redundante. O autor marca sem pensar porque o CI já respondeu. A partir do momento em que um item do checklist é marcado sem pensar, a norma do checklist inteiro é “marcar sem pensar”. O item que o CI não cobre, enfiado no meio, afunda junto.
Esse é o mesmo padrão que descrevi em Escrevi ‘testes antes do PR’ no AGENTS.md por 3 meses. Só 12% seguiram: regra sem portão não vira comportamento. Um checklist com itens redundantes é uma regra sem portão em dez linhas, só mais barulhenta.
Django com 11 checkboxes é o exemplo público mais acessível. Se você abrir o template dele (.github/pull_request_template.md na branch main), vai encontrar:
- Dois itens de disclosure de IA.
- Cinco itens que são afirmações sobre política do projeto (segue contribution guidelines; não divulga vulnerabilidade; branch alvo é
main; mensagem de commit no passado; não vai pedir review automático por IA). - Quatro itens que são conformidades:
Has patchno Trac, testes adicionados, docs atualizadas, screenshots light/dark.
Nenhum autor consegue olhar isso e marcar cada um como uma decisão separada. O que acontece na prática é que o autor marca os quatro últimos no final do PR (quando sabe que já tem teste e doc), e os sete do meio ficam no modo “ok, concordo em tese”.
A regra do 5-7 não é mística
O número 5-7 do livro é um teto prático, não uma lei neurobiológica. O capítulo apresenta como heurística, com a justificativa simples: lista pequena vira ponto de decisão por item; lista grande vira ritual de marcar em massa. A diferença entre 7 e 8 não é mágica; a diferença entre 7 e 14 é a estrutura inteira do fluxo.
A heurística prática que o capítulo propõe tem três princípios, em ordem:
- Encurte: alvo 5-7 itens.
- Seja concreto: cada item precisa ser verificável sem ambiguidade.
- Tire o que dá para automatizar: se o CI já bloqueia, não ocupa linha do checklist.
Aplicando os três no caso Django: o item A PR targets the main branch é verificável no CI (github.base_ref == 'main' em workflow). O item commit message is written in past tense é verificável em CI com um linter de commit (há vários — commitlint, gitlint, conform). Esses dois saem. Os dois itens de disclosure de IA podem virar um item com duas opções no corpo do PR em vez de dois checkboxes separados — a decisão é mutuamente exclusiva. O item follows the contribution guidelines é abstrato demais pelo princípio 2; o leitor ou segue de fato ou marca por reflexo, e nunca sabemos qual. Esse também sai.
De 11 fica em 7: disclosure de IA (unificada), não divulga vulnerabilidade (processo), compromisso de não pedir review automático por IA (política), testes adicionados, docs atualizadas, screenshots light/dark, Trac flag. No topo do alvo.
Os 5 itens que o livro propõe
O template do capítulo 8 fica com cinco checkboxes na seção “Auto-checagem”:
## Auto-checagem
- [ ] Os portões automáticos (lint / type check / test) estão todos passando
- [ ] Adicionei ou atualizei os testes
- [ ] Está alinhado com a "Code Direction" do AGENTS.md
- [ ] Separei refatoração de nova funcionalidade (se estiverem misturados, explique aqui)
- [ ] Até 300 linhas (se passar, explique a razão da divisão)
Note o que não está aqui:
- Não tem “Fiz revisão do meu código”. É abstrato. Se o autor não revisou, marcar não muda nada.
- Não tem “Segui o guia de contribuição”. Pelo mesmo motivo.
- Não tem “Todos os testes passam” sem qualificar. Está qualificado como “portões automáticos”, o que torna explícito o conjunto (lint + type check + test) e evita duplicata do CI em três linhas.
Os cinco restantes são todos verificáveis sem ambiguidade. Cada um exige uma decisão: ou é verdade e marco, ou é falso e explico, ou é inaplicável e deixo em branco. Não dá para marcar por reflexo.
Por que o item “até 300 linhas” não é checklist comum
O quinto item merece parágrafo próprio porque ele faz um trabalho diferente dos outros quatro. “Até 300 linhas” não é uma verificação de qualidade do código — é uma restrição de tamanho do próprio PR.
A escolha do número não é arbitrária. O white paper clássico da SmartBear (“Best Kept Secrets of Peer Code Review”, baseado em dados da Cisco e publicado por Jason Cohen em 2006) relatou que a eficácia de detecção de defeitos cai rapidamente acima de ~400 linhas por review. As “eng-practices” do Google (google.github.io/eng-practices) argumentam no mesmo sentido com “small CLs” como norma. 300 linhas é um corte conservador dentro dessa faixa, com margem para o PR que inclui teste junto com código.
O item está no checklist, e não só em CI, por um motivo específico: PR grande que precisa ser dividido é uma decisão que o autor toma antes de abrir o PR. Depois de aberto, dividir dá retrabalho — rebase, reescrita de commits, perda da história. Deixar o item como auto-check obriga o autor a parar antes de clicar “Create pull request” e perguntar: “isso aqui cabe em 300 linhas, ou eu já deveria estar dividindo em dois?”. Nenhuma automação consegue fazer essa pergunta no momento certo.
A exceção explícita no texto do item (“se passar, explique a razão da divisão”) é o que distingue o item de uma regra cega. PR de 450 linhas que inclui uma refatoração grande justificada pela mudança funcional é defensável. O que não é defensável é PR de 1200 linhas que ninguém olhou direito. A diferença mora na frase de explicação.
O “Tipo de mudança” não entra na contagem
O capítulo 8 propõe o template inteiro com uma seção Tipo de mudança acima da Auto-checagem:
## Tipo de mudança
- [ ] Nova funcionalidade
- [ ] Correção de bug
- [ ] Refatoração (sem mudança funcional)
- [ ] Adição de testes
- [ ] Documentação
- [ ] Atualização de dependências
Esses seis itens parecem levar o template de volta para 11. Mas eles não funcionam como checklist no sentido de “autor marca que cumpriu N coisas”. Funcionam como seleção mutuamente exclusiva — o autor marca um (às vezes dois), para que o revisor saiba de que tipo de mudança está lidando antes de abrir o diff. É classificação, não verificação.
A diferença prática: o revisor que vê [x] Refatoração (sem mudança funcional) entra na review esperando git diff sem mudança de comportamento, e vai cobrar justificativa se encontrar if novo. O revisor que vê [x] Nova funcionalidade entra esperando teste e mudança de contrato. É a mesma mudança no diff, lida de forma diferente a depender da classificação.
Esses seis não entram na “regra 5-7” porque não compartilham o problema do checklist longo. Marcar um deles é uma decisão (as outras cinco opções são explicitamente não), então a mecânica de “marcar sem pensar” não se instala.
O que fica, do exercício
Resumo as três coisas que eu levo da leitura cruzada entre o capítulo 8 e os templates reais:
1. Checklist e CI competem pela atenção do autor. Cada item do checklist que o CI já cobre treina o autor a marcar sem olhar. O custo não é o item redundante — é a norma de “marcar sem olhar” que vaza para os itens não redundantes.
2. O limite 5-7 é um teto de atenção, não um alvo de completude. Reduzir de 11 para 6 não significa que o template cobre menos; significa que cobre com itens que exigem decisão. Cobertura virtual (11 itens marcados por reflexo) é zero. Cobertura real (6 itens com decisão) é 6.
3. “Até 300 linhas” é a única regra do template que atua antes do PR existir. Os outros itens são verificações sobre o PR aberto. Esse é o único que faz o autor parar e dividir antes de abrir. Vale ocupar uma linha por isso.
A proposta não é copiar o template do capítulo 8 letra por letra para o seu repositório. É olhar o template atual, contar quantos itens o seu CI já verifica (candidatos a cortar), quantos itens são abstrações sem forma concreta de medir (candidatos a cortar), e descer até ficar na faixa 5-7 de itens que exigem decisão. O resto o GitHub Actions resolve, e o template para de ser teatro.
Referências
- Capítulo 8 do livro Revisão de Código com Harness Engineering: “Automatizando o template de PR e o checklist de revisão” — Kindle Brasil (BRL 24,99).
- Auditoria dos 9 templates de OSS reais: Template de PR em 9 OSS: 3 renderizam zero.
- Experimento de conformidade com AGENTS.md (12%): Escrevi ‘testes antes do PR’ no AGENTS.md por 3 meses. Só 12% seguiram.
- Template de PR do Django (11 checkboxes, verificado em 2026-10-07): django/django
.github/pull_request_template.md. - Google eng-practices sobre small CLs: google.github.io/eng-practices/review/developer/small-cls.html.
- Versão japonesa da série no Zenn: zenn.dev/kenimo49/books/harness-code-review.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev · TabNews
 Livro relacionado Revisão de Código com Harness Engineering Revisão de código em três camadas | hooks + IA + humano · AGENTS.md · CodeRabbit · GitHub Actions Ver a página do livro →
Este artigo foi útil?