Memória de agente: 7 arquivos, não carregue tudo
Clonei o skeleton do OpenClaw no meu laptop, abri a pasta, vi sete arquivos Markdown (AGENTS.md, SOUL.md, TOOLS.md, IDENTITY.md, USER.md, HEARTBEAT.md, MEMORY.md), e minha primeira reação foi a mais previsível possível: “ótimo, mando os sete no system prompt a cada sessão e acabou”. Fechei o editor. Fui tomar café. Marquei “arquitetura de memória” como feito.
Depois eu abri o Capítulo 9 do livro de Context Engineering que estou escrevendo, releio o próprio material que eu mesmo defendo, e o parágrafo de abertura dizia, com todas as letras: “forneça apenas a informação que você precisa, no momento em que precisa”. Em seguida, a frase que me pegou: carregar os sete juntos é o default errado.
Este post é o inventário honesto do que eu encontrei quando abri ~/.openclaw/workspace-anthropic/ e contei linha por linha, mais as três regras de corte que o Ch09 propõe para não enfiar os sete no prompt. Nenhuma dessas regras é descoberta minha, todas estão no livro, no capítulo que eu assinei. Minha contribuição aqui é confrontar o skeleton de verdade com elas e ver o que acontece.
Os 7 arquivos, com o tamanho que eles têm no meu disco
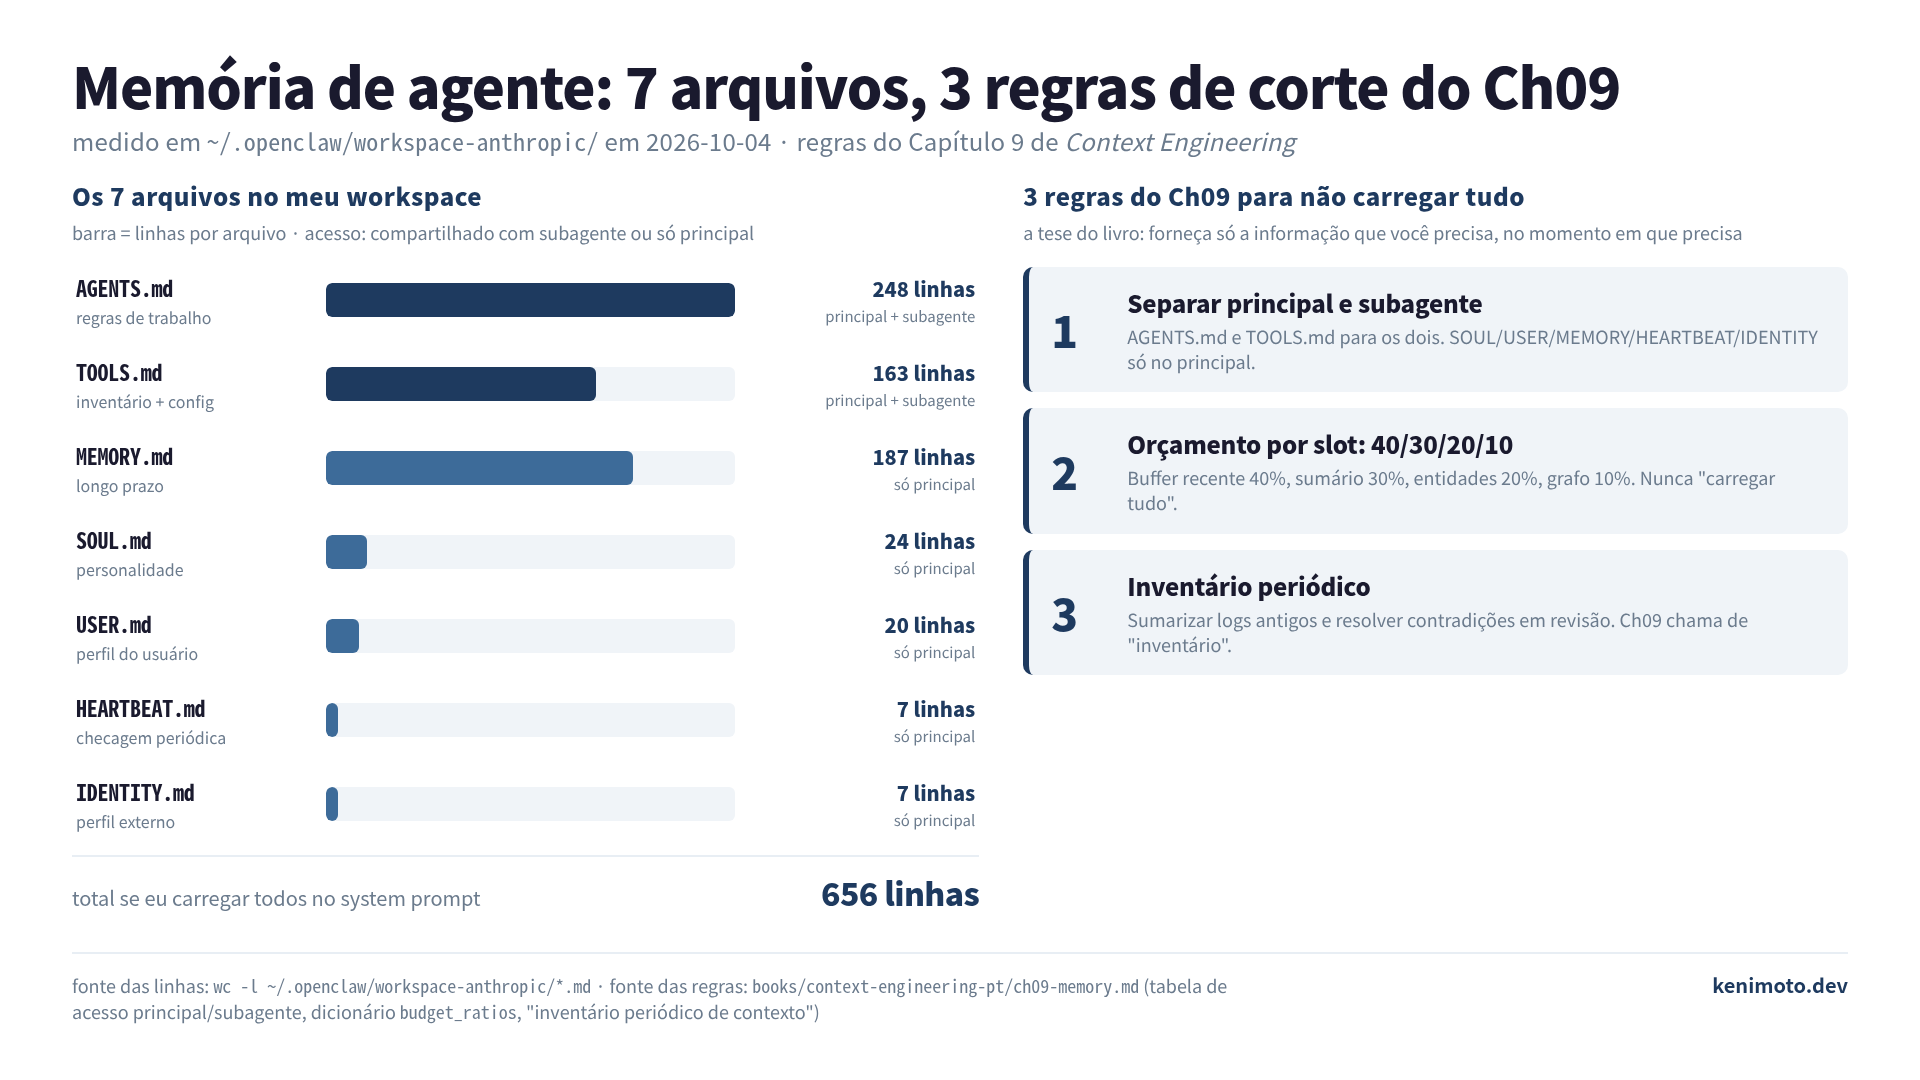
A primeira coisa que fiz foi rodar wc -l nos arquivos do meu workspace, antes de qualquer teoria. Mediu em 2026-10-04, ~/.openclaw/workspace-anthropic/:
| Arquivo | Linhas | Papel | Acesso |
|---|---|---|---|
AGENTS.md | 248 | regras comuns de trabalho | principal + subagente |
TOOLS.md | 163 | inventário de ferramentas + config local | principal + subagente |
MEMORY.md | 187 | memória de longo prazo | só principal |
SOUL.md | 24 | personalidade, caráter, relações | só principal |
USER.md | 20 | perfil do usuário | só principal |
HEARTBEAT.md | 7 | checagem periódica da sessão | só principal |
IDENTITY.md | 7 | perfil para o exterior | só principal |
Soma: 656 linhas. Não é absurdo. Muito longe de “contexto estourou”. Mas é o tamanho que entra em toda sessão, sem filtro, se eu seguir a tentação do primeiro parágrafo e colocar os sete no system prompt do agente principal. Em uma conversa de três horas com 40 trocas, isso é 656 linhas vezes 40, repetidas em cada chamada ao modelo. A conta é feia só pelo custo de token. A conta de atenção do modelo é pior.
O ponto que vale isolar: os sete arquivos não existem para serem todos lidos sempre. Eles existem porque cada tipo de contexto (quem eu sou, com quem converso, o que a sessão está monitorando, memória longa) tem lugar próprio para ser atualizado sem interferir nos outros. A seleção é feita depois, com critério.
Por que “carregar tudo” é o default errado
A tentação de carregar tudo é um reflexo de segurança: se eu enfiar toda a memória no prompt, o modelo não vai esquecer nada. O problema é que esquecer não é o único modo de falha de contexto. O Ch09 lista quatro, baseado em pesquisa de 2025 sobre conversas longas em LLMs:
- Context Poisoning: informação errada contamina o contexto e distorce respostas posteriores.
- Context Distraction: informação irrelevante demais, foco borra.
- Context Confusion: múltiplos tópicos se misturam e o modelo cruza contextos.
- Context Clash: informação contraditória coexiste e as respostas ficam instáveis.
Três dos quatro (Distraction, Confusion, Clash) ficam piores quando você carrega mais. Só Poisoning fica igual, porque depende da qualidade da informação, não da quantidade.
Vale a honestidade aqui: eu não tenho benchmark próprio desses quatro modos de falha. Não rodei A/B comparando “sete arquivos no prompt” contra “seleção dinâmica” em uma tarefa controlada no meu agente. A afirmação “carregar tudo degrada” vem da revisão de literatura que o próprio capítulo faz e das observações qualitativas dos operadores do OpenClaw. O que eu posso provar com minha máquina é só o tamanho dos arquivos. O resto é hipótese do capítulo, que eu adotei como premissa de desenho e não como medição minha.
Isso ainda vale como razão para não carregar tudo? Vale, porque o custo de aplicar as três regras é baixo e o risco de o default errado estar certo “por acaso” não compensa o acerto. Mas quero deixar claro onde está a evidência e onde está a herança.
Regra 1 — Separar o que o principal vê do que o subagente vê
O OpenClaw opera com um agente principal (a conversa que você vê) e subagentes (tarefas delegadas, como “corrige esse teste”, “sumariza esse log”). O Ch09 define uma matriz de acesso explícita, que eu copio literal:
| Arquivo | Agente principal | Subagente | Razão da restrição |
|---|---|---|---|
AGENTS.md (regras de trabalho) | sim | sim | regras comuns todo mundo precisa |
TOOLS.md (info de ferramentas) | sim | sim | necessário para o trabalho |
SOUL.md (personalidade) | sim | não | subagentes não precisam |
USER.md (info de usuário) | sim | não | segurança |
MEMORY.md (memória passada) | sim | não | economia de tokens, prevenção de vazamento |
HEARTBEAT.md | sim | não | função exclusiva do principal |
IDENTITY.md | sim | não | perfil externo só do principal |
A intuição do capítulo é tratar subagente como contratado por tarefa: dê o mínimo necessário, focado no escopo específico. Se um subagente que escreve testes precisa saber qual é a personalidade do agente principal, alguma coisa está mal cortada no desenho da delegação.
No meu workspace, aplicar essa regra significa não enviar SOUL.md (24 linhas) nem USER.md (20) nem MEMORY.md (187) nem HEARTBEAT.md (7) nem IDENTITY.md (7) quando eu disparo um subagente. São 245 linhas que não entram no prompt dele, de um total de 656. Quase 37%. A economia de token é um bônus; o importante é que o subagente não começa a imitar a personalidade do principal porque “estava no contexto”.
Vale uma nota prática: configurar essa separação no agent-SDK (ou em Claude Code via skills, ou no OpenClaw via wrapper) exige explicitamente dizer o que não é herdado. O default da maioria dos frameworks hoje é herdar tudo. Isso precisa ser invertido no seu config.
Regra 2 — Orçamento dinâmico por slot, 40/30/20/10
Essa é a parte que mais me doeu reconhecer, porque é a mais técnica e a que eu mais quis evitar quando montei o skeleton. O Ch09 propõe um dicionário fixo de proporções para alocar o orçamento de tokens entre quatro slots de memória:
budget_ratios = {
    "recent_buffer":        0.4,   # 40% — troca mais recente
    "conversation_summary": 0.3,   # 30% — sumário passado
    "relevant_entities":    0.2,   # 20% — entidades relacionadas
    "knowledge_graph":      0.1,   # 10% — relações detalhadas
}
Três pontos a desempacotar.
Primeiro: buffer recente sempre ganha a fatia maior, independente de relevância. Faz sentido porque a troca atual contém o pronome e o referente da próxima resposta (“faz assim”, “aquele arquivo que você mencionou”). Se o buffer encolhe para liberar espaço para RAG, o modelo passa a inventar o referente. Vi isso em agentes meus que tentei forçar RAG agressivo demais.
Segundo: grafo de conhecimento é o slot mais caro em tokens por bit de informação útil. Por isso ele é o menor (10%). Grafo só vale a pena quando a tarefa pede relação explícita entre entidades (“quem reporta a quem”, “qual módulo depende de qual”). Se a tarefa é “escreve esse teste”, grafo de conhecimento é mobília desnecessária no prompt.
Terceiro: as porcentagens flexionam, mas a soma segue 100%. Se a entidade está muito relevante nesta troca (ex: o usuário acabou de mencionar um nome próprio que só o grafo mapeia), o slot de entidade expande tomando de outro slot. Não “pede mais orçamento”. Esse detalhe é o que separa a implementação ingênua (“expande o que for relevante”) da implementação do Ch09 (“priorize, não acumule”).
Para o meu workspace, isso significa que MEMORY.md (187 linhas) nunca entra inteira. Ela é a fonte do slot conversation_summary, e ao entrar passa por sumarização e filtro de relevância. É a diferença entre ter memória longa e despejar memória longa.
Regra 3 — Inventário periódico, quando dói, não quando o calendário manda
A terceira regra é a mais fácil de descrever e a mais fácil de ignorar na prática. O Ch09, no comentário sobre os quatro modos de falha de contexto, encerra com uma frase curta que eu grifei:
“‘Inventário’ periódico de contexto (sumarização de info antiga, resolução de contradições) importa.”
Inventário aqui quer dizer sentar com os seus arquivos de memória de longo prazo (MEMORY.md, logs em memory/YYYY-MM-DD.md) e fazer três coisas: compactar o que ficou verboso, resolver contradições entre entradas, e marcar o que está obsoleto. Não é um ritual novo, é a parte que a maioria dos operadores pula.
Minha tentação quando li isso foi definir “faço inventário toda semana, no domingo às 20h”. Resisti, por dois motivos. Um: eu não tenho dados próprios dizendo que semanal é a cadência certa, nem o livro propõe cadência fixa. Dois: calendar-driven acaba virando ritual vazio, inventário feito só porque “é domingo” não resolve nada. O que faço na prática é um gatilho reativo: quando eu noto que o agente está respondendo com decisão desatualizada ou está me pedindo contexto que já está em MEMORY.md, aí eu paro e faço o inventário. É irregular. É honesto.
Reconheço o risco dessa escolha: inventário sem cadência pode nunca acontecer se eu não notar a decisão desatualizada. O remédio que estou testando é um HEARTBEAT.md (os sete linhas que você viu na tabela) que lembra, dentro da própria sessão, de checar se há sinais de contexto podre. É inventário leve, no fluxo. Inventário pesado, aquele que exige revisar o MEMORY.md linha a linha, continua sem cadência fixa.
O que eu não estou afirmando
Vale deixar o perímetro bem desenhado, porque esse tipo de post facilmente vira folclore se o leitor extrapolar:
Não estou medindo “precisão caiu em X%” entre carregar tudo e aplicar as três regras. Não rodei esse A/B no meu agente. O que eu rodei foi wc -l nos sete arquivos. As três regras de corte são do Ch09, não minhas, e eu as apliquei no meu config antes de ter dados próprios dizendo que elas resolvem.
Não estou dizendo que esse é o único layout de memória que funciona. Memory tool da Anthropic, approach de “zero file, tudo no vector store”, MCP memory server, todas são alternativas que fazem compromissos diferentes. O layout de sete arquivos é a opinião do OpenClaw sobre separação de preocupações. Eu adotei porque os arquivos são Markdown versionável em git, e eu valorizo isso. Se você valoriza outra coisa (menor latência, menos cerimônia), a conclusão pode ser outra.
Não estou prometendo que budget_ratios = {0.4, 0.3, 0.2, 0.1} é universal. É o default proposto pelo capítulo, baseado em observação qualitativa. Para o seu domínio (RAG agressivo? grafo pesado?) os pesos podem ser outros. O que não muda é a disciplina de ter slots com orçamento fixo em vez de “injeta o que for relevante até estourar”.
O que isso muda no seu config esta semana
Se você quer aplicar sem reler o capítulo inteiro, três mudanças no seu agent config fazem o essencial:
- No wrapper que monta o system prompt do subagente, declare explicitamente quais arquivos não entram. A matriz da regra 1 é um bom ponto de partida.
- Antes de injetar sua “memória” (MEMORY.md, logs, vector store), aplique a repartição por slot. Mesmo se você não calibrar os pesos, só o ato de separar em slots já evita o modo “despeja tudo que achar relevante”.
- Em vez de calendário, defina um sinal de gatilho de inventário. Pode ser “quando o agente pede duas vezes a mesma informação”, ou “quando a resposta contradiz decisão registrada em
MEMORY.md”. Qualquer coisa menos “fazer no domingo”.
Se você quer o quadro completo (quatro arquiteturas de memória comparadas, o padrão MEMORY.md em detalhe, a receita de implementação em estágios), o Capítulo 9 inteiro está no livro de Context Engineering. Esse post é um recorte de uma seção, aplicada em um workspace.
Para o lado adjacente da conversa (o debate AGENTS.md versus CLAUDE.md, quem lê o quê quando o repositório tem os dois), olha o post de AGENTS.md ou CLAUDE.md: 35 repos, 5 padrões. Lá eu classifico o que meus próprios repositórios acabaram fazendo sem plano. Spoiler: também não é bonito.
Eu continuo com a pasta ~/.openclaw/workspace-anthropic/ aberta em um buffer do editor. Os sete arquivos estão lá. A diferença é que eles pararam de ir todos juntos para o system prompt. Essa é a mudança inteira, e ela cabe em três regras do Ch09 que eu levei umas semanas para encarar.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev · TabNews
 Livro relacionado Transformando LLMs de Mentirosos em Especialistas Engenharia de Contexto na Prática | RAG · MCP · CLAUDE.md · Agentic RAG, com benchmarks de ponta a ponta Ver a página do livro →
Este artigo foi útil?