Mutation testing: 100 tests IA pasaron, caza 58%
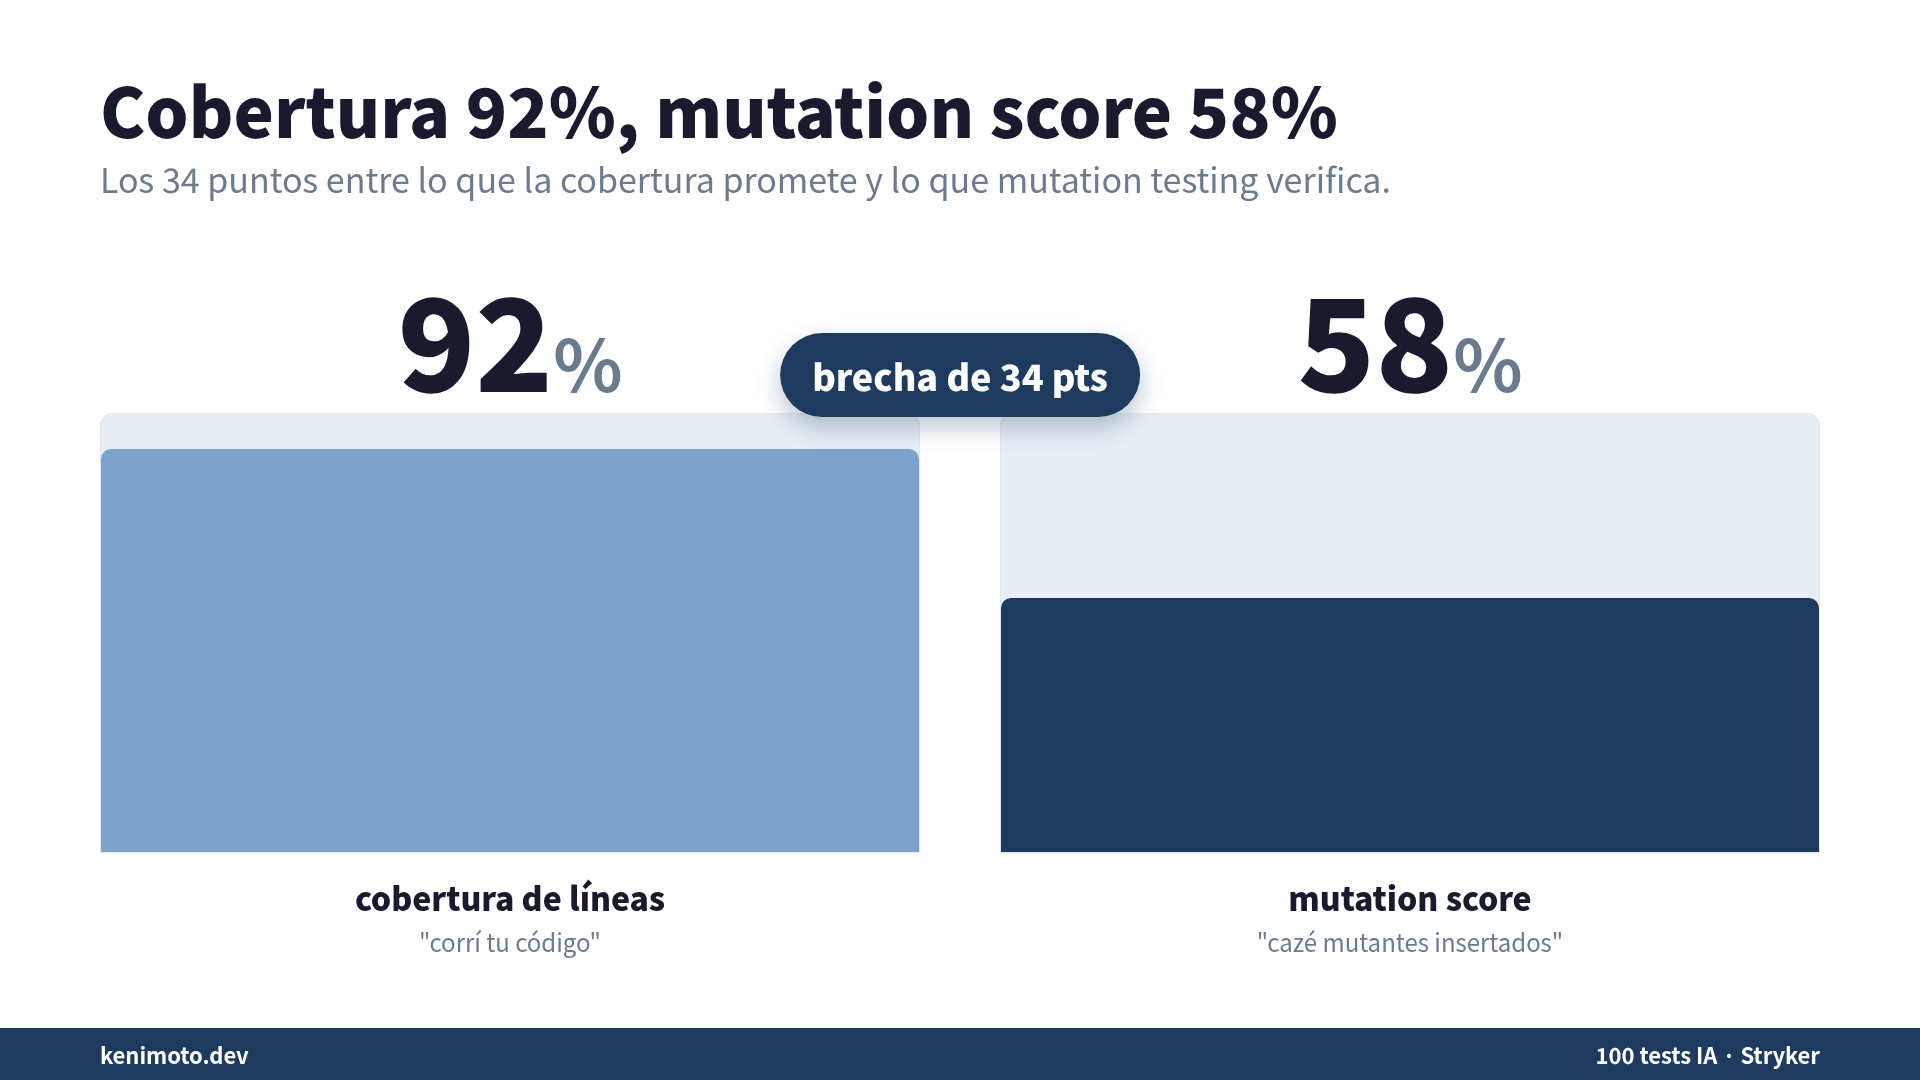
Durante varias semanas anduve diciéndole a todo el que me cruzaba que mi suite de tests era “a prueba de balas”. 100 tests, todos en verde, 92% de cobertura de líneas en el módulo que me importaba. Lo dije en voz alta, delante de personas reales, con cara seria. Después ejecuté mutation testing contra la misma suite y vi que el 42% de los bugs que inyecté a propósito se colaron sin que nadie se enterara. La suite detectó el 58%. “A prueba de balas” se me quedó corto; aquello se parecía más a una puerta de malla.
Y antes de que alguien me archive esto en el debate de siempre, aclaro que la cuestión no es cuándo se escriben los tests. Ese tema lo tengo visto. El problema que me pilló es otro y es peor, porque sobrevive al arreglo del orden. Puedes tener los tests escritos en el momento perfecto, todos pasando, cobertura decente, y aun así no estar verificando casi nada. Que esté en verde no significa que esté verificado.
Corregirse uno mismo el examen
The New Stack lo explicó de una forma que se me quedó clavada: pedirle a un LLM que escriba tests para el código que acaba de escribir es como dejar que el estudiante se corrija a sí mismo el examen. El modelo ya sabe qué hace la implementación. Los tests que produce tienden entonces a describir ese comportamiento en lugar de ponerlo en apuros. Afirman que el código hace lo que el código hace. Tautología con sello verde.
Aquí está el truco que se pasa por alto al mirar la cobertura. La cobertura de líneas responde “¿tocó un test esta línea?” y no dice nada sobre si el test se enteraría de que esa línea estuviera mal. Una aserción como expect(result).toBeDefined() ejecuta toda la función y cubre cada línea de dentro. Y pasa aunque la función devuelva el total correcto, uno equivocado o directamente el número 7. Cobertura excelente, verificación cero.
Cuando una IA escribe el código y los tests de una sentada, produce muchos de estos. El fallo es estructural: el modelo persigue “haz que esto pase”, y la forma más barata de hacer que una aserción pase es afirmar algo que ya es cierto.
Qué hace mutation testing en realidad
Mutation testing es la única herramienta que he encontrado que mide aquello que la cobertura finge medir. La idea es casi insultante de lo simple que es: rompes tu código a propósito y después miras si tus tests se dan cuenta.
Una herramienta como Stryker (para JS/TS; mutmut para Python, PIT para Java) toma tu fuente y genera cientos de pequeños mutantes. Invierte un > por >=, cambia + por -, sustituye un retorno booleano por true, elimina una llamada a función. Para cada mutante vuelve a ejecutar tu suite. Si un test falla, el mutante queda “killed”: tus tests pillaron el sabotaje. Si todos siguen pasando, el mutante “survived”: tienes un cambio en tu lógica contra el que ningún test del planeta protesta.
El mutation score es killed / total. En 2026 el listón de referencia para un módulo que te importe anda por el 80%. Mi suite generada por IA, con su exhibicionista cobertura del 92%, se quedó en 58.
Esos 34 puntos de brecha entre cobertura y mutation score lo resumen todo. La cobertura dijo “he pasado por tu código”. Mutation testing dijo “he roto tu código y tus tests aplaudieron igual”.
Hice las cuentas por ti (aunque deberías repetirlas)
El montaje fue aburrido a propósito para que el resultado no se pudiera descartar como casualidad. Un módulo TypeScript, unas 400 líneas con lógica de precios, cálculos de fechas y validación de entrada. Es el tipo de código que te revienta un viernes sin avisar cuando está mal. Le pedí al agente que implementara y escribiera una suite de tests exhaustiva en la misma sesión. Me dio 100 tests, todos pasando, 92% de cobertura de líneas. No toqué los tests.
Después npx stryker run. 214 mutantes. 124 killed, 90 survived. Score: 58%.
Me leí los 90 survivors uno a uno; lo recomiendo como experiencia humillante. Un cálculo de recargo donde invertir el operador de comparación no cambió la factura de nadie para la suite. Una rama de validación que rechazaba cantidades negativas, salvo que el test nunca le pasó valores inválidos, así que eliminar la validación entera no mató ningún mutante. Un off-by-one en un rango de fechas por el que tres tests “en verde” pasaron sin despeinarse. Ninguno habría salido en la cobertura. Eran bugs reales y la suite era estructuralmente ciega a todos.
Los 3 patrones que la IA repitió
De esos 90 saqué 3 patrones. Son los que la IA repitió una y otra vez.
Patrón 1: aserciones laxas
expect(result).toBeDefined(), expect(items.length).toBeGreaterThan(0), expect(callback).toHaveBeenCalled(). Las tres pasan sin verificar el valor concreto. La IA las usa porque aguantan cualquier refactor (siempre pasan), y por eso mismo quedan invisibles a los mutantes que cambian valores de retorno.
La solución: toda aserción tiene que comprobar un valor concreto. toBeDefined solo cuando lo que te interesa de verdad es que el campo no sea undefined, nunca como opción por defecto.
Patrón 2: solo el happy path
Los 100 tests cubrían el flujo “entrada válida → salida esperada”. Casi ninguno pisaba los bordes: cantidades negativas, cadenas vacías, fechas fuera de rango, usuarios sin permisos. Los mutantes que eliminaban validaciones sobrevivieron porque los tests nunca llegaban a activarlas.
La solución: para cada función, haz una lista explícita de inputs límite antes de pedirle al modelo que escriba los tests. Si tú no los defines, el modelo tampoco va a hacerlo.
Patrón 3: espejo de la implementación
La IA escribió tests que calcan la lógica interna del código. Si el código decide “si edad >= 18, descuento 0”, el test dice “si edad >= 18, descuento 0”. Si el código tiene un off-by-one, el test tiene exactamente el mismo off-by-one. Comprueba lo que el código hace. Lo que debería hacer queda sin verificar.
La solución: los tests salen de la especificación. Escríbelo partiendo de “qué debería hacer esta función” antes de que el modelo pise una sola línea de código. Si no tienes especificación, siéntate diez minutos y escríbela.
La solución es más vieja que el problema
Lo molesto es que TDD ya resolvió esto hace años, y yo lo había abandonado a medias porque la IA hace que escribir tests parezca opcional.
Lo estructural de TDD no es la ceremonia ni el baile red-green-refactor. Lo estructural es dónde queda el quality gate. Cuando una persona escribe el test primero, desde la especificación, antes de que exista la implementación, el test codifica una intención que la implementación todavía no puede complacer. El modelo escribe código para satisfacer un objetivo que no pudo definir. El gate se queda del lado humano. Ahí está todo el valor, y es exactamente lo que regalas cuando dejas que el mismo agente escriba código y tests juntos: el gate migra sin ruido al modelo, que vuelve a estar corrigiéndose a sí mismo el examen.
Así que cambié cómo reparto el trabajo. Escribo el test (o al menos las aserciones y los casos límite) antes de que el agente implemente nada. Números negativos, entradas vacías, el borde que siempre acaba off-by-one. La IA es muy buena implementando y rellenando el andamiaje mecánico de tests alrededor de aserciones que yo ya he definido. Lo que dejé de delegar es la parte de definir. Y una vez por trimestre, en cualquier cosa que me daría vergüenza mandar rota a producción, ejecuto mutation testing. No es un ritual diario sino una comprobación de realidad periódica para ver si mi verde es verde de verdad.
Mi suite está ahora en el 84%. Sigue sin ser a prueba de balas, pero he quitado la puerta de malla y he dejado de decir “a prueba de balas” delante de personas. Progreso raro, pero progreso.
Si te preguntas por dónde empezar, ejecuta mutation testing una vez sobre el módulo del que estés más orgulloso. En el peor de los casos tenías razón. En el mejor, te enteras tú antes que producción.
Lectura relacionada: Los 7 archivos que Claude Code lee antes de escribir código para configurar el contexto que la IA recibe antes de generar tus tests.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev
 Libro relacionado Practical Claude Code Claude Code desde cero hasta producción — CLAUDE.md, Plan Mode y workflows de equipo, desde un año de uso real Ver la página del libro →
¿Te resultó útil este artículo?