Voice AI: 7 trucos para sentir 350ms con 750ms
El reto con la latencia de un agente de voz es que, con STT, LLM y TTS encadenados, bajar de 500ms deja de ser un asunto de software y pasa a ser físico. En algún punto los modelos pequeños ya no caben, el GPU ya no da más, y uno se queda con un número físico que no se mueve.
La percepción sí se mueve. En el capítulo 8 de mi libro Voice AI 300ms UX, dos personajes de la historia llegan a 350ms percibidos con 750ms físicos. El dato salió aplicando siete trucos a un prototipo; no fue un experimento con muestra controlada, así que no garantiza esa misma reducción en otros montajes. Sirve para mostrar cuál de los siete trucos realmente baja el tiempo hasta el primer sonido, y cuáles sólo cambian cómo se siente la espera.
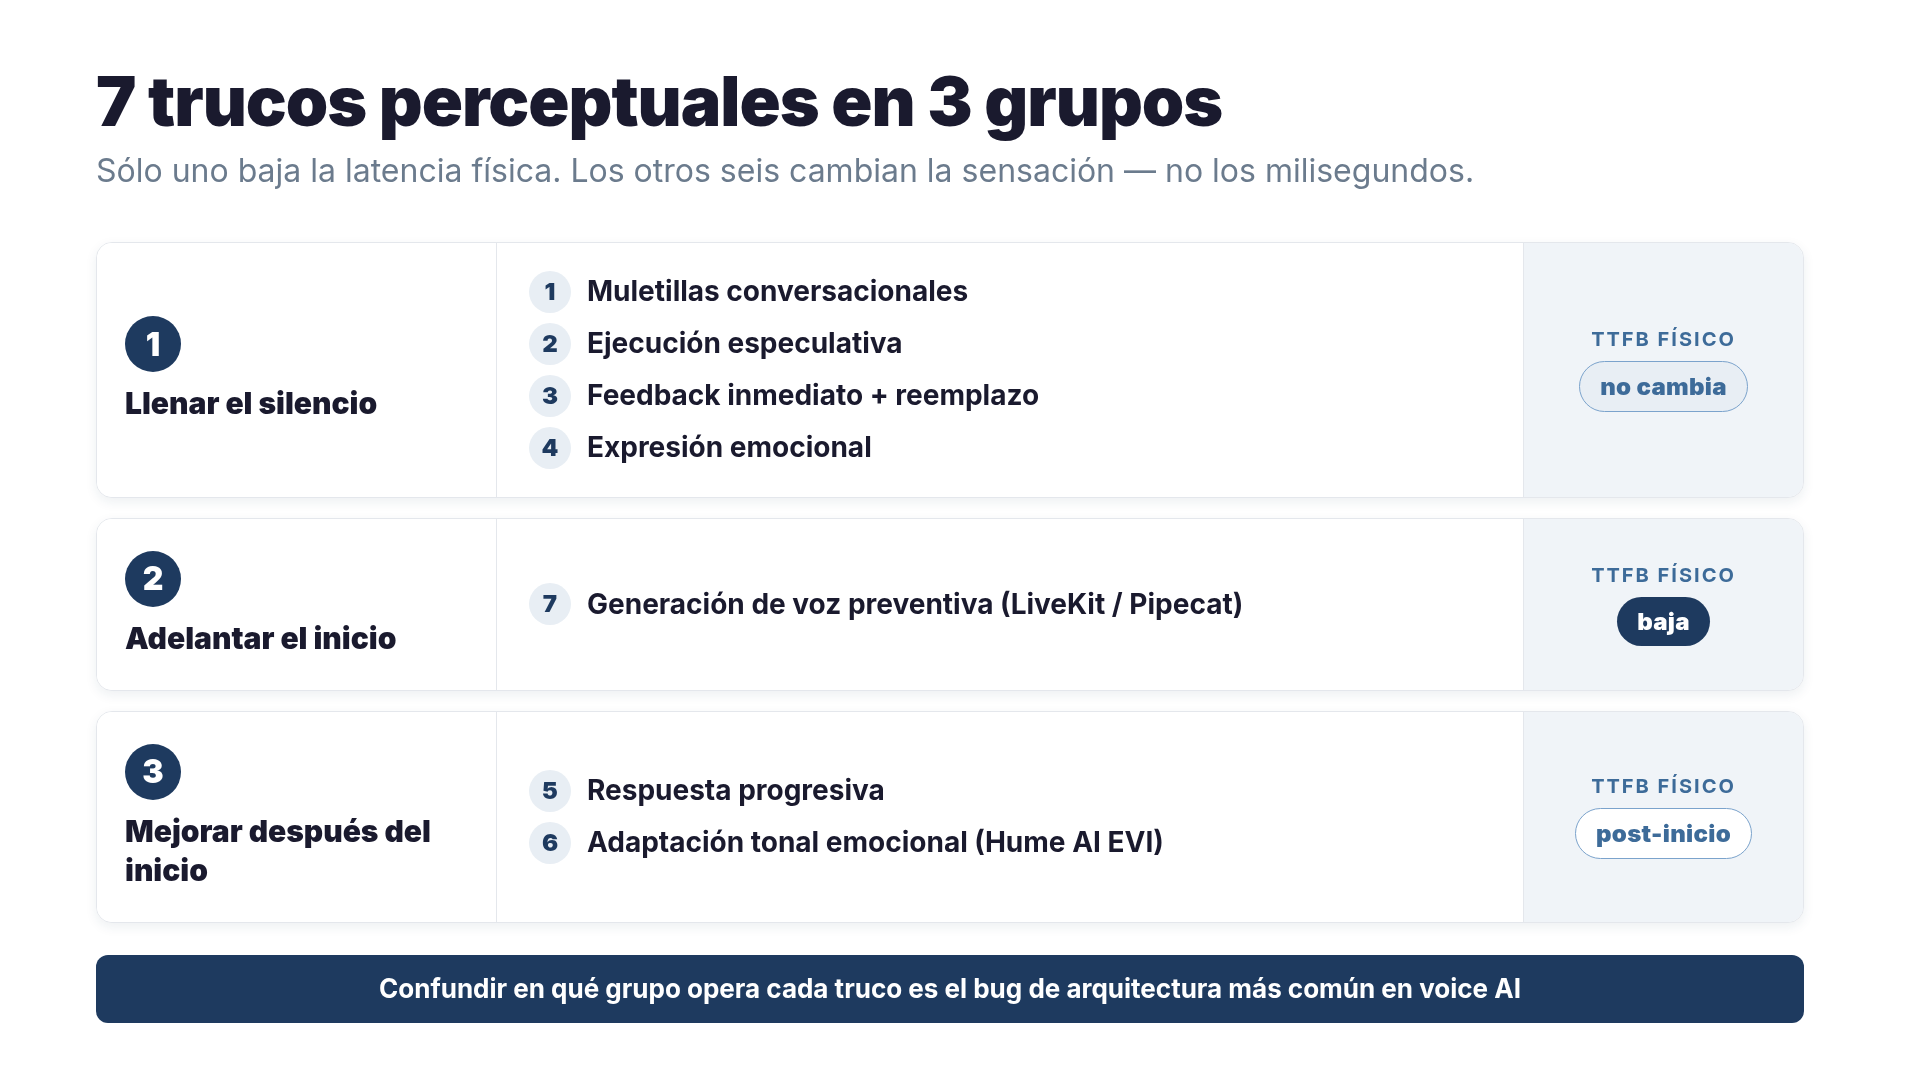
Separar “bajar los milisegundos” de “cambiar la sensación”
De los siete trucos, sólo uno mueve la latencia física (el tiempo hasta que sale el primer sonido). Los otros seis no bajan ni un milisegundo real.
- Baja el tiempo físico: generación de voz preventiva (7)
- Llena el silencio: muletillas conversacionales (1), ejecución especulativa (2), feedback inmediato (3), expresión emocional (4)
- Mejora la experiencia después del inicio: respuesta progresiva (5), adaptación tonal emocional (6)
Mezclar los tres grupos como “siete técnicas para acelerar la voz” es el error más común. Lleva a priorizar un truco que mejora la conversación después de que el agente ya empezó a hablar, cuando el problema del usuario es el silencio antes de que empiece. Son dos problemas distintos, y la mitad del tiempo el revisor del diseño no los distingue.
Grupo 1: llenar el silencio (4 trucos)
1. Muletillas conversacionales
“Déjame ver”, “un segundo”, “voy a revisar eso”. El agente dice algo mientras procesa.
El silencio es lo que la gente lee como “este sistema está roto”. Reemplazarlo con una muletilla no reduce el tiempo real que el usuario espera, pero convierte “estoy esperando” en “me están atendiendo”. Dos cosas muy distintas en el cuerpo.
El trabajo de Maslych y colegas en ACM CUI 2025 midió esto en VR, con delays de 1.5, 4.0 y 6.5 segundos frente a agentes LLM. Las muletillas naturales mejoraron la sensación de rapidez con significancia estadística en las condiciones de 4.0s y 6.5s, pero no en la de 1.5s. En milisegundos (que es donde operan los agentes de voz actuales) no hay confirmación directa: el experimento se hizo a escalas de segundos.
2. Ejecución especulativa
GetStream describe un patrón llamado speculative tool calling. Mientras el agente reproduce una muletilla, el backend ya está lanzando la llamada a herramientas en segundo plano.
El truco funciona sólo con herramientas de lectura. Consultar el clima, el saldo, la agenda: si la predicción falla, se descarta el resultado y nadie se entera. En cambio, hacer transferencias, enviar mensajes o borrar archivos de forma especulativa es un desastre: una predicción errada deja un efecto que no se puede deshacer.
Las piezas que hay que decidir antes de implementar:
- Descarte: resultados fallidos no se añaden al historial de conversación
- Aislamiento: la ejecución especulativa no se le pasa al LLM hasta que el input del usuario esté confirmado
- Techo de costo: APIs pagadas por llamada quedan fuera del especulativo o con un límite estricto
3. Feedback inmediato + reemplazo
En aplicaciones de dictado, el patrón ya es estándar: mostrar la salida cruda del STT en texto gris mientras el LLM lo pule, y después reemplazar el texto gris por el formateado.
Mi libro lo trata como propuesta de diseño sin métrica directa. No he encontrado un estudio que aísle el efecto. En código de producción, el patrón elimina la pregunta “¿me escuchó?” durante los primeros 300-500ms, que es la pregunta más corrosiva en una conversación con máquina.
4. Expresión emocional
Jolibois, Ito y Nose publicaron en Applied Sciences 2025 un estudio con un agente conversacional con cara (ECA) haciendo de guía de museo. Compararon un agente sin expresión facial contra uno con expresiones que cambiaban según el estado emocional del contenido.
El resultado: el agente sin expresión perdía puntos de “rapidez percibida” cuando el delay crecía. El agente con expresión mantenía la percepción de rapidez incluso con el mismo delay físico. Los participantes fueron 25 estudiantes internacionales en la Universidad de Tohoku, con el experimento en inglés.
Esto aplica a agentes con cara visible. Si tu agente es sólo audio, el truco no se traslada tal cual: habría que buscar un equivalente auditivo, por ejemplo respiraciones o cambios tonales.
Grupo 2: adelantar el inicio (1 truco)
7. Generación de voz preventiva
Este es el único truco que mueve la latencia física.
El flujo tradicional es STT → VAD confirma fin de turno → LLM → TTS → audio. La generación preventiva arranca el LLM antes de que el VAD confirme que el usuario terminó de hablar, usando el resultado del STT en vivo. Si el usuario sigue hablando, se descarta la inferencia. Si el VAD acierta la predicción, cuando confirma el fin de turno el LLM ya tiene una respuesta parcial y se gana ese tiempo de espera.
LiveKit Agents implementa esto como preemptive_generation. Por defecto adelanta sólo el LLM; existe también la opción preemptive_tts que adelanta el TTS pero gasta más cómputo cuando el usuario sigue hablando. Pipecat tenía abierto en diciembre de 2025 el issue #3321 pidiendo esta funcionalidad.
El ahorro depende del tiempo entre “el STT ya tiene el input” y “el VAD confirma fin de turno”. En ese montaje suele ser 100-300ms, pero no hay un número fijo. La contraparte es que cada predicción fallida gasta cómputo (y si TTS también va preventivo, costos de API), y el manejo del historial de conversación se complica porque hay que admitir rollback.
Grupo 3: mejorar la experiencia después del inicio (2 trucos)
Este grupo no cambia el tiempo hasta el primer sonido. Si tu problema es que el usuario escucha silencio por 800ms, estos trucos no ayudan: hay que mirar los grupos anteriores.
5. Respuesta progresiva
En lugar de “aquí tienes tres puntos sobre X”, responder con “voy a darte tres puntos sobre X. El primero es…” permite que el usuario entienda la estructura mientras llega el contenido. El inicio sucede en el mismo tiempo físico que antes, pero el oyente no espera la frase completa para empezar a procesarla.
Es una propuesta de diseño del libro. No hay un estudio al que apuntar que mida este patrón específicamente en voz.
6. Adaptación tonal emocional (enfoque Hume AI EVI)
Hume AI publica una API llamada Empathic Voice Interface que recibe prosodia (tono, ritmo, energía) como entrada. En la documentación oficial están confirmados dos usos: usar la prosodia del usuario para detectar fin de turno, y modular el tono de la respuesta según el estado emocional detectado (Hume da el ejemplo “con irritación → tono de disculpa; con tristeza → tono empático”).
Mi libro propone extender ese uso también a la longitud de la respuesta, no sólo al tono. Un usuario que suena apurado recibe respuestas más cortas, directas al grano. Un usuario relajado recibe más contexto. Es la lógica de un buen bartender: lee al cliente antes de servir.
Riesgos que hay que diseñar explícitamente:
- Consentimiento: avisar al usuario que se analiza su prosodia, con opción de desactivar
- Reversibilidad: la activación/desactivación del truco debe estar en settings o en una frase hablada
- Alcance acotado: usar la emoción detectada sólo para longitud y tono, no para decisiones sobre el servicio
El acento, el idioma nativo del usuario, el estado de salud y el estilo personal distorsionan las lecturas de prosodia. Si la detección se usa para servir diferente a diferentes usuarios, los errores de detección se transforman en errores de servicio sesgados. Hay que mantener el truco en el perímetro del tono y la longitud.
Ni la suma de los siete baja a cero
El error de aritmética que veo más seguido: sumar los efectos de los siete trucos y predecir “400ms de reducción”. Es una mala apuesta.
- Los cuatro trucos del grupo 1 compiten por el mismo tiempo. Mientras suena una muletilla de 1 segundo, caben ejecución especulativa, feedback inmediato y expresión emocional al mismo tiempo. El reloj del usuario sólo avanza una vez.
- La generación preventiva es la única que mueve físicamente los milisegundos, pero sólo gana si la predicción acierta. Si falla seguido, el costo de cómputo acumulado no se traduce en ahorro de latencia.
- Los dos trucos del grupo 3 no tocan el tiempo hasta el primer sonido. Son útiles para distintos puntos de la conversación.
La prioridad depende de dónde está la latencia de tu montaje. Si el VAD se tarda en confirmar fin de turno, prioriza el 7. Si la inferencia del LLM es lo largo, prioriza llenar el silencio durante esa inferencia con 1-4. Si la respuesta ya empieza rápido pero el usuario se cansa a mitad de camino, los trucos 5 y 6 son la pelea.
Para el caso de barge-in (interrumpir mientras el agente habla), tengo un artículo separado: Barge-in de voz: 22% menos precisión, 4 umbrales. Y para el bloque de turn-taking que Krisp ha empujado en los últimos seis meses, Krisp 6M, VAD y turn-taking.
Cierre
El flujo físico tiene un piso. La percepción del usuario, no tanto. Siete trucos reparten el espacio entre llenar el silencio, adelantar el inicio y mejorar lo que viene después. Confundir en qué grupo opera cada uno es el bug de arquitectura más común en voice AI del lado del producto.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev
¿Te resultó útil este artículo?