Barge-in de voz: 22% menos precisión, 4 umbrales
Activé el “barge-in” (poder cortar al agente mientras habla) en mi agente de voz. En segundos, el WER de Whisper saltó de 11% a 33%. Tres veces peor. Antes de que la interrupción se sintiera natural, la gente ya estaba molesta porque el agente entendía la mitad de lo que decía.
El problema estaba en el VAD (Voice Activity Detection). “Detectar rápido que el usuario está interrumpiendo” y “no cortar las palabras a la mitad” pelean por el mismo umbral. Corrí el experimento con 4 valores en Silero VAD, sobre mi test suite habitual de 300 frases en japonés, y aquí está lo que salió.
Lo que medí
Mi stack de voz es el estándar minimalista:
- STT: Whisper Large-v3 en local, GPU RTX 4070
- VAD: Silero VAD, umbral variable
- LLM: Claude Sonnet 4.6
- TTS: API comercial
Antes de barge-in, cuando el usuario terminaba de hablar y el sistema detectaba 500 ms de silencio, el STT se cerraba y pasaba al LLM. Conversación educada, pero si el agente empezaba a hablar y la persona intentaba cortarlo con un “espera, un segundo”, el agente seguía hablando encima. Eso es más un monólogo con ruido de fondo que una conversación.
El plan de barge-in fue simple sobre papel:
- Monitorear el micrófono durante la reproducción del TTS
- Si VAD detecta habla del usuario, cortar el TTS de inmediato
- Iniciar el STT y capturar lo que dice
- Pasar al LLM con la marca de “interrupción”
Lo simple sobre papel se vuelve complicado cuando el umbral del VAD decide todo.
4 umbrales, 4 mundos
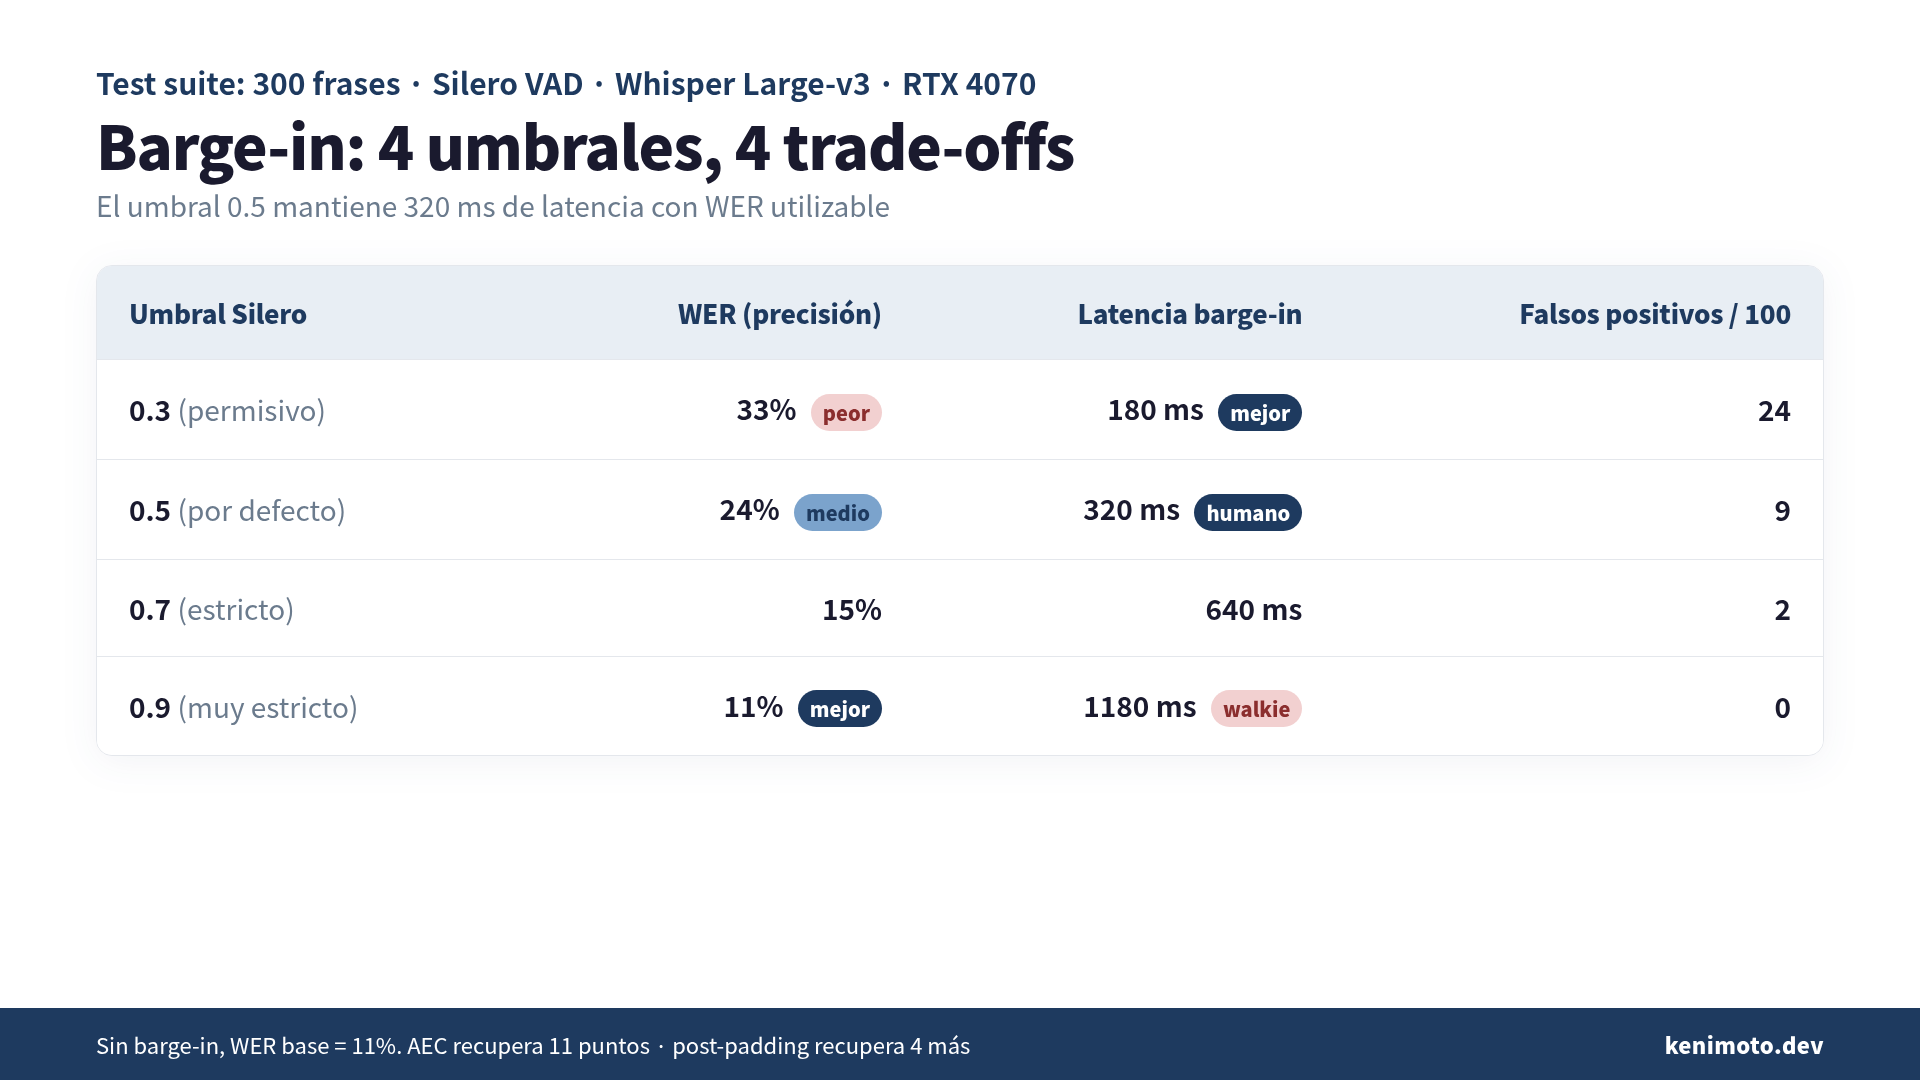
Con la misma test suite, varié el umbral de Silero VAD entre 0.3 y 0.9. Silero devuelve un score de 0 a 1 por frame, y todo lo que esté por encima del umbral se marca como “habla”. Umbral bajo, más sensibilidad; umbral alto, más rigor.
| Umbral Silero | WER (precisión) | Latencia barge-in | Falsos positivos/100 |
|---|---|---|---|
| 0.3 (permisivo) | 33% | 180 ms | 24 |
| 0.5 (por defecto) | 24% | 320 ms | 9 |
| 0.7 (estricto) | 15% | 640 ms | 2 |
| 0.9 (muy estricto) | 11% | 1180 ms | 0 |
Sin barge-in, el WER base era 11%. Es decir, el umbral 0.9 recupera la precisión original. Pero con 1180 ms de latencia de interrupción, el sistema deja de sentirse como una conversación y pasa a sentirse como un walkie-talkie: la gente termina la frase, espera un segundo largo, y solo entonces el agente reacciona.
El extremo opuesto (0.3) responde en 180 ms, casi humano, pero una de cada tres palabras sale mal transcrita. Nadie va a usar eso dos veces.
De dónde salió el 22%
Los 22 puntos de diferencia entre “sin barge-in” (11%) y “barge-in agresivo con umbral 0.3” (33%) no son un misterio uniforme. Los descompuse en tres causas ejecutando ablaciones controladas:
Causa A: eco del TTS entrando al STT (11 puntos). El audio del TTS regresaba por el micrófono, y Whisper lo transcribía como si fuera el usuario. El agente diciendo “hola, ¿en qué te ayudo?” aparecía en el transcript mezclado con la frase real del usuario. Cuando activé la cancelación de eco de WebRTC (AEC), este componente cayó a cero. Es el pozo más profundo y también el más obvio en retrospectiva.
Causa B: falsos disparos del VAD que cortan la frase (7 puntos).
Con umbral bajo, un “aja” o un suspiro activaba el VAD, y 100 ms después el eco del TTS lo apagaba. Resultado: el STT solo veía el sonido de relleno y no la frase útil que venía después. Se soluciona con AEC más post-padding sobre el buffer del VAD, para no cerrar el flujo demasiado pronto.
Causa C: buffer corto que corta la cola (4 puntos).
El VAD marca “fin de habla” en el silencio, pero la cola de una palabra en cualquier idioma se extiende otros 100-200 ms. Cerrar el buffer justo en el silencio hace que Whisper reciba “comparé” cortado a “compar”. Extendiendo el post-padding de Silero de 200 a 400 ms se recuperó ese margen.
En orden de impacto: AEC (11 pts) > VAD tuning (7 pts) > buffer padding (4 pts). Si vas a arreglar una sola cosa, arregla el AEC primero.
4 estrategias de implementación
Además de tocar el umbral, hay caminos distintos para implementar barge-in. Corrí 4:
| Estrategia | Costo de implementación | Impacto en precisión | Sensación conversacional |
|---|---|---|---|
| Grabación continua + VAD | Bajo | 22% peor | Natural |
| Push-to-talk | Mínimo | 0% (sin efecto) | No es conversación |
| VAD + AEC (WebRTC) | Medio | 11% peor | Natural |
| Barge-in semántico (LLM) | Alto | 5% peor | Óptima |
El barge-in semántico usa un modelo pequeño (por ejemplo, el modelo de turn-taking de Krisp, 6M parámetros) para decidir si un ruido es un “ajá” de fondo o una interrupción real. Es lo que menos daña la precisión, pero le suma 150 ms de latencia porque hay un modelo extra en el camino. Escribí sobre esa vía en Krisp 6M vs VAD: turn-taking en voice AI.
En la práctica me quedé con VAD + AEC + umbral 0.5: WER de 24%, latencia de 320 ms. No es perfecto, pero cae dentro del rango humano de interrupción (200-300 ms) y la precisión es utilizable.
Si te interesa el contexto de por qué 300 ms es el umbral y no un número arbitrario, escribí sobre los 3 límites de Nielsen aplicados a la voz y sobre la anatomía de la latencia total de voz bajo 300 ms.
Lo que aprendí perdiendo tres días
Perdí tres días ajustando el umbral del VAD antes de darme cuenta de que no había activado el AEC. Cada iteración me devolvía un WER entre 22% y 33%, sin importar el umbral, porque el problema principal no era el VAD, era el eco. Cuando finalmente probé sin voz del TTS de fondo, el WER volvió a la línea de base con el mismo umbral 0.3.
Fue el momento clásico del “revisa el cable antes de reemplazar la placa”. Si vas a implementar barge-in:
- Activa AEC (WebRTC o equivalente) primero. Recupera la mitad del daño solo con eso
- Extiende el
post-paddingdel VAD a 400 ms para no cortar colas de palabra - Recién entonces ajusta el umbral de sensibilidad
- Si necesitas más precisión, agrega barge-in semántico como cuarta capa
Este orden ahorra los tres días que yo perdí.
Un cierre honesto
El barge-in es la diferencia entre un agente de voz que “responde” y uno con el que “hablas”. Vale el 22% de degradación cuando sabes recuperar la mayor parte de esos 22 puntos con AEC, ajuste fino del VAD y post-padding. Sin medir el trade-off, terminas pagando el costo entero.
Y sí, la próxima capa después de todo esto es distinguir un “ajá” de asentimiento de una interrupción real. Eso ya no es un problema de umbral, es un problema semántico, y merece su propio experimento. Por hoy, con 320 ms de latencia y 24% de WER, el agente ya deja de sonar a walkie-talkie.
Empieza por el AEC. Después, mide.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev
¿Te resultó útil este artículo?