Tu codebase ya era un harness. 5 señales.
Un colega me escribió hace poco: “¿Y dónde instalo el harness para mi Claude Code?”. Me pasó el repo, lo abrí, y en la raíz me miraron un tsconfig.json con "strict": true, un next.config.js con las convenciones del App Router, un .eslintrc, un directorio tests/ con Jest, y un pre-commit hook que ya rechazaba cambios que rompían el build. Le respondí lo único honesto que se me ocurrió: no tienes que instalarlo. Ya llevas años usándolo. Solo que no lo llamabas así.
Esa conversación me dejó con una pregunta incómoda: ¿cuántos de los AGENTS.md que la gente está escribiendo esta semana están duplicando reglas que el compilador ya aplica? Y del otro lado: ¿cuántos codebases están cojeando con Claude Code porque nunca invirtieron en la parte que sí es harness (tipos, tests, límites de módulo), y ahora esperan que un prompt de 300 líneas cubra el hueco?
Qué dice el artículo que todos citan mal
El texto de referencia sobre esto es “Harness engineering for coding agent users”, publicado el 2 de abril de 2026. Detalle no menor, porque yo mismo lo tenía mal en el primer draft de este artículo: la firma es de Birgitta Böckeler, Distinguished Engineer en Thoughtworks. Martin Fowler no es co-autor. El artículo vive en martinfowler.com porque ese dominio funciona como revista invitada para autores del entorno Thoughtworks, no porque Fowler haya escrito la pieza.
Lo aclaro porque en LatAm es fácil resumir el artículo como “lo escribió Fowler” y sonar autorizado. No lo escribió. Y la propia Böckeler tampoco lo presenta como una continuación directa de los libros clásicos de refactoring o CI. Ella retoma la fórmula que popularizó LangChain (Agent = Model + Harness) y se enfoca en cómo se ve el harness desde el asiento del ingeniero que ya tiene un codebase real.
La frase que me marcó al releerla:
“A codebase written in a strongly typed language naturally has type-checking as a sensor; clearly definable module boundaries afford architectural constraint rules; frameworks like Spring abstract away details the agent doesn’t even have to worry about and therefore implicitly increase the agent’s chances of success.”
Traducido: tu codebase ya trae sensores puestos de fábrica. No los pusiste para el agente. Los pusiste porque en 2019 querías dormir sin que producción se rompiera. Ahora resulta que el agente los aprovecha.
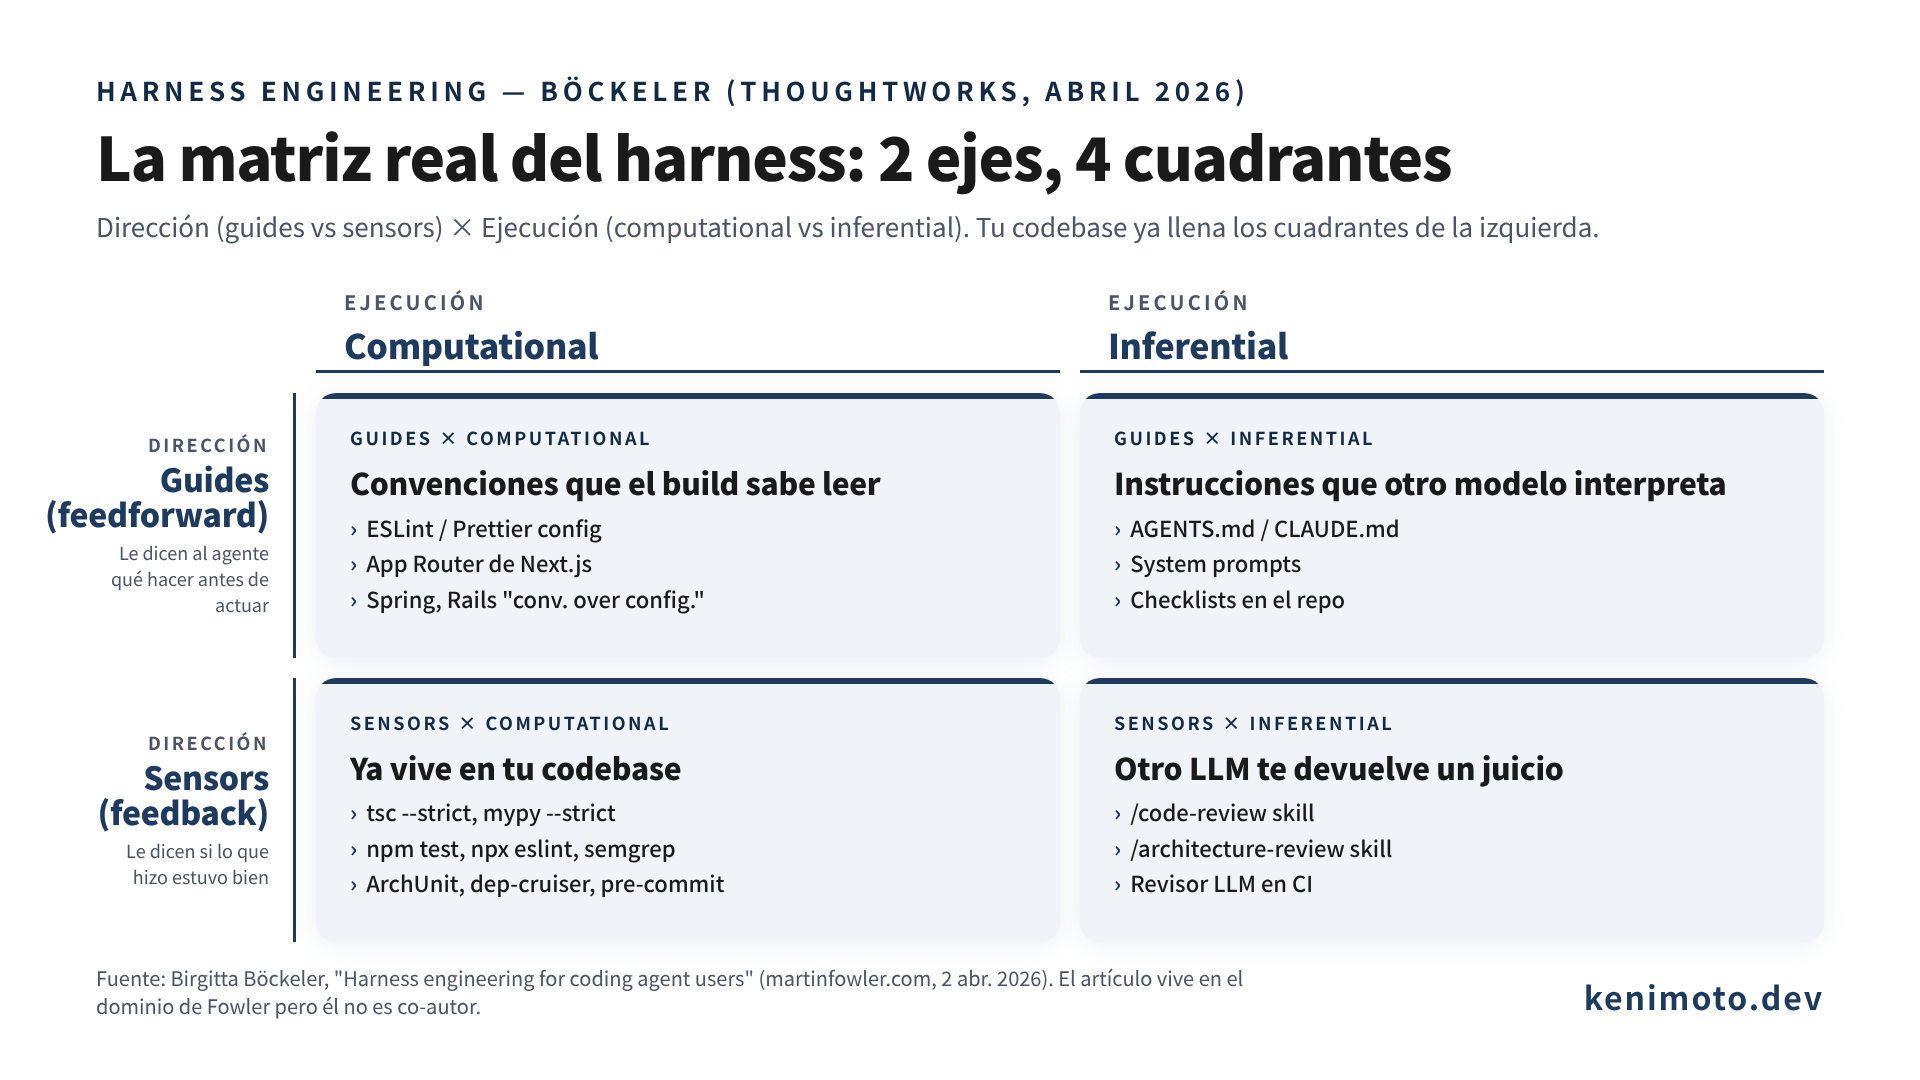
La taxonomía real (no es “4 sensores”)
Antes de escribir este artículo tenía un modelo mental incorrecto del texto de Böckeler. Pensaba que proponía cuatro categorías planas de sensores, y armé una figura sobre eso. Cuando volví al original a verificar antes de publicar, descubrí que el modelo es otro y mucho más limpio: dos ejes, cuatro cuadrantes.
- Eje de dirección:
guides(controles feedforward: le dicen al agente qué hacer antes de que actúe) vssensors(controles feedback: le dicen si lo que hizo estuvo bien). - Eje de ejecución:
computational(lo aplica una herramienta determinista: tests, linter, compilador) vsinferential(lo evalúa otro modelo, tipo/code-review skillo un revisor LLM secundario).
Böckeler encima cruza esto con una tercera dimensión (qué regula el control: mantenibilidad, aptitud arquitectónica, comportamiento), pero para el ejercicio que quiero hacer contigo hoy, los dos primeros ejes alcanzan.
Ejemplos concretos por cuadrante, mezclando las herramientas que la propia autora menciona (Spring, ESLint, semgrep, ArchUnit, dep-cruiser, pre-commit hooks) con equivalentes contemporáneos del stack JS/Python:
| Computational | Inferential | |
|---|---|---|
| Guides (feedforward) | ESLint config, convenciones de framework (App Router, Spring), plantillas de scaffolding | AGENTS.md / CLAUDE.md, system prompts, checklists en el repo |
| Sensors (feedback) | tsc --strict, npm test, npx eslint, semgrep, mutation testing, ArchUnit, dep-cruiser, pre-commit hooks | /code-review skill, /architecture-review skill, revisor LLM en CI |
La celda de la izquierda-abajo (sensors × computational) es donde tu codebase probablemente ya tiene tela. El trabajo pesado ahí no es escribir prompts; es activar strict, subir cobertura y dejar que el compilador te devuelva señal.
Las 5 señales
La lista con la que estoy auditando mis propios repos esta semana. Contesta sí o no, sin trampa:
- ¿Tipado estricto? — TypeScript con
strict: true, Python conmypy --strict, Rust por diseño. Si tu proyecto es JavaScript puro o Python sin tipos, cada instrucción de “no usesany” que le pongas al agente en AGENTS.md es una regla que el compilador debería estar aplicando por ti, gratis, mil veces por día. - ¿Fronteras de módulos verificables? —
dep-cruiser, ArchUnit, o simplemente una estructura de carpetas que rompe el build si un módulo importa cosas que no debería. Sin esto, “respeta la arquitectura” en el prompt es una promesa vacía. - ¿Suite de tests que se ejecuta en menos de 5 minutos? — El sensor más ruidoso que existe. Si tarda 40 minutos, el agente no la va a usar como feedback loop, y tú tampoco.
- ¿Linter + formatter en pre-commit hook? — La celda
guides × computationalno negociable. Si el agente puede hacer commit de código que ni siquiera pasaprettier, el resto de la conversación es teatro. - ¿Convenciones de framework fuertes? — Next.js App Router, Rails “convention over configuration”, Django apps. Estas te ahorran escribir la mitad del AGENTS.md, porque la estructura misma del proyecto ya le dice al agente dónde va cada cosa.
Si contestaste sí a las 5, tu codebase ya trae el 70% del harness montado y tu AGENTS.md puede ser corto y honesto. Si contestaste no a 3 o más, guarda esta idea: un AGENTS.md más largo no compensa el hueco tanto como strict mode y una CI que muerda.
El microservicio Python 2.7 que me humilló
Antes de que suene todo esto muy limpio: yo empecé auditando un microservicio mío de 2019, en Python 2.7, sin tests, con un requirements.txt que ya no resuelve. Las 5 respuestas fueron no, no, no, no, no. Le pedí a Claude Code que refactorizara un endpoint y produjo código que parecía razonable y estaba silenciosamente roto en tres lugares. No tenía cómo saberlo sin ejecutarlo, y no había nada que lo ejecutara. Ni un test, ni un tipo, ni un linter que estuviera de acuerdo con el intérprete instalado. El agente hizo su trabajo. El harness era el que faltaba.
La lección que saqué es que la fórmula Agent = Model + Harness incluye una parte que la comunidad suele saltearse: el codebase mismo cuenta como harness. Si tu repo es un desastre estructural, ningún prompt te va a rescatar. Es una lección incómoda porque no se resuelve con un fin de semana escribiendo un AGENTS.md, sino con meses de tipos, tests y refactor. Pero es la única lectura del artículo de Böckeler que se sostiene si uno lo lee entero.
Antes de instalar nada, mira lo que ya tienes
Si estás por empezar con Claude Code o Codex CLI en un repo que ya existe, mi recomendación práctica: antes de escribir el primer AGENTS.md, pasa las 5 preguntas de arriba y anota los no. Cada no es un boquete en tu harness computacional. Taparlos (activar strict, agregar tests de humo, poner el linter en pre-commit) te va a rendir más que cualquier prompt engineering que hagas después.
En el artículo Codex CLI vs Claude Code: 7 tareas reales en el mismo repo hice un experimento paralelo con dos agentes distintos sobre el mismo monorepo. Ese texto se enfoca en el reparto por tipo de tarea; la observación que se me quedó pegada al terminarlo — y que me llevó a este artículo — fue otra: en un repo con harness fuerte los dos agentes se parecen más, y en uno flojo se ven las costuras de cada modelo. Böckeler lo dice de otro modo en su artículo, pero es la misma cosa: cuanto más harness pone el codebase, menos importa qué modelo eliges. Y esa es una buena noticia para 2026, cuando el próximo modelo va a salir igual, lo elijas o no.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev
 Libro relacionado Harness Engineering Harness Engineering desde cero — cinco interpretaciones (OpenAI, Anthropic, LangChain, Martin Fowler, academia) unificadas en un solo sistema para ingenieros en producción Ver la página del libro →
¿Te resultó útil este artículo?