Delegación en Claude Code: 4 niveles sabotan
“Déjalo todo en manos de la IA que es más rápido.” Esa frase me la cruzo en LinkedIn casi todas las semanas. La intenté tomar en serio y acabé con una tarde entera devolviendo una decisión de arquitectura que yo nunca pedí.
Claude Code aceptó mi “refactoriza esto” y decidió, solo, cambiar la capa de acceso a la base de datos completa. Técnicamente el código compilaba. Pero no era lo que yo quería, y revisar la diferencia terminó costándome más que si hubiera escrito la refactorización a mano. Velocidad negativa. El refactor estrella del día lo hizo la IA, lo deshice yo.
A partir de ahí dejé de pensar la delegación como un interruptor (o la hago yo, o la hace la IA) y empecé a tratarla como una perilla de volumen con cuatro marcas. Quien no decide en qué marca entra cada tarea termina con un agente que estorba en vez de ayudar.
El error de tratar la delegación como on/off
Mi equivocación era binaria. O retenía todo, o soltaba todo. Los dos extremos salen caros: retener todo tira a la basura el beneficio del agente, soltar todo genera trabajo de revisión que no estaba presupuestado.
La propia Anthropic llegó a esa conclusión. En marzo de 2026 lanzó el auto mode de Claude Code, un intermedio entre aprobar cada paso a mano y el YOLO mode sin frenos. Un clasificador aparte revisa cada acción antes de ejecutarla y bloquea lo que se sale de lo que pediste. Es decir: el fabricante dejó de verlo como interruptor antes que yo.
A mí me faltaba un vocabulario para decidir, por tarea, cuánto soltar. Lo resolví con cuatro niveles.
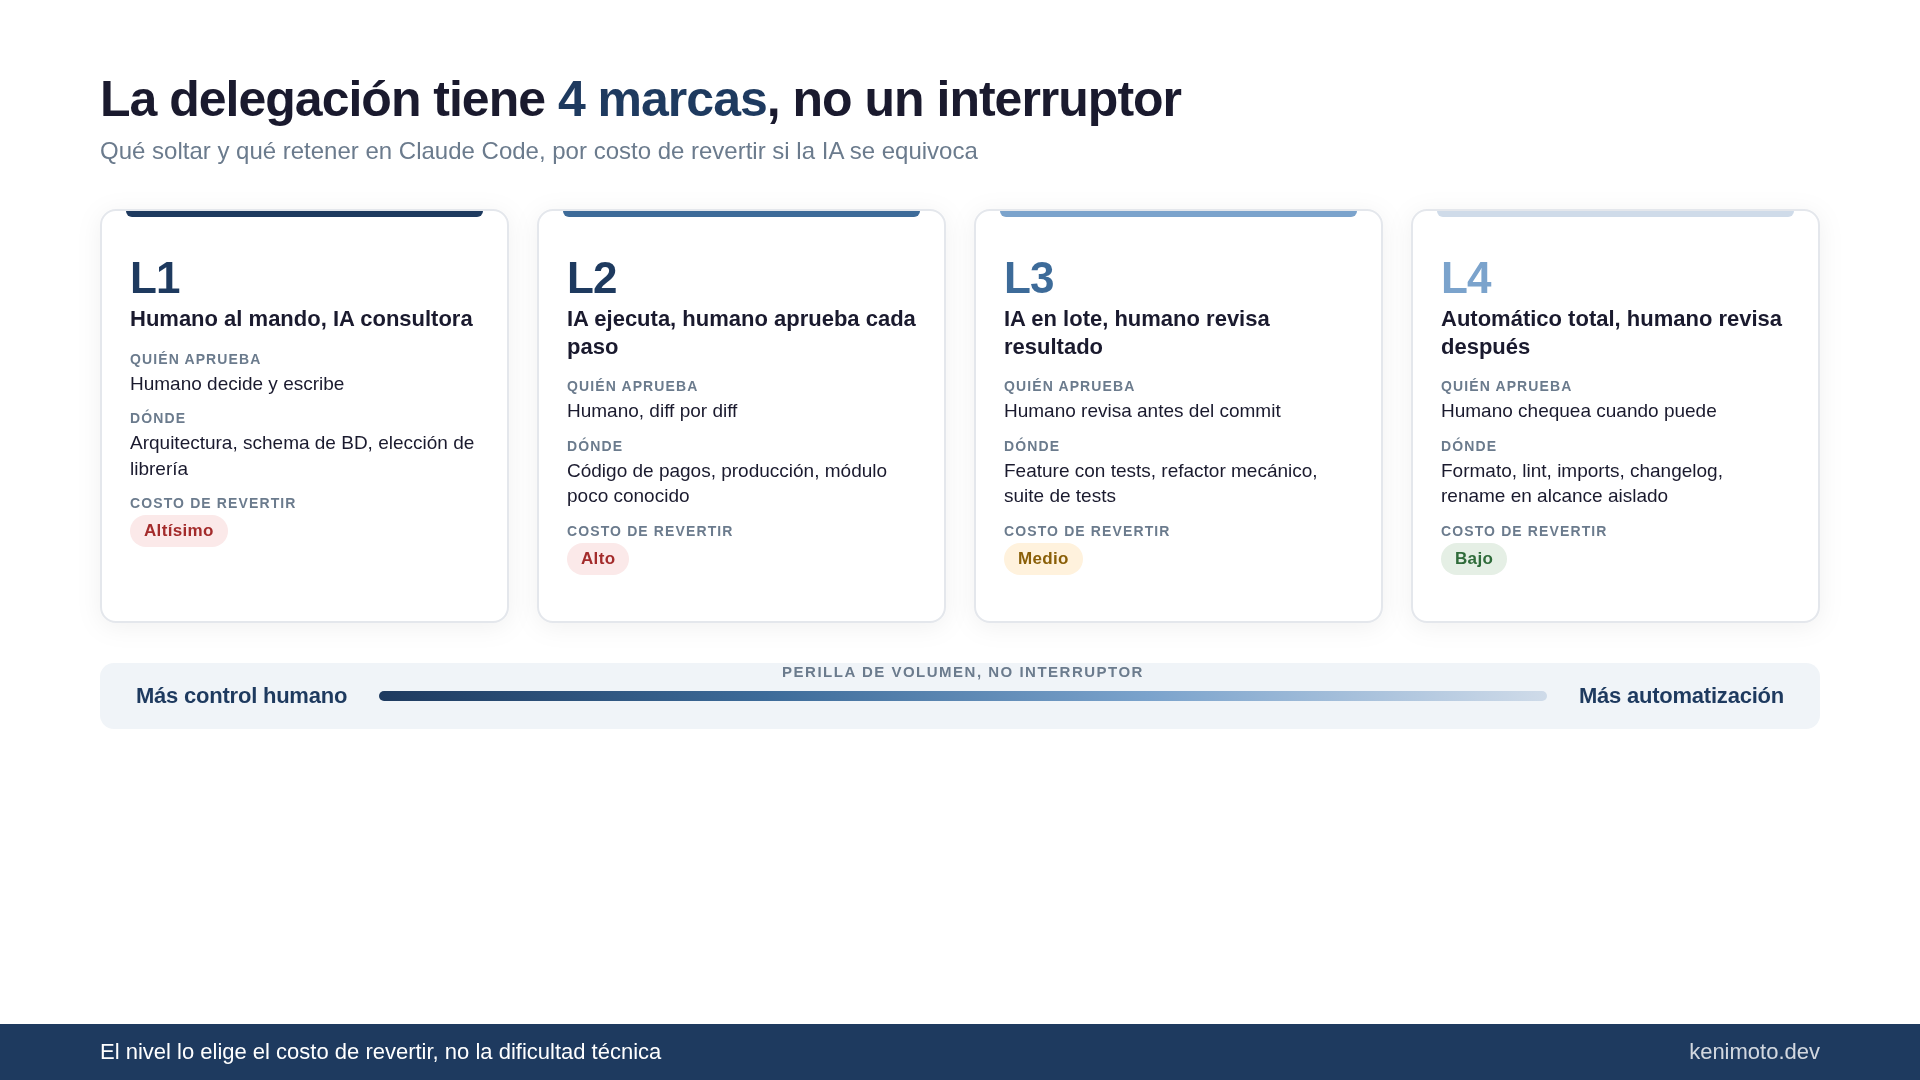
Los 4 niveles
L1 — Humano al mando, IA como consultora
La IA sugiere, yo decido y ejecuto. Nada entra al código sin que yo lo escriba.
Dónde lo uso: cambios de arquitectura, elección de librería, diseño de schema de base de datos, cualquier decisión difícil de deshacer. Acá entra el plan mode de Claude Code, que arma la estrategia antes de tocar un solo archivo. El agente piensa conmigo, pero la mano es mía.
¿La refactorización que me costó una tarde? Era una tarea de L1 que yo traté como L4. El fallo no fue de la IA. Fue mío, de granularidad.
L2 — IA ejecuta, humano aprueba cada paso
La IA escribe, pero cada escritura de archivo y cada comando de shell se detiene y pide mi confirmación. Es el modo Manual de Claude Code (el que las versiones anteriores a la llegada del auto mode arrancaban por defecto), y sigue siendo el más seguro cuando toco una base de código que no conozco bien.
Dónde lo uso: implementar una función nueva en un módulo que domino poco, tocar código de pagos, cualquier cosa en producción. Leo cada diff antes de aprobar. Es más lento, y lo es a propósito.
L3 — IA ejecuta en lote, humano revisa el resultado
La IA toca varios archivos sin parar en cada uno, y yo reviso el conjunto al final, antes del commit. En Claude Code esto es el --permission-mode acceptEdits (pasa derecho en lecturas, ediciones de archivo y comandos de filesystem como mkdir, mv o cp, y aún se detiene en el resto de comandos de shell) o el auto mode con el clasificador de guardia.
Dónde lo uso: implementar una funcionalidad bien especificada con tests, refactorización mecánica en un módulo que conozco, escribir la batería de tests de una función ya cerrada. El alcance es claro, así que confío en el lote y gasto mi atención en la revisión final, no en cada paso.
L4 — Automático total, humano revisa después (o no revisa)
La IA hace y sigue. Yo miro el resultado cuando puedo, o ni lo miro.
Dónde lo uso: formatear código, acomodar imports, actualizar changelog, renombrar variable en un alcance aislado, corregir lint. Tareas donde el peor caso es trivial de deshacer. Acá --dangerously-skip-permissions tiene sentido, pero solo dentro de un contenedor descartable, nunca en mi computadora de trabajo.
La regla que decide el nivel: costo de revertir
Lo que decide el nivel es una sola pregunta: cuánto cuesta deshacer si la IA se equivoca. Fíjate que la dificultad técnica no entra en esa cuenta.
| Nivel | Quién aprueba | Costo de revertir | Ejemplo |
|---|---|---|---|
| L1 | Humano decide y ejecuta | Altísimo | Cambio de arquitectura |
| L2 | Humano aprueba cada paso | Alto | Feature en producción |
| L3 | Humano revisa el lote | Medio | Feature con tests |
| L4 | Humano revisa después | Bajo | Formato, lint |
Reescribir la capa de base de datos sale carísimo de deshacer, así que es L1 por más que la IA técnicamente dé la talla. Correr el formateador es trivial de deshacer, así que es L4, aunque también sea “tocar el código”. La dificultad técnica no entra en la cuenta. Entra el tamaño del golpe si algo se escapa.
La confianza sube, pero el nivel es por tarea
Hay un patrón que coincide con lo que yo mismo viví: a más tiempo con el agente, más suelta la mano. La auto-aprobación se vuelve hábito con el uso.
Tiene sentido: la confianza crece con la convivencia. Pero ahí hay una trampa. Confianza y costo de revertir son cosas distintas. Yo puedo confiar al 100% en Claude y seguir reteniendo el cambio de arquitectura en L1, porque el problema nunca fue su competencia. Es el tamaño del porrazo si algo se escapa.
Así que la confianza mueve el nivel por defecto de las tareas pequeñas hacia arriba, con el tiempo. No mueve el cambio de arquitectura fuera de L1. Esa sigue siendo decisión humana, por más sesiones acumuladas que tengas encima.
Este patrón se conecta con lo que ya documentó el estudio METR: la sensación de velocidad no coincide con el reloj. Si tu sensación de “Claude me acelera” sube cada semana, el nivel 4 va a jalar hacia él, y no siempre hacia donde conviene.
3 reglas prácticas que me quedaron
Con el tiempo me quedé con estas tres reglas, que son las que uso cuando dudo en qué nivel poner una tarea nueva.
Regla 1 — El nivel lo elige el costo de revertir, no la dificultad técnica
Formatear 300 archivos es técnicamente agresivo y es L4. Cambiar el nombre de una tabla en producción es técnicamente trivial y es L1. La pregunta operativa no es “¿puede la IA hacerlo?”. Es “¿cuánto cuesta volver atrás si se equivoca?”.
Regla 2 — La confianza no promueve arquitectura
La confianza mueve tareas pequeñas hacia niveles más automáticos. Está bien. Lo que no hace, aunque sientas que sí, es sacar las decisiones de arquitectura del L1. Esas se quedan ahí incluso cuando ya pasaron meses de uso diario sin incidentes. Si en algún momento te descubres promoviendo “refactoriza esto” al L4, el error no es de la IA.
Regla 3 — En equipo, los niveles viven en el CLAUDE.md
Si trabajas con otros, el nivel de delegación no puede quedar en la cabeza de cada uno. Si un desarrollador trata una migración de BD como L4 y otro como L1, el resultado se vuelve impredecible por persona.
El patrón que me parece el más limpio es escribir los niveles en el CLAUDE.md del proyecto: qué es siempre L1 (necesita gente decidiendo), qué puede subir a L3 o L4. Pasa a ser acuerdo de equipo, no preferencia individual. Cuesta una tarde escribirlo y, si tu equipo lo adopta, ahorra la discusión de “¿por qué el agente tocó esto?” durante el resto del trimestre.
Antes y después, en mi flujo
Antes de dibujar los niveles, corría casi todo en el mismo modo y me decepcionaba en direcciones opuestas: o perdía tiempo aprobando formato de imports paso a paso (L4 tratado como L2), o me llevaba un susto con una refactorización grande (L1 tratada como L4). El mismo agente, sin perilla de volumen, suena bien y suena mal al mismo tiempo.
Después, cambió lo siguiente:
- Las decisiones de arquitectura pasan por plan mode, y dejé de descubrir cambios estructurales dentro del diff.
- Las funcionalidades con tests corren en lote, y reviso el conjunto en vez de cada paso.
- El formato y el lint corren solos, y ni los miro.
El beneficio no vino de que la IA se volviera más rápida. Vino de dejar de gastar atención en el nivel equivocado. La atención es el recurso escaso, no los tokens.
“No automatices todo” no tiene que ver con miedo a la IA. Es la constatación de que delegación sin granularidad se convierte en retrabajo. La perilla de volumen tiene cuatro marcas. Saber en cuál girarla es el trabajo de quien usa al agente, y es lo que decide si ayuda o estorba.
Si quieres armar el CLAUDE.md y los flujos de plan mode con los que esto funciona en un equipo, lo dejé mapeado en el libro Practical Claude Code. Y si antes de delegar quieres ponerle número a tu “sensación de velocidad”, el post de Vibe Coding y METR explica por qué la perilla no se puede girar de oído.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev
 Libro relacionado Practical Claude Code Claude Code desde cero hasta producción — CLAUDE.md, Plan Mode y workflows de equipo, desde un año de uso real Ver la página del libro →
¿Te resultó útil este artículo?