Primera oración: 7 de 12 páginas citadas por IA
La IA no cita páginas, cita párrafos. Y en cada párrafo tiende a quedarse con lo que aparece arriba. Hace algunas semanas me senté a probar esa idea con mi propio sitio: tomé 12 páginas, reescribí la primera oración de cada sección para que fuera literalmente la respuesta a lo que preguntaba el encabezado, y medí qué hacían los motores de IA. Siete empezaron a aparecer en más citas. Cinco no se movieron. La diferencia entre esos dos grupos terminó siendo la lección real del experimento, y no era la que yo esperaba apuntar.
La hipótesis era casi insultantemente simple. Si los motores de IA toman las primeras una o dos oraciones de una sección para armar sus respuestas, entonces enterrar la respuesta bajo un párrafo de contexto es el equivalente de escritura a esconder el remate detrás de la servilleta. Dejé de hacer eso en 12 páginas y miré el resultado. No es una muestra para escribir una ley, pero es suficiente para separar lo que funciona de lo que es solo narrativa de LinkedIn.
Qué significa “answer-first” en concreto
Answer-first quiere decir que la primera oración de una sección es la respuesta a la pregunta que el encabezado implica. La explicación va después, no antes. Eso es toda la táctica. No es markup estructurado, no es señal de frescor, no es diseño de pasajes a nivel retrieval. Es el orden en el que pones tus propias oraciones.
Quiero ser preciso acá porque “escribir para la IA” se volvió una frase que la gente usa para decir nada. No toqué JSON-LD en ninguna de estas páginas. No cambié fechas de publicación. No agregué encabezados ni reorganicé enlaces internos. Cambié exactamente una cosa por sección: moví al primer renglón la oración que de verdad respondía al encabezado, y borré lo que corría delante de ella.
Si una sección empezaba con “Hay muchos factores que considerar al elegir una herramienta, y el panorama cambió bastante los últimos meses”, esa oración murió, y la línea que nombraba la respuesta pasó a ocupar su lugar.
El motivo por el que esto importa está alineado con lo que los análisis de citas de IA vienen reportando. Un análisis sobre 3 millones de respuestas de ChatGPT y 30 millones de citas encontró que el 44,2% de las citas vienen del primer 30% del texto de una página, mientras que la mitad del medio y el cierre se reparten el resto. Si casi la mitad de las citas se cosechan del tercio superior de la página, entonces el inicio de cada sección es el pedazo de inmueble más caro que tienes. Yo lo había alquilado para hacer calentamiento.
Cómo medí
Corrí las mismas 30 preguntas en ChatGPT Search, Perplexity, Gemini, Claude con búsqueda web y Brave Leo durante seis lunes seguidos: tres semanas antes de la reescritura y tres después, mismo set de preguntas, mismos motores, mismo ritual de lunes a la mañana. Registré cuántas veces aparecía cada una de las 12 páginas como cita clickeable. Las preguntas se quedaron congeladas, así que lo único que cambiaba entre antes y después era la escritura.
Dos aclaraciones, porque me quemé antes con mi propio optimismo. Seis semanas es poco, y las citas de IA tienen su propio ciclo de decaimiento, así que una parte de esto es ruido vestido con bata de laboratorio. Y n=12 es un tamaño de muestra que haría a un estadístico cambiar de tema con elegancia. Esto es la medición de un ingeniero trabajando sobre su propio blog, no un estudio. Léelo como nota de campo, no como ley.
Las 7 páginas que se movieron
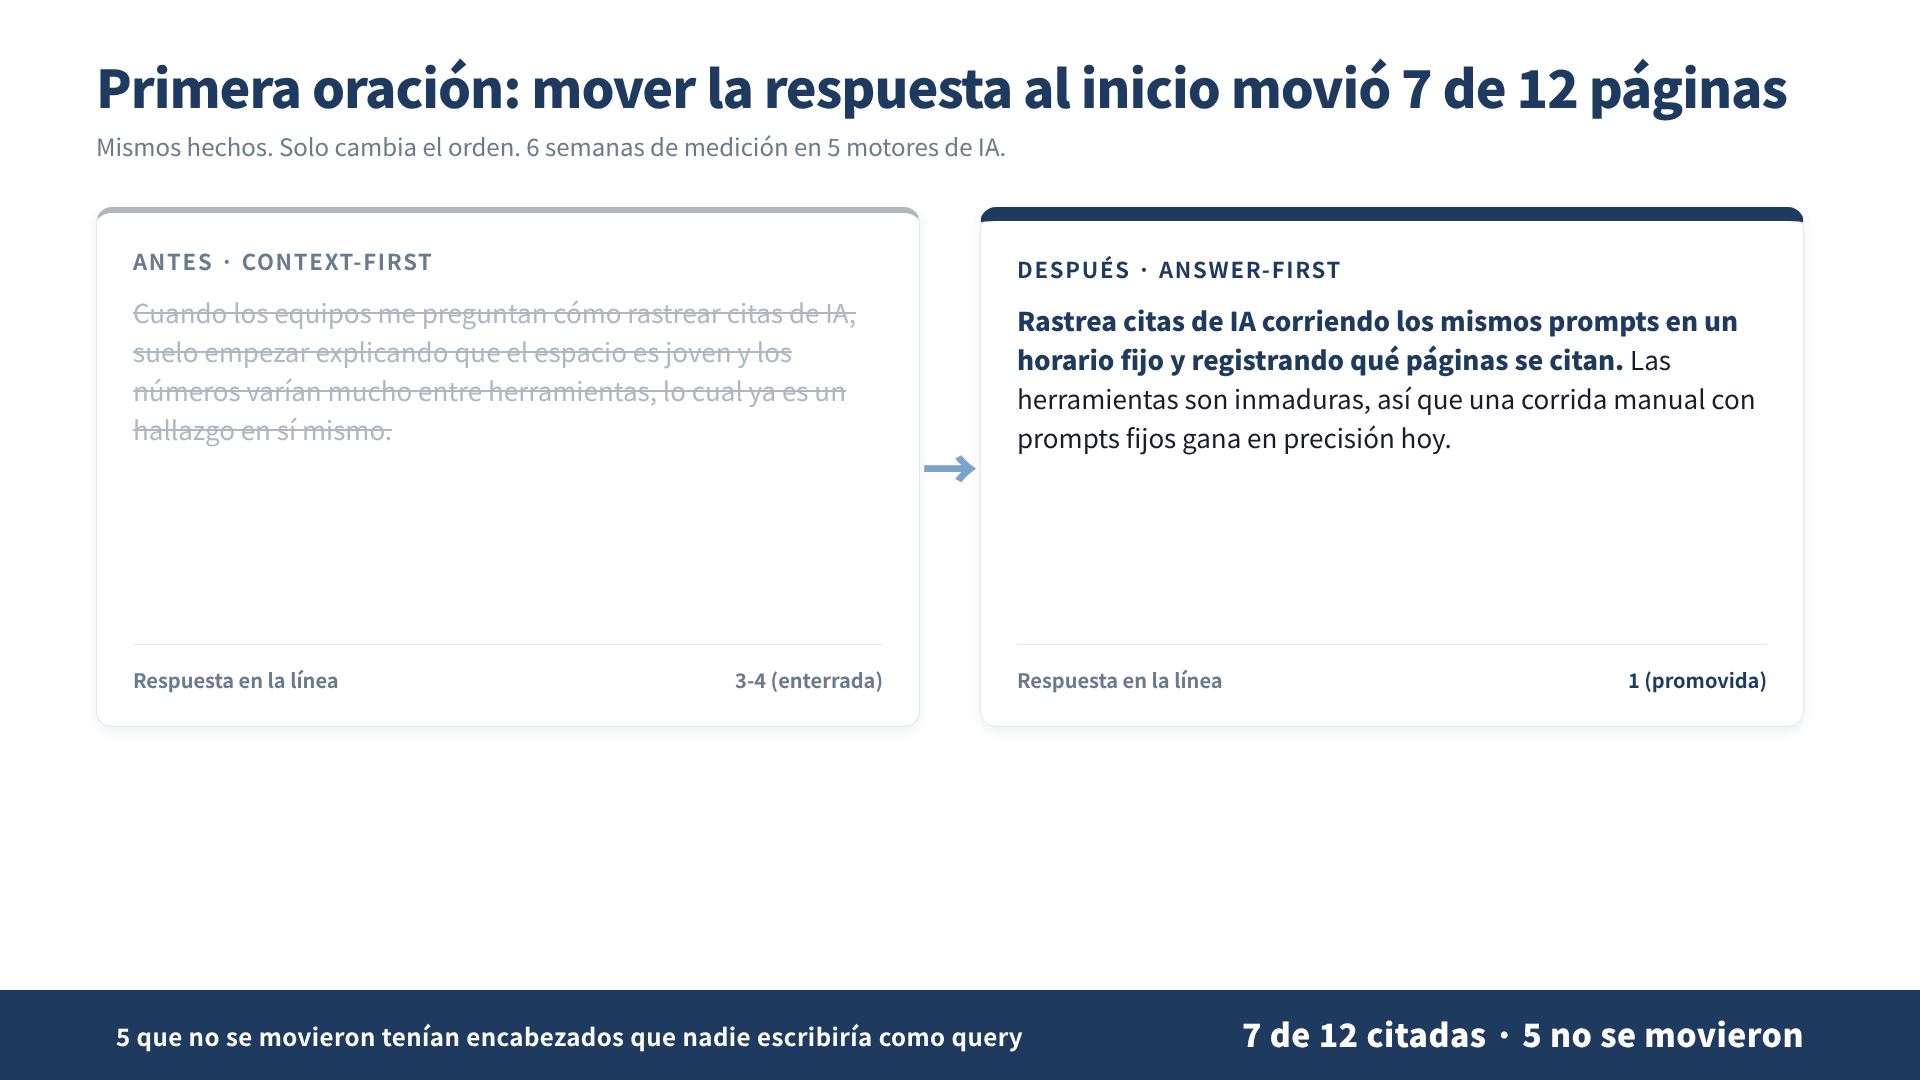
El patrón del cambio queda más claro si lo ves con un ejemplo. Mismo contenido, mismo hecho, solo cambió el orden:
ANTES (contexto primero):
  "Cuando los equipos me preguntan cómo rastrear citas de IA, suelo
   empezar explicando que el espacio de herramientas es muy joven y
   que los números varían mucho entre una herramienta y otra, lo cual
   ya es un hallazgo que vale la pena pensar un poco."

DESPUÉS (respuesta primero):
  "Rastrea las citas de IA corriendo las mismas preguntas con un
   calendario fijo y anotando qué páginas aparecen citadas. Las
   herramientas todavía están inmaduras, así que una corrida manual
   con preguntas fijas le gana en precisión a casi cualquier tracker
   del mercado hoy."
Las siete páginas que ganaron citas tenían un rasgo en común: cada una tenía una sección cuyo encabezado era una pregunta real que alguien podría tipear, y cuya respuesta encajaba limpiamente en una o dos oraciones adelantadas. “Cómo rastreo las citas de IA.” “Cuál es la diferencia entre page rank y passage rank.” “Por qué el tráfico se mantuvo plano mientras las citas bajaban.” Preguntas concretas con respuestas concretas y levantables. Cuando la respuesta vivía al principio de la sección, los motores podían agarrarla sin tener que descifrar mi estructura de párrafos. Y la agarraron.
Los pasajes que mejor funcionaron cayeron en el rango de 40 a 75 palabras, que es aproximadamente la longitud que ChatGPT, Perplexity y Google AI Overviews tienden a citar según mediciones del 2025 y 2026. Suficientemente corto para levantarse entero, suficientemente largo para sostenerse solo. Esa longitud no la calibré a propósito al principio. Las páginas que la tocaron de casualidad fueron las que ganaron, y así fue como aprendí a apuntar hacia ella en el resto.
Las 5 que no, y por qué ese es el hallazgo real
Las cinco páginas que ignoraron mi esfuerzo me enseñaron más que las siete que colaboraron. Tenían una cosa en común: sus encabezados no eran preguntas que alguien tipearía, así que no había ninguna pregunta que la primera oración pudiera responder.
Un encabezado como “Sobre la filosofía de la medición” no es una consulta. Nadie la tipea. Cuando “arreglé” la primera oración debajo de ese título, estaba respondiendo primero a una pregunta que no existía, lo cual es un poco como dejar la luz del porche prendida para un invitado que nunca fue invitado. La mecánica de la reescritura estaba bien. El blanco era imaginario.
Así que el hallazgo debajo del hallazgo es este: answer-first no es un truco de escritura que aplicas a oraciones. Solo funciona cuando el encabezado que está arriba de la oración es una pregunta que alguien hace de verdad. Dos de esas cinco páginas las reescribí después al nivel de encabezado, convirtiendo una vibra en una pregunta, y dos de ellas empezaron a aparecer en citas la semana siguiente. La quinta es sobre mis sentimientos acerca de un framework deprecado y se merece su oscuridad.
Answer-first no es lo mismo que “snippet-worthy”
Vale aclarar una confusión que se repite en los artículos de LLMO en español, porque son dos cosas distintas que a veces se mezclan en el mismo consejo.
Snippet-worthy se refiere a la forma del pasaje: autocontenido, sin referencias a “como se vio arriba”, con un rango de palabras que lo haga levantable. Es diseño de párrafo.
Answer-first se refiere al orden dentro de la sección: la oración con la respuesta va primero, no al final. Es orden de oraciones.
Puedes tener un párrafo perfectamente snippet-worthy que empieza con calentamiento y entrega la respuesta en la oración cuatro. La IA puede citar ese párrafo si lo encuentra, pero gana muchísimo menos cuando compite con un párrafo que arranca con la respuesta. Y al revés: puedes tener una primera oración answer-first dentro de un párrafo que depende de información del párrafo anterior (“como mencioné antes…”) y entonces la IA te cita y la cita no tiene sentido fuera de contexto.
Las dos disciplinas funcionan juntas. En mi experimento solo moví answer-first, porque mis párrafos ya eran razonablemente autocontenidos. Si tus párrafos todavía dependen de los que están arriba, cambiar la primera oración no te va a mover la aguja — primero tienes que cortar las anclas.
Qué haría yo el lunes
Elige tus diez páginas más importantes y lee en voz alta solo la primera oración de cada sección, ignorando todo lo que viene abajo. Si esa oración no responde al encabezado, encontraste una sección invisible para la extracción de IA sin importar qué tan bueno sea el párrafo debajo. Asciende la respuesta. Borra el preámbulo.
Después pregúntate si el encabezado mismo es una pregunta que alguien tipearía. Si no lo es, el answer-first no te va a ayudar — el problema está un nivel más arriba. Reescribe el encabezado antes que la primera oración.
Y si quieres la base técnica que va debajo de esto (llms.txt + JSON-LD servidos del lado del servidor), ya la cubrí en LLMO en 15 minutos. Ese artículo es la puerta de entrada. Este es el nivel siguiente: una vez que los crawlers de IA llegan a tu sitio, qué les das para citar.
La toma
Mover la primera oración movió 7 de mis 12 páginas y dejó 5 sin tocar. Los 5 fracasos aclararon la regla mejor que los 7 aciertos: answer-first solo paga cuando hay una pregunta real para que la respuesta responda. La táctica es una oración. La disciplina es asegurarte de que esa oración tenga un trabajo que hacer.
Pasé seis semanas probando algo que un buen editor me habría dicho gratis, pero por lo menos ahora tengo los registros de citas para que parezca ciencia.
Para el fondo de este tema — cómo diseñar el contexto que la IA realmente lee, no solo el que crees que lee — el libro Context Engineering sistematiza el enfoque completo. Este artículo es una técnica. El libro es el método.
Y si tienes curiosidad por la versión original de este experimento, también la escribí en inglés.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev
 Libro relacionado Convirtiendo LLMs de Mentirosos en Expertos Ingeniería de Contexto desde cero — RAG, MCP, CLAUDE.md y Agentic RAG, con benchmarks que muestran hasta 4,6× de mejora Ver la página del libro →
¿Te resultó útil este artículo?