Vibe Coding en 2026: sensación +20%, METR -19%
Cuando termino una tarea con Claude Code, mi cerebro escupe la misma frase antes de que yo alcance a pensar: “esta vez fue mucho más rápido”. Lo digo en voz baja, me levanto por café, cierro el día contento. Y ese “mucho más rápido” fue justo lo que METR cronometró y desarmó.
En julio de 2025 METR publicó un ensayo controlado aleatorizado (RCT) con 16 desarrolladores open source experimentados sobre 246 tareas en sus propios repos (paper en arXiv 2507.09089). Los números pegan fuerte en una sola dirección:
- Antes de empezar, los devs predijeron que la IA los aceleraría un +24%.
- Después de terminar, seguían creyendo que habían ido un +20% más rápido.
- El cronómetro midió lo contrario: -19%. Tardaron 19% más con permiso de usar IA.
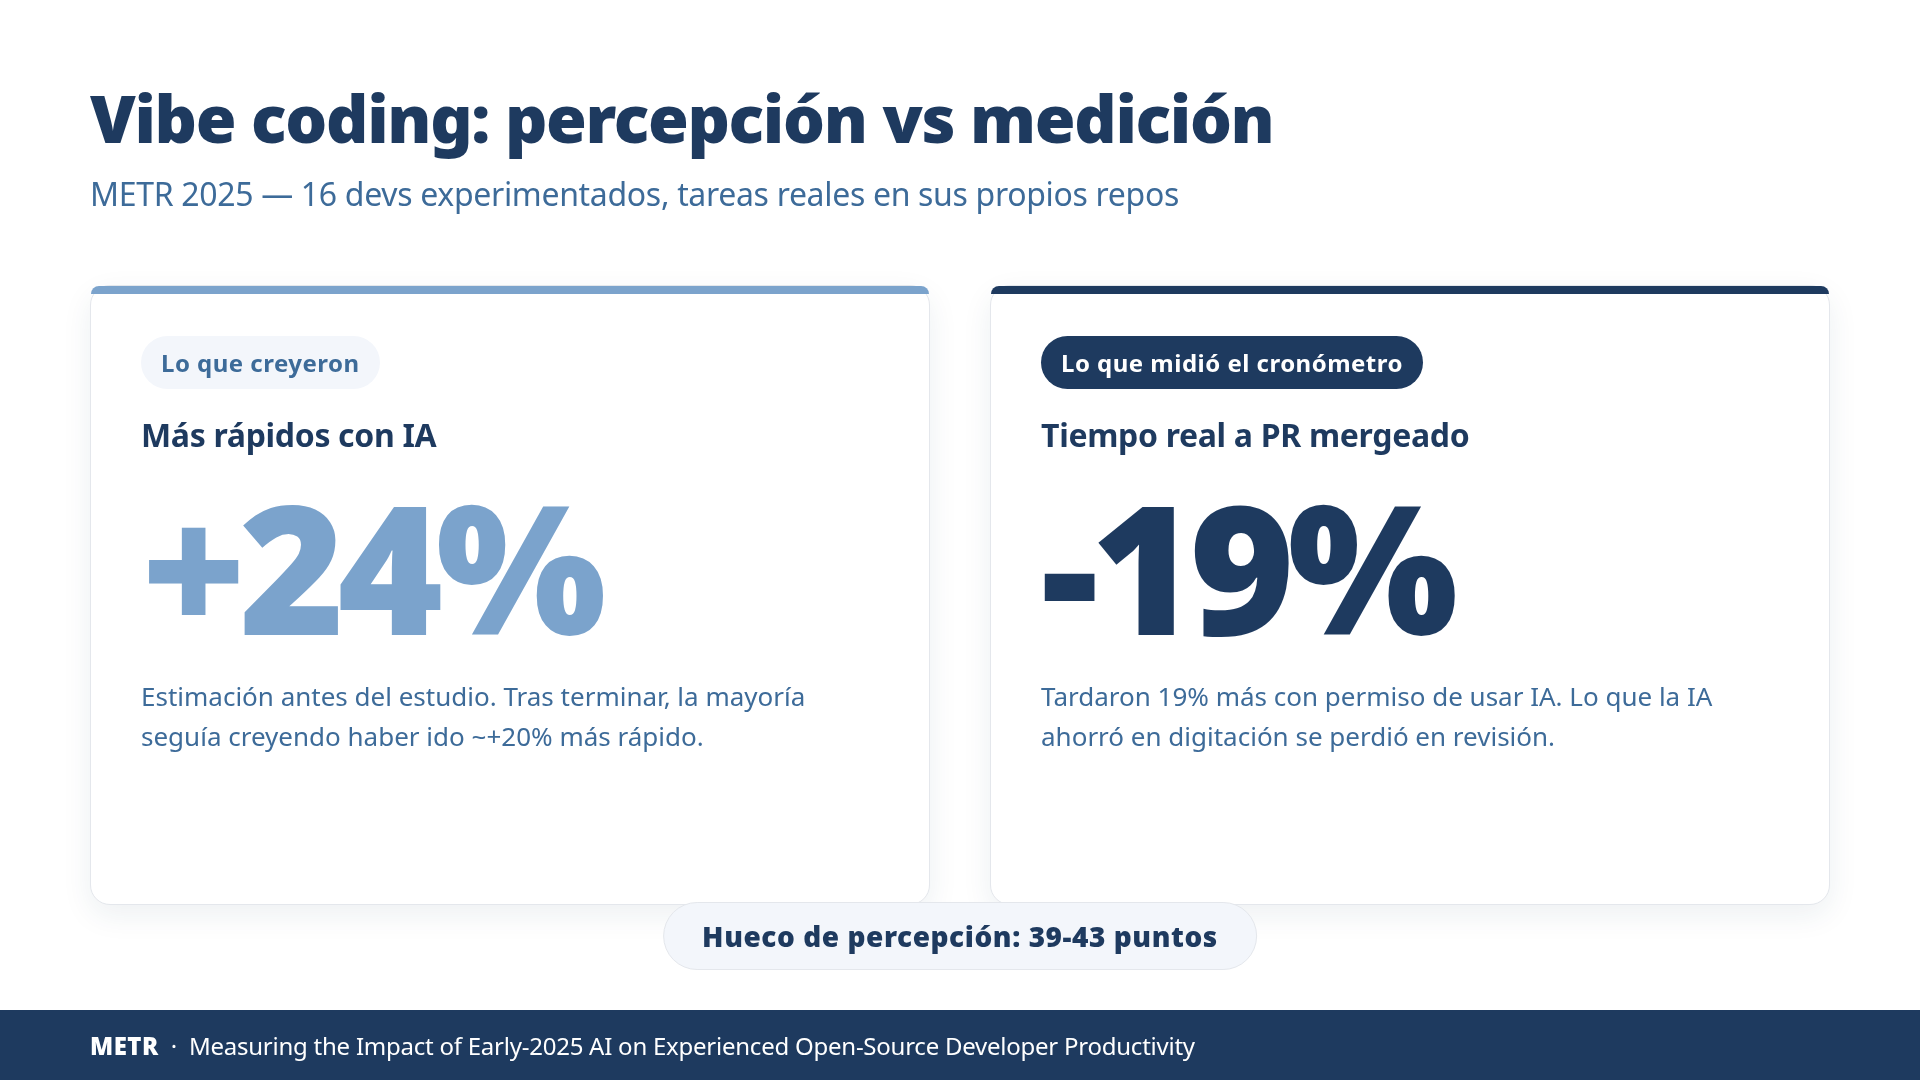
39 puntos de hueco entre lo que sentiste y lo que marcó el reloj. En una sola dirección. Y los participantes no son juniors: 5 años de media en el repo, sabiendo que los estaban midiendo. Si ellos cayeron, no es cuestión de “poner más atención”.
Releí el paper tres veces buscando una grieta en la metodología. No la encontré. La grieta estaba en mi forma de recordar la jornada.
Lo que el cronómetro ve y el cerebro no
El fenómeno tiene nombre viejo y bien documentado: sesgo de automatización. En aviación lleva décadas apareciendo cada vez que la cabina confía demasiado en el piloto automático. En noviembre de 2024 el Georgetown CSET publicó un brief (AI Safety and Automation Bias) que lo documenta a través de casos en Tesla, aviación y defensa aérea. El mismo mecanismo aparece cuando el “piloto” es un LLM generando código.
La firma es siempre la misma. Cuando algo “sale a la primera”, el cerebro atribuye la facilidad a tu propia habilidad. Lo que no atribuye son los 15 minutos que pasaste releyendo la sugerencia, reescribiendo los bordes, descartando dos intentos que no compilaron. Esa parte se evapora del recuerdo. Queda registrado solo “escribí la función en 5 minutos”.
Eso es exactamente lo que METR cronometró. Los devs no mintieron. Olvidaron las fricciones que, en un día sin IA, sí habrían entrado en la cuenta.
Tres señales de que mides sensación, no tiempo
El Vibe Coding se descompone en varias capas de sesgo cognitivo que se apilan una sobre otra. Yo no voy a hacer la taxonomía completa: me quedo con las tres señales que puedes correr tú en tu propio flujo antes del próximo merge. Ninguna de las tres se resuelve con “ser más cuidadoso”.
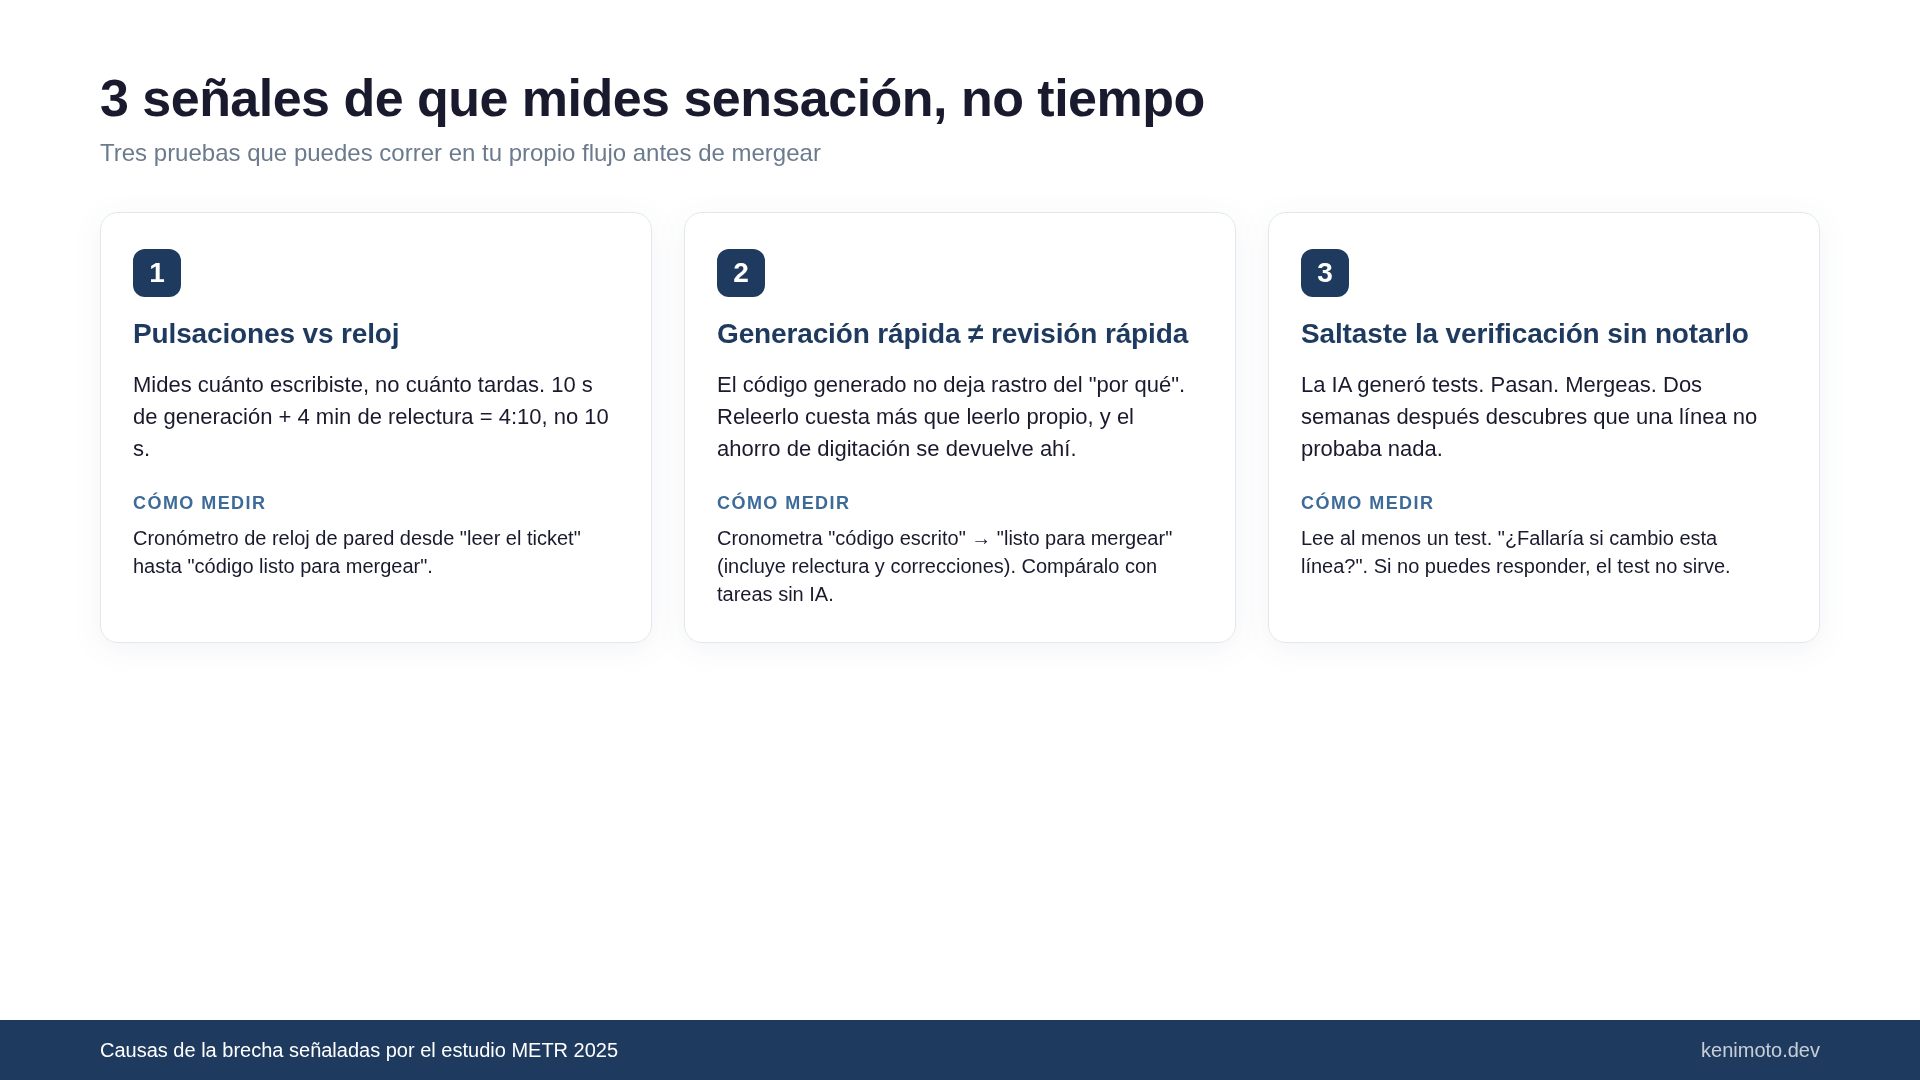
1. Pulsaciones vs reloj
Lo que recuerdas es cuánto escribiste, no cuánto tardaste. Si la IA generó 40 líneas en 10 segundos y tú gastaste 4 minutos releyendo y corrigiendo bordes, la tarea tardó 4:10. No 10 segundos. El cerebro registra la cifra bonita.
Cómo medir: cronómetro de reloj de pared desde “leer el ticket” hasta “código listo para mergear”. No desde “la IA generó” hasta “pegué el bloque”. Esa segunda ventana no es la tarea; es la parte de la tarea que se parece a magia.
2. Generación rápida ≠ revisión rápida
El código que generaste tú deja un rastro mental del “por qué”: sabes qué estabas pensando, por qué elegiste ese patrón, qué descartaste. El código que generó una IA no deja ese rastro. Releerlo cuesta más que leer el tuyo. Lo que la IA se ahorró en digitación, se devuelve ahí.
Cómo medir: cronometra el intervalo “código escrito” → “listo para mergear” (incluye relectura, correcciones, y ajustes de tests). Compara ese intervalo contra tareas donde escribiste tú. No contra “código que sentiste parecido”.
Un detalle con el que me he agarrado yo mismo esta semana: estaba usando for loops en TypeScript porque la IA los había escrito así, incluso cuando map o filter eran claramente más limpios. No fue elección. Fue anclaje al primer output.
3. Saltaste la verificación sin notarlo
Este es el caro. La IA generó tests. Pasan. Mergeas. Dos semanas después descubres que una línea del test no probaba nada: comparaba undefined con undefined, o se mockeaba el método que supuestamente estaba verificando.
Cómo medir: lee al menos un test que tú no escribiste. Hazte una pregunta sola: “¿Este test fallaría si cambio esta línea del código a algo obviamente roto?”. Si no puedes responder sí o no en 10 segundos, el test no sirve. El OWASP Top 10 for LLM Applications listaba exactamente este patrón bajo “Overreliance” (LLM09 en la edición 2023, absorbido en “Misinformation” en 2025).
Por qué “ser más cauteloso” no resuelve
La primera reacción tras leer el paper del METR suele ser “ok, voy a prestar más atención”. Y no funciona. El sesgo de automatización no es una falla de atención: es economía cognitiva de fábrica. “Ser más cuidadoso” significa gastar System 2 (lento y caro) en un sitio donde el cerebro insiste en usar System 1 (rápido y barato). Lo puedes hacer media hora. El día entero, imposible.
Lo que a mí me ha ayudado estos meses con Claude Code son rituales que sacan la verificación del flujo, es decir, que no dependen de que yo tenga pique en ese momento:
- Antes de aceptar una sugerencia, me obligo a escribir en una línea “¿cómo lo escribiría yo desde cero?”. No para rechazar la sugerencia; para romper el anclaje del primer output.
- Le pido al mismo LLM “lístame tres debilidades concretas de esta respuesta”. No depende de mi disciplina y suele encontrar al menos una.
- Corro el código en edge cases que el test generado por la IA no cubre. Este es el que me da pereza. Es también el que atrapa más bugs, porque un test generado por la IA rara vez atrapa bugs del código generado por la misma IA.
Lo que no voy a inventar
Un disclaimer honesto. Yo trabajo solo, hago merge de mis propios PRs, y no tengo un equipo que me diga “este PR tardó más en pasar review que el anterior”. Las métricas que yo puedo medir en mi flujo son wall-clock de tarea, cantidad de tests que leí a conciencia, y cuántas veces tuve que volver sobre código generado dos semanas después. No tengo review-latency, ni comparación con una mediana de equipo, ni un dashboard de velocidad agregada.
Lo que sí puedo ofrecer es exactamente lo mismo que el METR: el experimento es reproducible en tu propio día a día. Dos semanas cronometrando tareas en dos canastas (con IA y sin IA, mismo tipo de problema) y sales con un número personal. Ese número va a ser distinto del mío, probablemente distinto del METR también, y es el único que decide algo para tu rutina.
Una métrica agregada tipo “productividad con IA” no sirve para tomar decisiones. “Mi productividad con IA, en mi repo, sobre mis tareas” sí.
El riesgo más grande vive en “funcionó”
El peor efecto del Vibe Coding no es la lentitud del 19%. Es que “funcionó” empieza a alcanzar como criterio.
“Funcionó”, “está correcto” y “es mantenible” son tres cosas distintas. El loop corto del Vibe Coding (pregunta, respuesta, corre, verde) libera dopamina sobre el primero. Los otros dos quedan para después. “Después” casi siempre se convierte en “para quien tome este código dentro de seis meses”.
Esto no es un argumento contra la IA. Es un argumento contra confundir “me siento productivo” con “estoy produciendo”. El METR demostró que lo primero no es un buen proxy de lo segundo, ni siquiera con cinco años de experiencia encima.
Cierre
Si de este post te vas a llevar una sola cosa, llévate esta: la próxima vez que termines una tarea con Claude Code y esa voz interna te diga “fue rapidísimo”, pon el cronómetro, mide la tarea real de verdad, y compárala con una tarea parecida sin IA. Hazlo diez veces seguidas. Vas a tener un número.
Puede dar positivo (felicidades, saliste del patrón METR), puede dar cero, puede dar negativo. Da lo mismo cuál: lo valioso es que saliste de la sensación. Y la sensación, como vimos, es el sesgo trabajando a tiempo completo.
Si quieres pensar esto a nivel de sistema en lugar de a nivel de prompt (qué estructura meter alrededor del LLM para que la verificación no dependa de tu voluntad), ese es el tema del libro Harness Engineering: de usar IA a controlar IA. Para medir en lugar de sentir, tienes que pensar en el arnés, no en el prompt.
También te puede servir leer, en el mismo registro de “mide antes de confiar”, dos entradas de este blog:
- Borré 3 Claude Code Skills que dormían en 18k tokens — qué pasa cuando mides lo que de verdad usas.
- 7 archivos de Claude Code: checklist de context engineering en 5 minutos — para dejar de confiar en el “contexto que creo haberle dado”.
La IA no pide menos ingeniero. Pide ingeniero que se mida a sí mismo. Ese es el cambio de oficio de 2026.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev
 Libro relacionado Harness Engineering Harness Engineering desde cero — cinco interpretaciones (OpenAI, Anthropic, LangChain, Martin Fowler, academia) unificadas en un solo sistema para ingenieros en producción Ver la página del libro →
¿Te resultó útil este artículo?