Claude Code vs local LLM: Qwen 35B 5/5 vs 0/5
Qwen 3.6 35B-A3B escribió código correcto para los cinco ejercicios. Y no terminó ninguno.
El resultado es extraño si lo miras una sola vez. El agente local cargó el modelo en una RTX 4070, leyó el enunciado, modificó los archivos, y las pruebas ocultas pasaron en los cinco casos. Técnicamente, el código estaba bien. Pero el agente no pudo cerrar la tarea: se quedó intentando ejecutar las pruebas sin tener shell, reescribió el runner una y otra vez, y al final excedió los 32.768 tokens de contexto y se detuvo con un error 400.
Claude Code hizo las mismas cinco, sin shell y con shell, en 17 y 24 segundos de mediana. Terminó limpio en todas.
Lo que medí
La prueba vive en iris-lab/experiments/049-local-vs-claude-code-split. Hardware: RTX 4070 12GB, driver 591.86, CUDA 13.1, i7-14700KF, WSL2 con 31,5 GiB de RAM. El servidor local fue llama-server con --jinja, ctx 32.768, thinking off, temperature 0. Nada de nube en la parte local; nada ajustado a mano para Claude Code más allá de --permission-mode acceptEdits.
Cinco tareas pequeñas en repos de git desechables:
- a1 newfile — crear un módulo nuevo que satisfaga 5 tests
- a2 bugfix_months — arreglar un bug de fin de mes con un edge case bisiesto
- a3 bugfix_inventory — arreglar un bug en un sistema de stock con docstring explícita
- a4 multifile_currency — formateo de moneda tocando varios archivos
- a5 add_tests — escribir tests que cacen 7 mutantes sin romper la implementación correcta
Cada agente arrancó con el mismo prompt y el mismo repo. El corredor contó pasos, tokens, y segundos. Las pruebas ocultas calificaron al final.
Los agentes fueron cinco:
| Agente | Herramientas | Backend |
|---|---|---|
| claw-code + 9B | read/write/glob/edit | llama-server local |
| claw-code + 35B-A3B | igual | igual |
| Qwen Code + 35B-A3B | auto-edit, sin shell, 30 tools / 870 s | igual |
| Claude Code (solo edición) | sin Bash | API, sonnet-5 |
| Claude Code (pytest OK) | con Bash | igual |
El resultado agregado
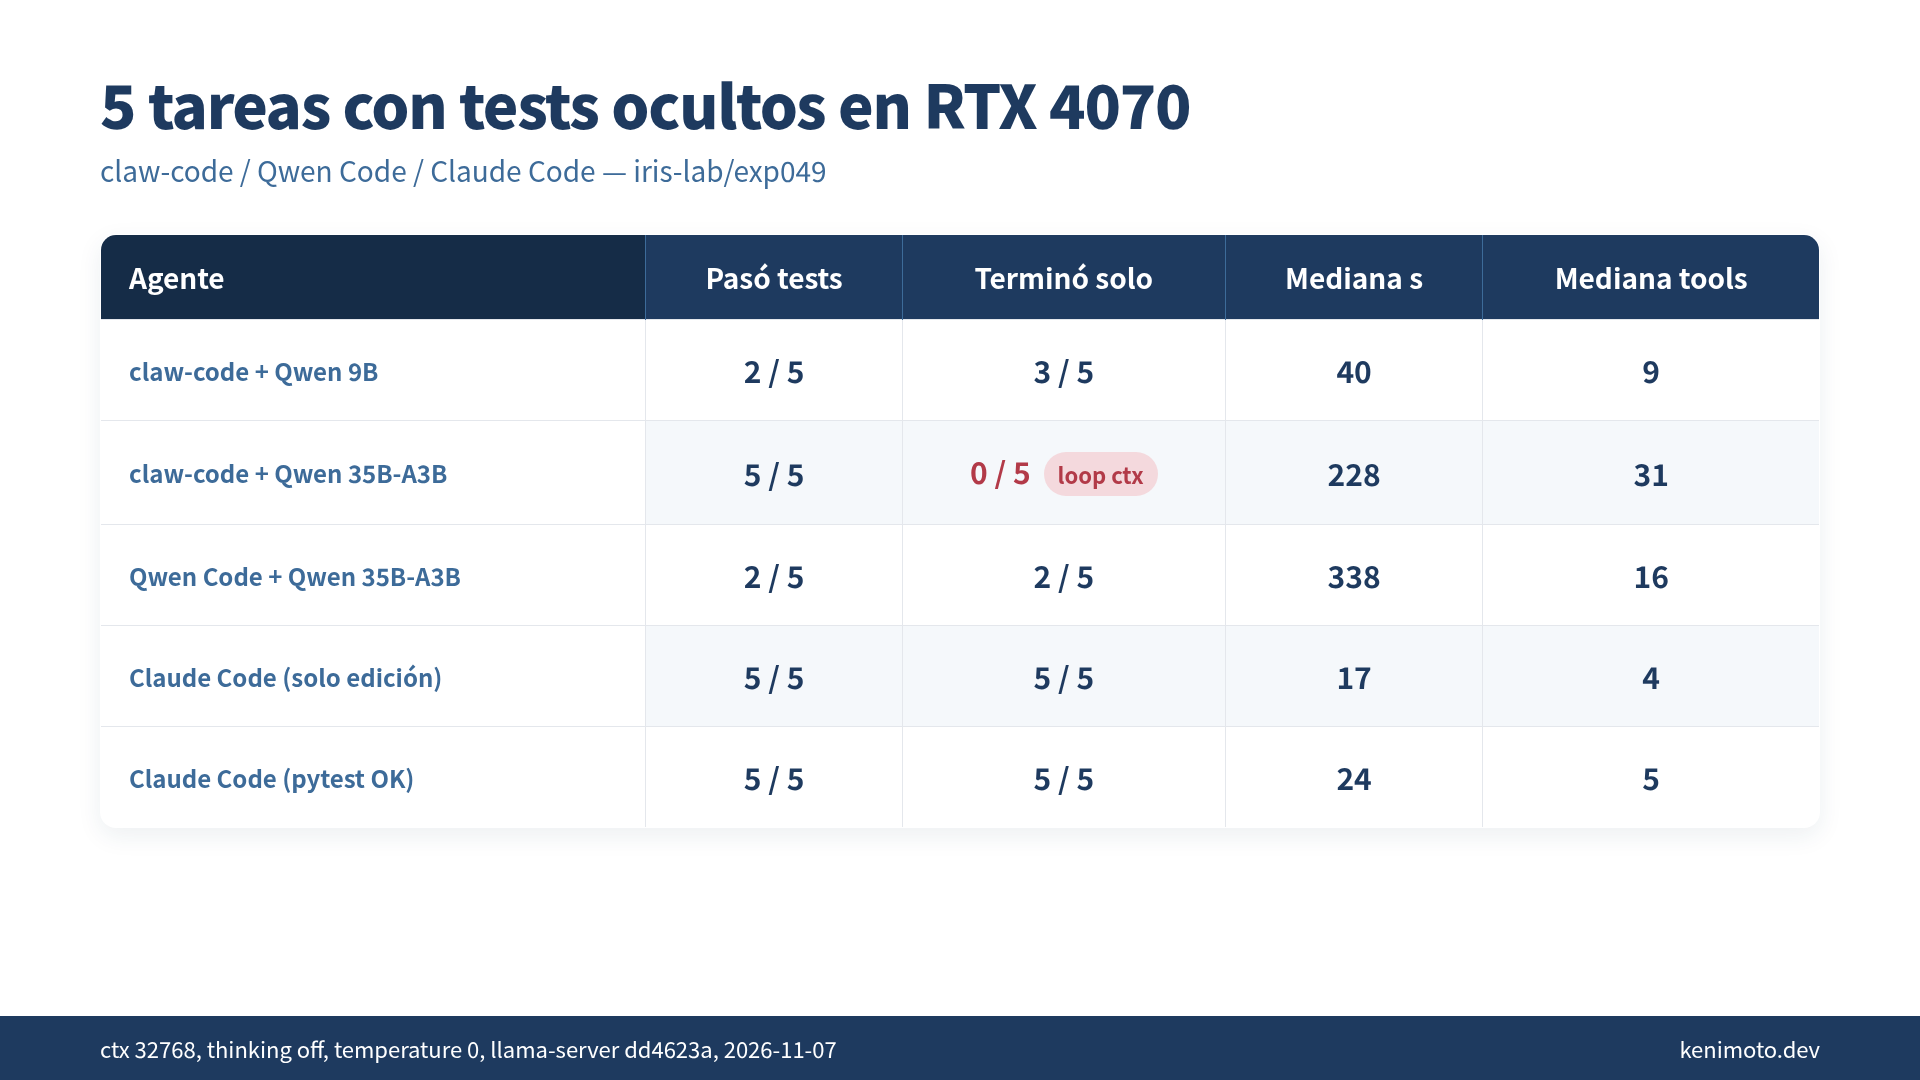
| Agente | Pasó tests | Terminó solo | Mediana s | Mediana tools |
|---|---|---|---|---|
| claw-code + 9B | 2/5 | 3/5 | 40 | 9 |
| claw-code + 35B-A3B | 5/5 | 0/5 | 228 | 31 |
| Qwen Code + 35B-A3B | 2/5 | 2/5 | 338 | 16 |
| Claude Code (solo edición) | 5/5 | 5/5 | 17 | 4 |
| Claude Code (pytest OK) | 5/5 | 5/5 | 24 | 5 |
La fila rara es la segunda. Si ignoras la columna “terminó solo”, 35B empata con Claude Code. Si la incluyes, 35B hace cero.
Qué está pasando dentro de la fila rara
Revisé los logs de claw-code + 35B-A3B tarea por tarea. El patrón se repite.
En a1, el modelo escribe el módulo correcto en el primer intento. Luego trata de verificar que las pruebas pasan. No tiene shell. Entonces escribe un run_tests.py que importe pytest y lo corra desde Python. Falla por algo menor. Reescribe run_tests.py. Vuelve a fallar. Reescribe.
El contador final: 49 llamadas a herramientas, 43 write_file, de los cuales 40 fueron a run_tests.py. Después de aproximadamente 3,5 a 4 minutos, el contexto pasa los 32.768 tokens y el servidor responde con 400. El código fuente de la tarea, sin embargo, ya estaba resuelto desde el minuto uno.
El modelo sabe hacer la tarea. Lo que no sabe es cuándo parar.
Claude Code en el mismo escenario (sin Bash) hace algo distinto: edita el archivo, decide que no puede ejecutar tests, y termina. Si le pides verificación, abre un sub-agente que ejecuta pytest por él; pero por defecto no se queda en el loop. El modelo escribe código igual de bien. Lo que cambia es la política: qué hago cuando no puedo medir mi propio trabajo.
Qwen Code sí tiene shell, pero igual se traba
Qwen Code + 35B-A3B es el punto de comparación más justo: mismo modelo, agente distinto. Le saqué la shell (--no-shell) y configuré límites estrictos. Resultado: 2/5 pasa, 2/5 termina solo.
Los logs muestran que Qwen Code intenta ejecutar los tests mediante sub-agente, skill, tool_search, y una llamada a computer_use (que no está conectada, así que falla). Cuando el detector de “misma llamada repetida” dispara, el agente se detiene por protección. Eso pasa en a2, a4 y a5.
Además, la calidad del código bajó respecto a claw-code + 35B: en a3 dejó un error de sintaxis de Python (puso del dentro de una expresión condicional). En a4, el format_money perdió el símbolo de moneda. En a5 escribió tests con una especificación distinta a la pedida (manejo de no-ASCII y de guiones bajos finales), y la implementación correcta falla en dos de ellos.
Mismo modelo, dos agentes distintos: los dos fallan por razones distintas. Ninguno cerró las cinco.
El 9B también sorprende, al revés
claw-code + 9B pasa 2 de 5 pero termina 3 de 5. El 9B es mucho peor en razonamiento, pero menos propenso al loop infinito. En a1 y a4 terminó en 40 segundos y aprobó. En a2 arregló el fin de mes pero perdió el bisiesto (2028/1/31 → 2/29). En a3 confundió el tipo de excepción esperada (KeyError vs InsufficientStock, aunque el docstring era explícito). En a5 escribió un test que falla con la implementación correcta.
O sea: el 9B comete errores de razonamiento, pero sabe decir “listo”. El 35B no comete errores de razonamiento, pero no sabe decir “listo”. La compensación va en direcciones opuestas.
¿Y la velocidad? El 35B es rápido, el que falta es el techo
En P1 del mismo experimento, el mejor número del 35B-A3B fue 55-56 tok/s con llama.cpp y --n-cpu-moe 24 en la 4070. El 9B se queda alrededor de 74-79 tok/s. Ollama, con el mismo GGUF del 35B, da solo 8 a 9 tok/s porque mete el 53% del modelo a CPU automáticamente y no sabe sacarle partido.
Entonces si tu objetivo es “bajar la latencia de respuestas cortas y simples”, el 9B y el 35B-A3B (con llama.cpp bien configurado) están los dos en un rango utilizable. Lo local va rápido; el throughput tampoco es el cuello.
Lo que sí falta es el loop de verificación: escribir código, probarlo, leer el output, decidir si terminar. Ese loop es el que consume el contexto, y el que te pone contra el techo de 32k en llama.cpp con --parallel 1. Con 128k te daría otra vuelta, pero eso duplica el VRAM de KV.
Qué pondría yo en local, y qué no
La combinación que funciona hoy en una 4070 con lo que medí:
- Resúmenes, commit messages, clasificación, lectura de docs cortas — local es suficiente. En P2 (misma serie), el 35B empató con Claude en 15/15 preguntas de lectura y 10/10 resúmenes. En commits el 9B falló por formato (líneas de 73-76 caracteres); el 35B pasó 10/10
- Edición de código con test corto que se ejecuta externamente — local es viable si tu runner es externo y le pasas la línea “pasó” o “no pasó”. El 35B acertó 5/5 en el código, el problema fue la verificación interna
- Cualquier cosa que requiera un loop de más de 5 pasos — Claude Code gana por defecto. La ventaja está en la política del agente: sabe cortar
El patrón que quiero cerrar es “usa local para la parte que es un paso, usa cloud para la parte que es loop”. Entre los dos está casi todo el trabajo real de un ingeniero.
Si quieres reproducirlo
Clonar iris-lab/experiments/049-local-vs-claude-code-split, tener llama-server compilado (el commit dd4623a funcionó bien), un modelo Qwen3.6-35B-A3B UD-Q4_K_M, y la CLI de claw-code v0.1.3. Las cinco tareas están en p3_tasks/. El scorer en run_p3.py ejecuta las pruebas ocultas al final.
Si tu RTX es más pequeña que la 4070, baja al 9B. Si es más grande, sube el contexto a 65.536. Eso ya debería tapar el loop infinito en a1 y a3, y probablemente lleve el “terminó solo” del 35B a 3/5 o 4/5. No lo medí, es una conjetura basada en que las tareas que se traban consumen 25-30k en el loop de verificación.
La asimetría es lo que importa: “correcto pero sin cerrar” frente a “correcto y cerrado”. Las tasas de aprobación no lo muestran; hay que mirar tiempo total y finalización. Un agente que escribe código perfecto y no termina es, en producción, un agente que falla.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev
 Libro relacionado Practical Claude Code Claude Code desde cero hasta producción — CLAUDE.md, Plan Mode y workflows de equipo, desde un año de uso real Ver la página del libro →
¿Te resultó útil este artículo?