Qwen 9b en RTX 4070: 187W y 0.7Wh por 1k tokens
Cuando un modelo se llama “9B” uno se imagina algo liviano. Qwen 3.5 en 9 mil millones de parámetros cabe en 12 GB de VRAM, responde a 70 tokens por segundo en una RTX 4070 y, al verlo en el terminal, parece que apenas despierta el GPU.
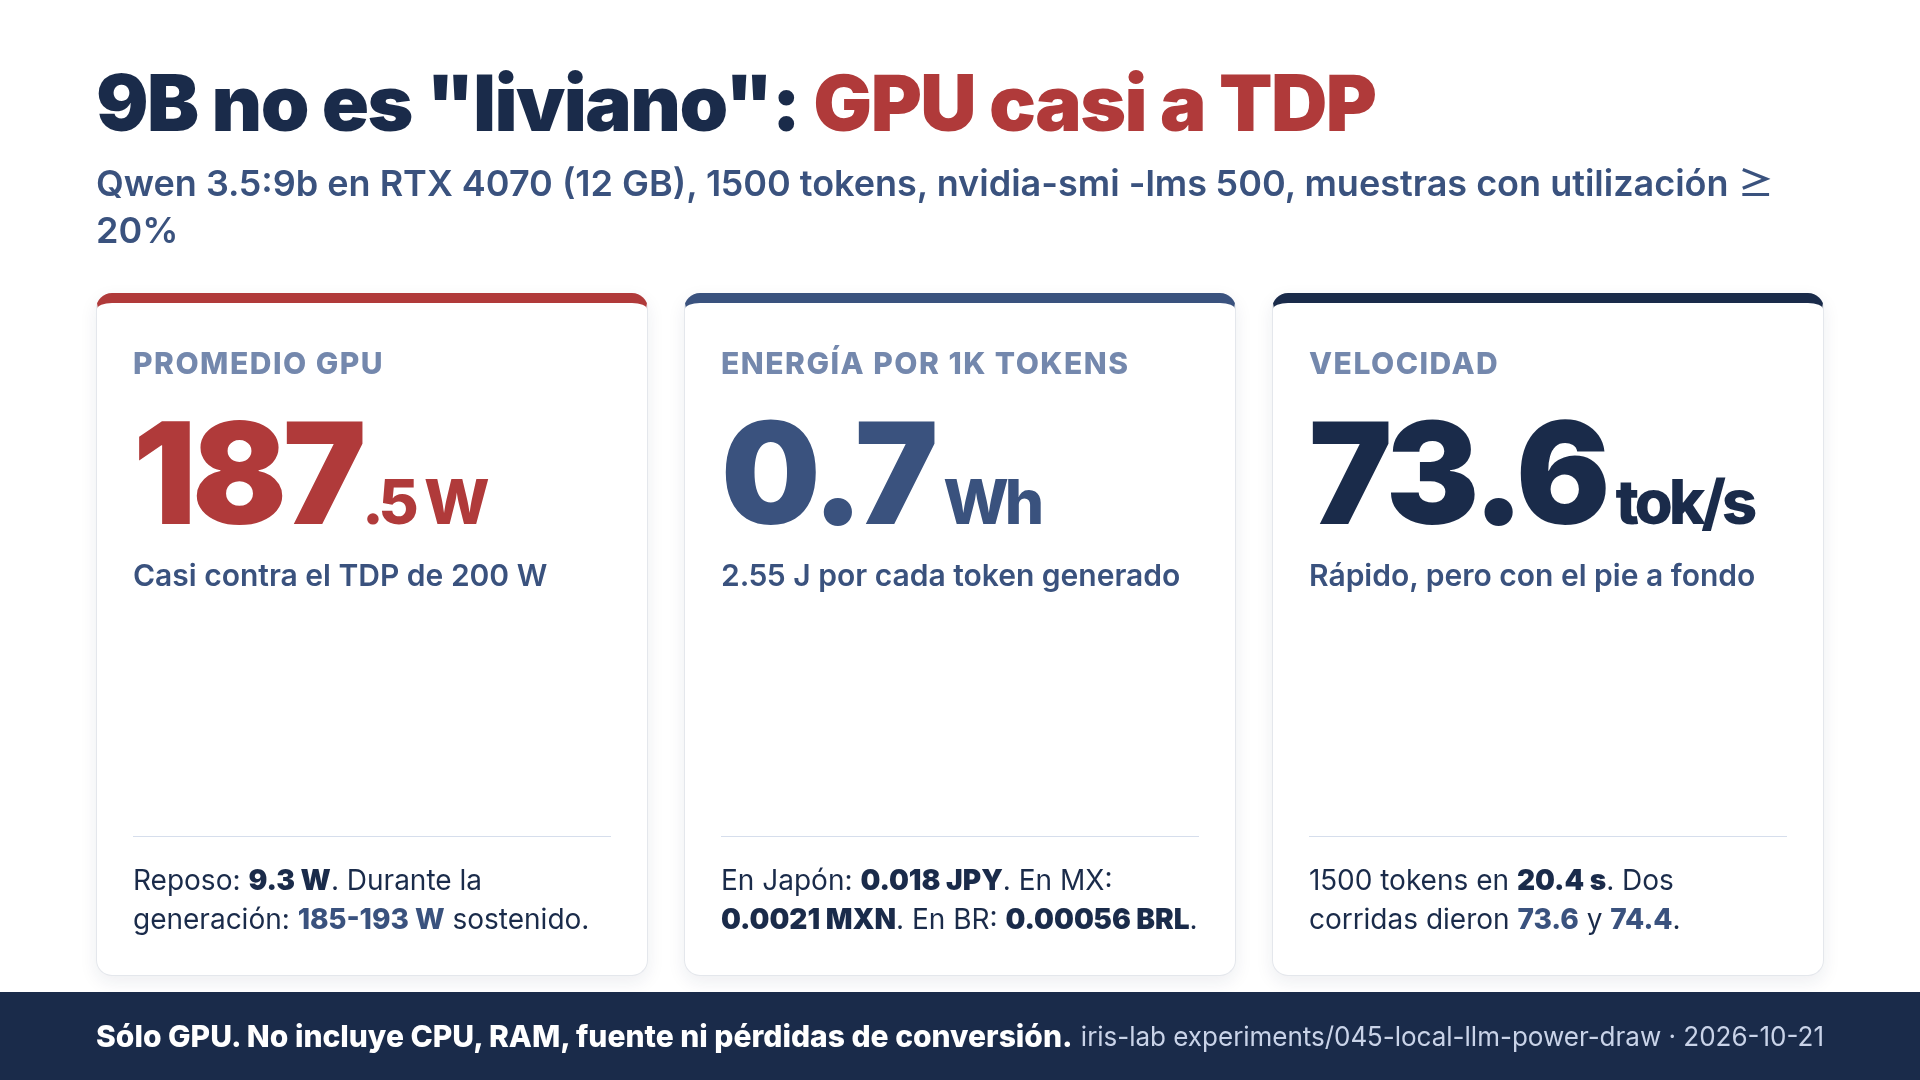
No es así. Lo medí el 21 de octubre con nvidia-smi cada 500 ms, y el GPU se va a 187.5 W de promedio mientras genera — básicamente contra el TDP (200 W). Genera rápido, sí, pero con el pie a fondo.
El experimento, en una pantalla
El montaje no tiene nada especial, y esa es un poco la gracia. Lo que quería saber es cuántos watts realmente consume una computadora casera generando texto con un modelo local, no el valor idealizado de un spec sheet.
- Hardware: RTX 4070 12 GB (consumo en reposo del GPU: 9.3 W).
- Runtime: Ollama con
temperature: 0,think: off. - Prompt: una generación larga y controlada de 1500 tokens.
- Medición:
nvidia-smi -lms 500corriendo en paralelo, promediando sólo las muestras conutilization >= 20%(para no mezclar el consumo del GPU inactivo con el de la generación). - Qué incluye y qué no: estos watts son del GPU únicamente, no del enchufe. No incluyen CPU, RAM, fuente ni pérdidas de conversión. El número de la toma es más alto; probablemente 30-50 W más, dependiendo de tu PC.
Hay dos razones para medir sólo el GPU: nvidia-smi es confiable muestra a muestra, y el GPU es casi siempre el que domina la factura cuando corres LLM local.
Resultados
Dos ejecuciones del mismo modelo, mismo prompt, mismo tamaño de salida. La diferencia entre ellas es ruido térmico (una se hizo con el ventilador ya caliente, la otra en frío).
| Modelo | tok/s | Promedio GPU | J/token | Wh por 1k tokens |
|---|---|---|---|---|
| qwen3.5:9b (run 1) | 73.6 | 187.5 W | 2.55 | 0.708 |
| qwen3.5:9b (run 2) | 74.4 | 183.0 W | 2.46 | 0.683 |
| qwen3.5:35b-a3b | 10.2 | 21.6 W | — | dato inválido |
El 35B-A3B es la fila interesante por lo que no dice. En 12 GB de VRAM no entra; Ollama lo pone en CPU con offload parcial. El GPU queda esperando (21.6 W), y casi todo el trabajo lo hace el CPU. Si sólo miras nvidia-smi en esa configuración concluyes que el 35B es “super eficiente” — y estarías leyendo el instrumento equivocado. Para medir ese caso necesitas un medidor en la toma, no un monitor de GPU.
El número que vale la pena memorizar está en la columna de la derecha: 0.7 Wh por cada 1000 tokens generados. Es específico de este modelo en esta tarjeta; no lo generalices a otro tamaño ni a otro GPU.
Qué significa 0.7 Wh en pesos, reales y yenes
Aquí es donde cambia por país, porque la tarifa eléctrica varía mucho. Te doy tres referencias comunes en 2026, pero toma la tuya del recibo — en LatAm sube bastante entre horario base y horario pico.
| Lugar | Tarifa (aprox.) | Costo por 1k tokens | 1 USD te compra… |
|---|---|---|---|
| Japón (donde lo medí) | 26 JPY / kWh | 0.018 JPY | ~8.3 millones de tokens |
| México (CFE Tarifa 1, tramo excedente) | 3.0 MXN / kWh | 0.0021 MXN | ~8.0 millones de tokens |
| Brasil (media residencial) | 0.8 BRL / kWh | 0.00056 BRL | ~9.0 millones de tokens |
El orden de magnitud es el mismo en los tres: entre 8 y 9 millones de tokens generados por cada dólar de electricidad. No es “gratis”, pero sí es despreciable comparado con cualquier plan de API.
El punto incómodo: esto cuenta sólo la energía marginal de cada generación. El GPU costó al comprarlo, y la amortización pesa más que la electricidad para la mayoría de los casos de uso personal. Si generas 10 mil tokens al día — típico de alguien que experimenta en un proyecto personal — vas a tardar años en que la factura eléctrica sea siquiera comparable al precio de la tarjeta.
Qué compara (y qué no compara) con Claude Haiku o GPT-4o-mini
Me resisto a soltar el típico “¡1/10000 del costo!” porque la comparación no es justa en una sola dimensión. Hay tres cosas distintas sobre la mesa:
- Costo marginal por token. El 9B local gana por un margen amplio una vez que tienes el GPU. Un tren de 100 mil tokens al día cuesta más o menos lo que te cuesta tener la luz prendida.
- Costo de capital. La RTX 4070 son unos 12 000 MXN / 7 500 BRL / 90 mil JPY (nueva, finales de 2026). Esa diferencia tarda meses en pagarse si el tráfico es bajo.
- Calidad por token. Un 9B y un modelo frontera no están en la misma liga para tareas complejas. El costo bajo no sirve de nada si el modelo no cierra la tarea.
Lo que me llevé de este experimento es que los supuestos sobre consumo son peores que los supuestos sobre dinero. Yo esperaba ver el GPU en 40 W tranquilos durante la generación. Verlo clavado en 185+ W toda la corrida me cambia dos cosas: la planificación térmica (no puedes dejar un LLM generando 20 minutos en una laptop con fan curve lento sin pensarlo), y la intuición de “liviano” asociada a modelos pequeños.
Lo que me gustaría medir después
Hay preguntas abiertas que esta corrida no toca y que podrían cambiar la lectura si alguien las mide:
- Watts en el enchufe, no sólo en el GPU. Con un medidor Kill-A-Watt en la toma, el número real crece 30-50 W por CPU + fuente + pantalla. El
Wh por 1k tokenssube a algo entre 0.9 y 1.2. - Modelos cuantizados a 4-bit (
qwen2.5:7b-q4). Más tokens por segundo, menos trabajo por token — pero el GPU podría quedar en el mismo TDP, lo cual bajaría los J/token proporcionalmente a la velocidad. Habría que medir. - Carga concurrente. Dos requests en paralelo con
OLLAMA_NUM_PARALLEL=2. ¿Suma watts linealmente o se saturan y el throughput por token baja?
Si corres alguna de esas y publicas los números, mándame el enlace — comparar tres GPU distintas corriendo el mismo prompt es más útil que publicar la misma ejecución varias veces.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev
 Libro relacionado Convirtiendo LLMs de Mentirosos en Expertos Ingeniería de Contexto desde cero — RAG, MCP, CLAUDE.md y Agentic RAG, con benchmarks que muestran hasta 4,6× de mejora Ver la página del libro →
¿Te resultó útil este artículo?