Qwen 35B empató con Claude Code en 3 de 5 tareas
Antes de decidir qué modelo pagar, conviene saber qué tareas realmente necesitan un modelo caro y cuáles se resuelven con uno local. Yo arrastraba la suposición de que Claude Code era el valor por defecto. Esa suposición me costaba créditos de API todos los días.
Entonces armé una matriz chica: cinco tipos de tarea, tres modelos, la misma rúbrica. La idea no era elegir un ganador global. Era saber, tarea por tarea, cuándo paga Claude y cuándo no.
La configuración
Los tres modelos bajo la misma regla:
- Qwen3.5-9B — Ollama Q4_K_M, entra entero en una RTX 4070 de 12 GB
- Qwen3.6-35B-A3B — llama.cpp UD-Q4_K_M, MoE con 3B activos. Vive en la misma RTX 4070 con CPU offload (
--n-cpu-moe 24) - Claude Sonnet 5 — API, thinking desactivado
Los dos Qwen corren en mi autocrew-pc detrás de Tailscale (mi laboratorio está en Japón, pero esto es independiente de tu geografía: el mismo esquema funciona desde cualquier equipo con Docker y una GPU de 12 GB). Los precios de API que menciono están en USD directo, sin convertir a moneda local; el ejercicio es decidir dónde vale la pena gastar en USD.
Context 32768, thinking apagado, temperatura 0. Rúbrica y corrector automáticos: no soy yo poniendo nota. Todo el código y los datos están en iris-lab/experiments/049-local-vs-claude-code-split.
Los cinco tipos de tarea
Tomé lo que realmente hago en un día de trabajo y lo partí en cinco grupos. La lógica de la partición: cada grupo tiene una rúbrica binaria (pasa / no pasa), para poder sumar con honestidad.
- Investigación (WebFetch) — la página ya está descargada; el modelo tiene que extraer número, fecha o nombre propio correcto. 15 casos.
- Resumen — artículo real de Wikipedia, resumir cubriendo los hechos esenciales sin inventar cifras. 10 casos, 5 en inglés y 5 en japonés.
- Mensaje de commit — dado el diff, escribir asunto en máximo 72 caracteres + línea en blanco + cuerpo que mencione archivo o identificador tocado. 10 casos.
- Clasificación — mirar un pedido y asignarlo a una de 9 etiquetas (extract, summarize, code, write, check, agent, question, classify, research). 12 casos.
- Arreglo de código — pytest escondido. Pasa o no pasa. 10 casos (3 fáciles, 4 medios, 3 difíciles).
La tabla
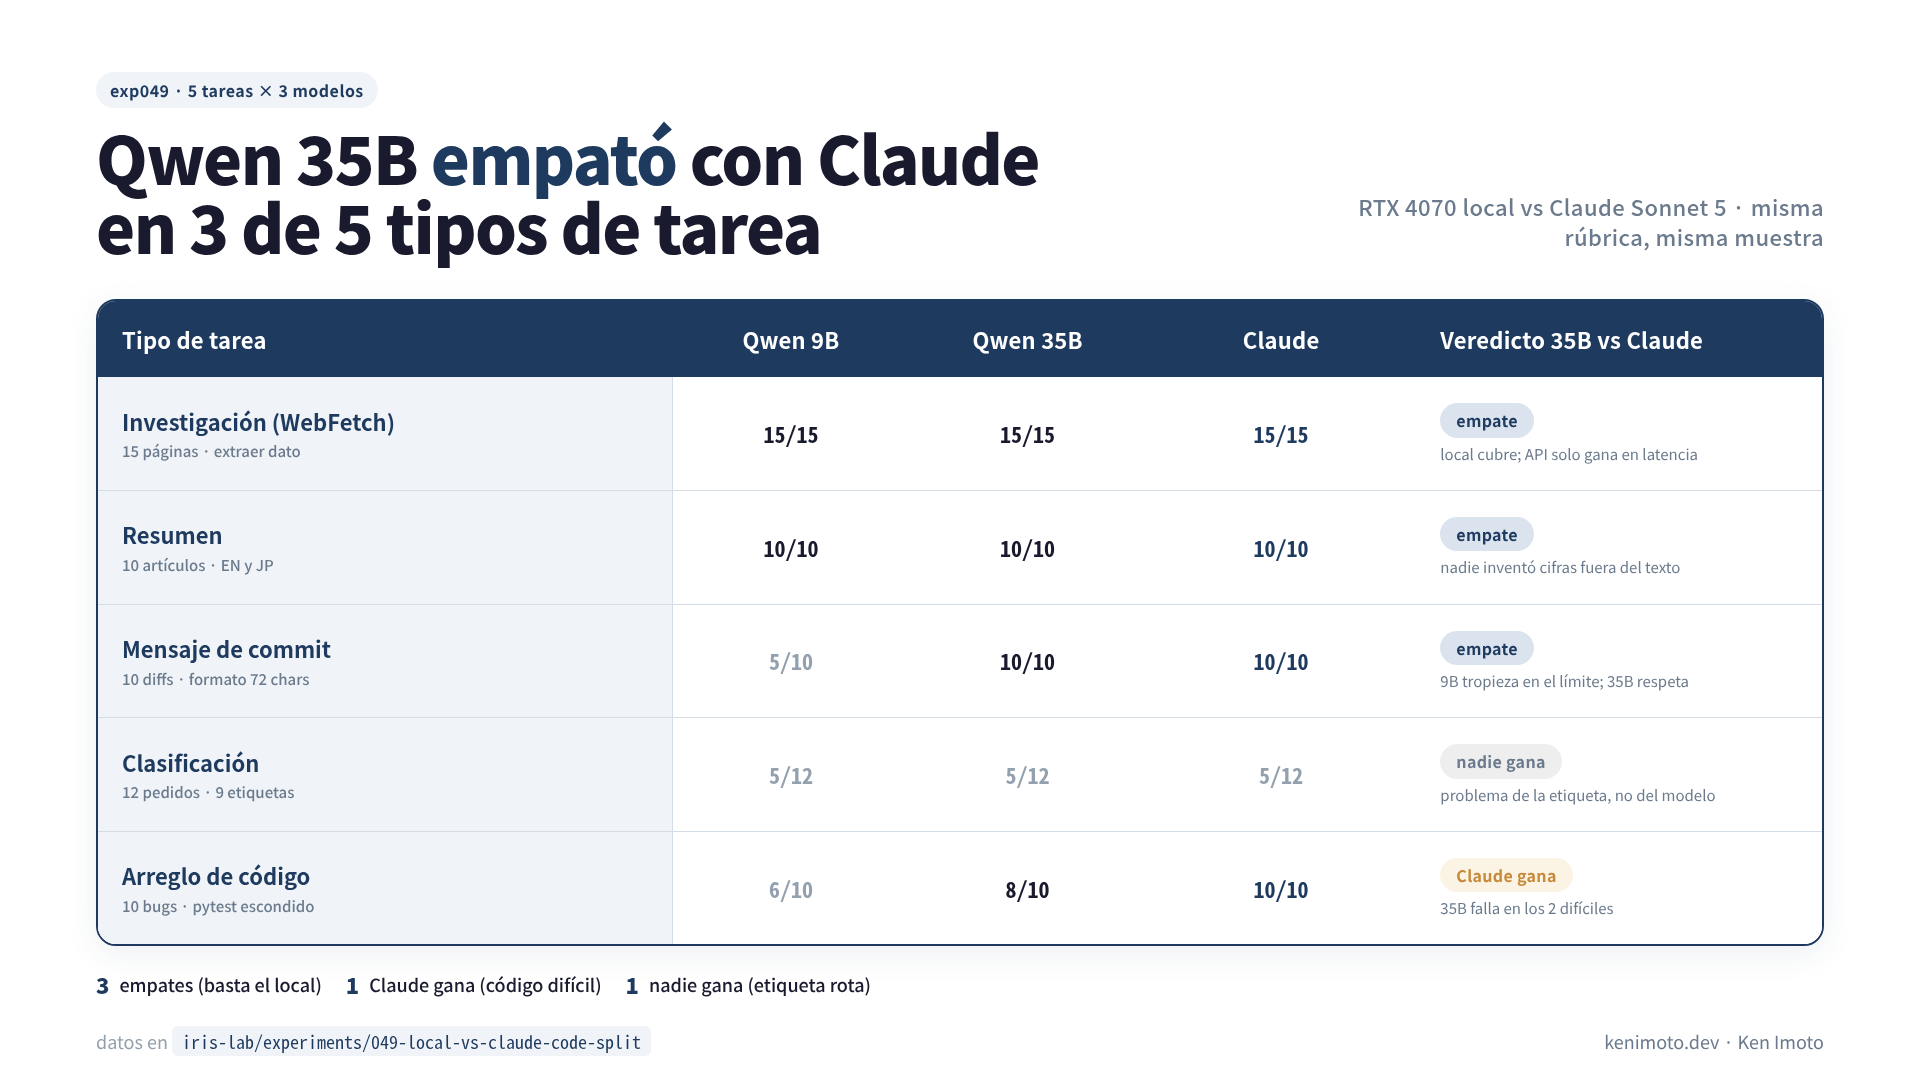
| Tipo | 9B | 35B | Claude |
|---|---|---|---|
| Investigación (WebFetch) | 15/15 | 15/15 | 15/15 |
| Resumen | 10/10 | 10/10 | 10/10 |
| Commit | 5/10 | 10/10 | 10/10 |
| Clasificación | 5/12 | 5/12 | 5/12 |
| Arreglo de código | 6/10 | 8/10 | 10/10 |
Tres renglones donde el 35B empató con Claude: investigación, resumen, commit. Un renglón donde los tres cayeron en el mismo pozo: clasificación. Un renglón donde Claude ganó: arreglo de código.
Dónde basta el modelo local (3 de 5)
Investigación: 15 de 15 para todos. El cuello de botella es leer la página bien, no el tamaño del modelo. El 35B tardó 8,3 s de mediana contra 1,4 s de Claude, porque mi --n-cpu-moe 24 paga peaje cuando el input tiene entre 5 y 8 mil tokens. En calidad: cero diferencia. Si tu pipeline extrae datos de HTML ya descargado, no hay razón económica para gastar cuota de API acá.
Resumen: 10 de 10 para todos. El 9B quedó en 0,83 de cobertura media de hechos esenciales, el 35B en 0,97 y Claude en 0,95. Todos por encima de la línea de 4-sobre-6 que era el criterio. Lo importante: ninguno de los tres inventó una cifra que no estuviera en el texto. Esa era la parte que me daba miedo del 9B, y se portó.
Commit: 10 de 10 para el 35B, empatando con Claude. El 9B perdió 5 casos puramente de formato: asunto de 73 a 76 caracteres en 4 casos, línea en blanco faltante en 1. El contenido estaba bien. El 35B llegó a los 72 caracteres sin gritar y Claude también. Si automatizas mensajes de commit en un hook, la diferencia no está entre modelo grande o chico. Está entre un modelo que respeta el formato y uno que tropieza en el límite.
Ya se puede dividir: las tres tareas donde el Qwen 35B empató representan la mayor parte de lo que pido en un día de desarrollo. Si enruto esas tres al local, la cuenta de API baja sin perder resultado.
Dónde gana Claude (1 de 5)
Arreglo de código: 10 de 10 para Claude. El 35B agarró 8 de 10, el 9B agarró 6 de 10. La diferencia aparece en el nivel difícil: 9B quedó en 0/3, 35B pasó 1 de 3, Claude 3 de 3. De los dos casos que el 35B falló: en uno gastó los 4096 tokens de salida explicando el problema antes de escribir código; en otro, arregló la mitad de lo que la spec pedía.
Esto es consistente con la filosofía de “modelo pequeño + buen contexto” que el libro trata en el capítulo 13: un Qwen bien contextualizado le gana a muchas cosas, pero en el extremo difícil todavía hay una diferencia de capacidad bruta que RAG no repone. Ese extremo es donde tiene sentido pagar Claude.
Dónde el tamaño del modelo no cambió nada (1 de 5)
Clasificación: 5 de 12 para todos. Los tres modelos acertaron 5 y fallaron 7, y en 4 de los 7 errores los tres votaron la misma cosa equivocada (write → code dos veces, summarize → code, classify → agent). Cuando los tres convergen en el mismo error, el problema deja de ser el modelo y pasa a ser la etiqueta.
Esa conclusión la saqué del cuaderno: ampliar el modelo no iba a resolver nada. Lo que hay que hacer es mejorar la definición de las 9 etiquetas o aceptar una tasa de error estructural. Gastar Claude acá es tirar dinero.
Cuando el 35B cuesta mucho tiempo
Honestidad: el 35B no es gratis en latencia. En WebFetch tarda una mediana de 8,3 s con entrada larga, mientras Claude termina en 1,4 s. Si tu loop es una persona esperando la respuesta, Claude todavía gana en percepción. Si tu loop es batch (generador de commits nocturno, resumen de changelog por la mañana), 8 s es invisible.
El 9B compensa en latencia (2,1 s en WebFetch) y consume menos energía, pero pierde formato en el commit y pierde calidad en el código. Es la opción correcta para un hook muy frecuente donde el formato no importa y la opción equivocada para todo lo que termina en el repositorio.
Matriz de decisión para tu pipeline
Si quieres replicar el ejercicio sin montar un cluster, la pregunta ordenada es así:
- ¿La tarea tiene una rúbrica binaria (pasa/no pasa)? Si no la tienes, no vas a poder decidir con datos. Ármala primero.
- ¿La salida tiene formato estricto (72 caracteres, JSON, patrón)? Entonces un modelo chico probablemente falla por forma. Sube al 35B o paga Claude.
- ¿La tarea requiere razonamiento multi-paso difícil (pytest con 3+ invariantes)? Claude gana con margen, los Qwen quedan cortos.
- ¿Los tres modelos fallan juntos en el mismo set? No es un problema de modelo; es un problema de datos o etiquetas. Pagar Claude no te va a salvar.
- ¿Es extracción, resumen o commit simple? El local alcanza. Agenda la migración.
El resultado práctico no es “reemplazar Claude por local”. Es enrutar 3 de 5 al local y dejarle a Claude lo que Claude hace mejor.
La idea de fondo, que un modelo pequeño con el contexto correcto le gana a un modelo grande solo, es lo que me hizo abrir esta planilla en lugar de asumir que Claude era la opción por defecto. Es la tesis central del libro que estoy escribiendo sobre ingeniería de contexto; el capítulo 13 habla exactamente de eso.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev
 Libro relacionado Convirtiendo LLMs de Mentirosos en Expertos Ingeniería de Contexto desde cero — RAG, MCP, CLAUDE.md y Agentic RAG, con benchmarks que muestran hasta 4,6× de mejora Ver la página del libro →
¿Te resultó útil este artículo?