RTX 4070 con 35B-A3B: 21.6W es mentira (MoE offload)
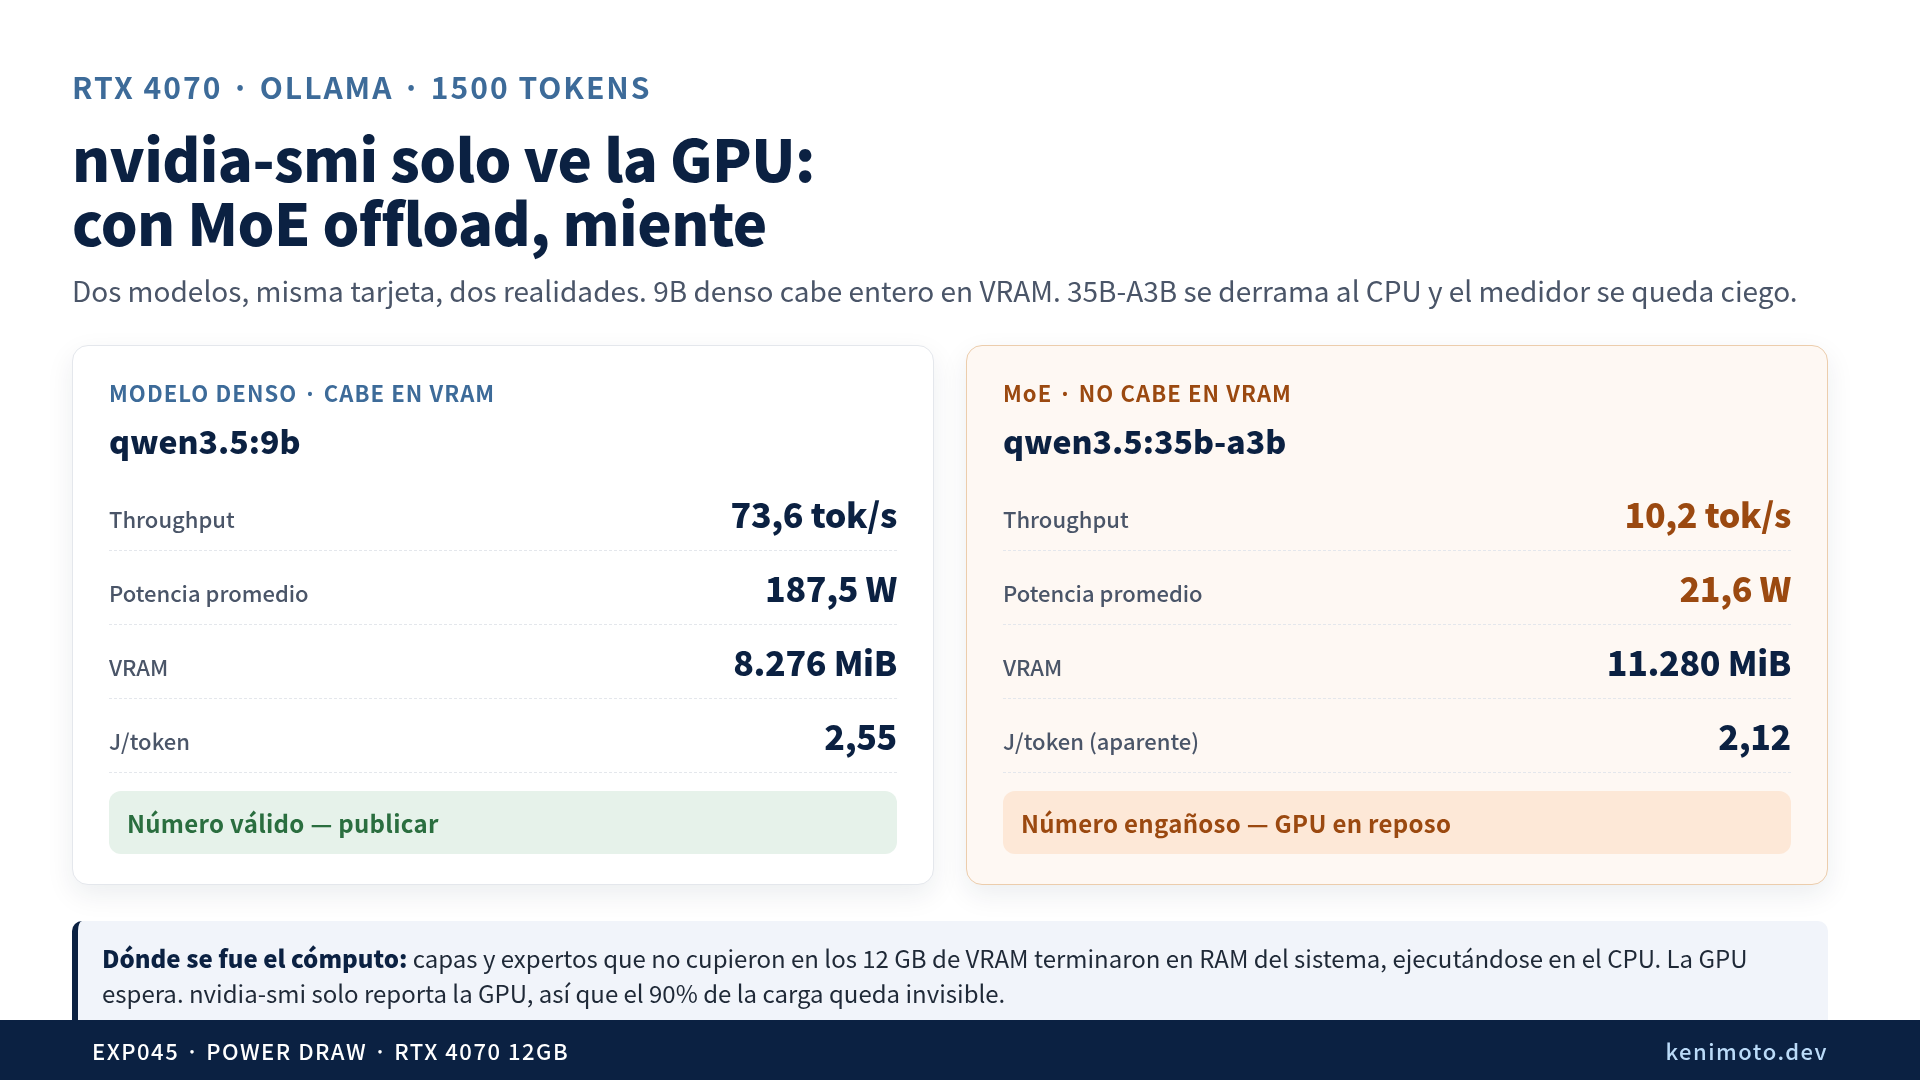
Medí Qwen3.5-35B-A3B en una RTX 4070 con nvidia-smi y el promedio durante la generación salió en 21.6 W. En la misma tarjeta, el modelo 9B dense marca 187.5 W. A primera vista parece una victoria enorme de eficiencia del modelo MoE.
No es una victoria. nvidia-smi no estaba midiendo lo que yo creía que estaba midiendo.
El experimento
El montaje del 21 de octubre es idéntico al que usé para el artículo del 9B. Sólo cambia el modelo.
- Hardware: RTX 4070 12 GB, Salad parado, el GPU en reposo marca 9.3 W.
- Runtime: Ollama con
temperature: 0,think: off. - Prompt: una generación controlada de 1500 tokens.
- Medición:
nvidia-smi -lms 500en paralelo, promediando sólo muestras con utilización ≥ 20%.
Dos modelos, misma tarjeta, mismo prompt, mismo tamaño de salida. Los números crudos:
| Modelo | VRAM usada | tok/s | Promedio GPU | J/token |
|---|---|---|---|---|
| qwen3.5:9b (dense) | 8 276 MiB | 73.6 | 187.5 W | 2.55 |
| qwen3.5:35b-a3b (MoE) | 11 280 MiB | 10.2 | 21.6 W | aparente |
El 9B es el caso bonito: cabe entero en los 12 GB de VRAM, la GPU está trabajando, y la potencia reportada corresponde al cálculo real. En ese caso nvidia-smi es confiable para el GPU y domina el consumo total del sistema (más abajo en el artículo hablo de qué queda fuera).
El 35B-A3B es el caso raro. Caben 11.3 GB en VRAM — casi el techo de la tarjeta — y el throughput cae 7.2×. Pero la potencia del GPU también cae 8.7×. Mirando sólo esa tabla, uno se pregunta: ¿me acabo de ganar un modelo 35B que corre al 11% del consumo eléctrico del 9B?
Si publico esa gráfica sin pensar, me invento un modelo mágico que nadie más puede reproducir.
Los 21.6 W son reales. La lectura es engañosa.
El instrumento no miente. La GPU sí consumió 21.6 W de promedio durante la generación — ese número está en el CSV, muestra por muestra, 287 muestras válidas de 307.
El problema es que la GPU estuvo esperando gran parte del tiempo, no trabajando.
Qwen3.5-35B-A3B pesa aproximadamente 22 GB cuantizado a Q4. No cabe entero en los 12 GB de la RTX 4070. Lo que hace Ollama cuando faltan capas es offload parcial: parte de los pesos vive en la RAM del sistema, el CPU hace la aritmética de esas capas, y el resultado se junta con lo que sí corre en GPU.
Durante esa parte del cálculo, la GPU está idle. nvidia-smi la ve consumiendo cerca del reposo. El modelo sigue generando tokens, pero el trabajo pesado está sucediendo en otro chip al que nadie le apuntó un medidor.
El throughput confirma el diagnóstico: 10.2 tok/s en un sistema donde el 9B hace 73.6. La GPU no es más eficiente — está haciendo una fracción del trabajo. El resto lo arrastra el CPU, a su ritmo mucho más lento para operaciones matriciales densas.
Por qué el drop en vatios no es una buena noticia
Es útil ver los dos ratios juntos:
- Caída de potencia GPU: 21.6 / 187.5 = 11.5% del valor anterior.
- Caída de throughput: 10.2 / 73.6 = 13.9% del valor anterior.
Son casi iguales. La GPU consume una fracción similar a la del trabajo que todavía está haciendo. El resto del cálculo — lo que explica por qué aún se generan tokens — está pasando fuera del alcance de nvidia-smi.
Dicho de otra forma: si yo tapara la mitad de las capas y las pusiera a correr en el microondas, el GPU también marcaría menos. No sería eficiencia; sería que el microondas está haciendo algo que el instrumento no ve.
Lo que nvidia-smi sí mide y lo que no mide
Esta tabla no tiene nada controversial — es simplemente lo que la herramienta promete y lo que no promete. La controversia es que mucha gente la usa como si midiera el consumo total del equipo.
| Componente | ¿nvidia-smi lo mide? |
|---|---|
| Potencia de la GPU | sí (confiable) |
| Utilización de la GPU | sí |
| Memoria de la GPU | sí |
| Potencia del CPU | no |
| Potencia de la RAM del sistema | no |
| Consumo de la fuente (pérdida de conversión) | no |
| Potencia en la toma de corriente | no |
Cuando el modelo cabe entero en VRAM, la GPU domina el consumo total y la lectura de nvidia-smi es una aproximación razonable — el resto del sistema aporta algunos vatios adicionales, pero el orden de magnitud lo marca el GPU. En ese régimen, publicar “J por token” basado en nvidia-smi funciona para comparar modelos entre sí.
Cuando hay offload a CPU, esa aproximación se cae. El GPU deja de dominar; una parte significativa del cómputo sucede en otro chip con otro perfil energético. El número de nvidia-smi se vuelve una lectura parcial de un sistema que no es GPU-bound.
No es que nvidia-smi empiece a mentir — es que empieza a describir sólo un subcomponente del sistema que estás analizando. El instrumento no cambió. El sistema sí.
Cómo se mediría bien (y por qué no publico ese número hoy)
La única forma honesta de medir un setup con offload parcial es un medidor en la toma de corriente: Kill-A-Watt, enchufe inteligente con lectura de potencia, o cualquier medidor comercial en serie con el PC. Ese instrumento sí ve todo: GPU + CPU + RAM + fuente + pérdidas de conversión.
No lo tengo. Por eso este artículo no publica “vatios en la toma” para el 35B-A3B. En el artículo del 9B estimé que el enchufe suma 30-50 W adicionales al número de GPU, pero esa estimación asume un régimen GPU-bound — asumption que se cae precisamente en el caso que estoy describiendo aquí.
Hay una alternativa parcial para quien quiera aproximarse sin comprar hardware extra: sumar al dato de nvidia-smi la lectura del CPU vía RAPL (en procesadores Intel) o equivalentes en AMD. Cubre más del sistema que nvidia-smi solo, pero sigue sin incluir pérdidas de la fuente ni el resto de componentes. Es un paso adelante, no una medición completa.
El patrón que conviene memorizar
Cada vez que tu modelo no cabe entero en VRAM y hay offload a CPU, la lectura de nvidia-smi deja de corresponder al consumo total del sistema. Vas a ver un número engañosamente bajo durante la generación.
Los casos típicos donde esto pasa en 2026:
- MoE sparse con parámetros totales grandes en tarjetas consumer (A3B, A14B, A22B) cuando los pesos totales superan la VRAM disponible.
- Modelos densos grandes forzados con
--gpu-layersparcial oOLLAMA_NUM_GPUbajo para que quepan. - Setups con VRAM compartida CPU+GPU (iGPU, Apple Silicon unified memory), donde el concepto de “GPU power” no está bien definido.
La regla de bolsillo: si nvidia-smi marca menos del 60% del TDP de la tarjeta mientras el modelo sigue generando tokens activamente, asumí que hay offload y que el número no representa el consumo total del equipo.
La lección de medición
La trampa del 21.6 W no es que el instrumento esté roto. Es que yo le estaba haciendo una pregunta para la que no estaba diseñado.
Para modelos que caben enteros en VRAM, nvidia-smi es útil. Para medir el consumo total de un modelo con offload, hace falta otro instrumento — uno que vea el enchufe y no sólo el chip de la tarjeta gráfica. Ignorar esa diferencia es cómo se publican benchmarks ridículos.
La próxima iteración del experimento incluye un medidor de pared. Hasta entonces, soy un ingeniero con un termómetro apuntando al vaso de agua equivocado — y por lo menos lo reconozco antes de publicar la cifra.
Si corres MoE grandes en tu RTX 4070 y tenés un medidor en la toma, mándame los números: comparar dos setups reales vale mucho más que extrapolar desde nvidia-smi solo. Mientras tanto, los artículos de “energía por token” que publico aquí valen para el caso GPU-bound (densos 7-9B en 12 GB de VRAM), no para offload.
Para el contexto más amplio de cómo pensar la ingeniería de harnesses alrededor de modelos locales, está la guía de Harness Engineering en Kindle.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev
 Libro relacionado Convirtiendo LLMs de Mentirosos en Expertos Ingeniería de Contexto desde cero — RAG, MCP, CLAUDE.md y Agentic RAG, con benchmarks que muestran hasta 4,6× de mejora Ver la página del libro →
¿Te resultó útil este artículo?