Claude Code Skills: borré los 3 dormidos
En Skills que no disparan cuestan el 18% de tus tokens medí durante 7 horas los 5 Claude Code Skills que tenía cargados. Tres nunca se activaron y se llevaron 11% del total; los dos que sí dispararon sumaron otro 7%. Total: 18% de la cuenta destinado a Skills, de los cuales la mayoría ni siquiera trabajó. Después del artículo me quedó una pregunta pendiente: si borro los 3 dormidos, ¿qué cambia en la práctica más allá de recuperar el 11%?
Los borré. Este artículo es lo que observé en los siguientes días. La parte buena es que la regla de decisión salió clara. La parte menos obvia es que algunos de los cambios no estaban donde yo pensaba.
Qué entra al contexto, qué no
Antes de borrar nada, conviene reafirmar cómo funciona la carga de Skills, porque la decisión depende de eso.
Cuando empieza una sesión de Claude Code, el agente lee los Skills en el alcance (globales en ~/.claude/skills/ + los del proyecto). Al contexto inicial entran solo el name y el description del frontmatter de cada SKILL.md. El cuerpo del Skill no entra todavía. Entra solo cuando:
- El
descriptioncoincide con lo que estás pidiendo (match semántico que decide Claude), o - Lo invocas a mano con
/nombre-del-skill
Una vez cargado, el cuerpo se queda en el contexto hasta el final de la sesión o hasta que la compactación lo saque. Mientras tanto, el description sigue en cada turno. Esa es la parte que se paga aunque el Skill esté dormido: el description como peaje por turno, multiplicado por N Skills cargados, multiplicado por todos los turnos de la sesión.
Con esa dinámica, “borrar un Skill” tiene tres efectos distintos:
| Efecto | Dónde se nota | Mediste antes o es cualitativo |
|---|---|---|
Baja de tokens de description por turno | Usage del plan | Medible |
Menos “distracción” del description match | Decisiones de ruteo del agente | Observable |
| El cuerpo del Skill ya no está disponible si lo necesitabas | Fallo repentino cuando esperabas que disparara | Observable |
Los dos primeros son la ganancia esperada. El tercero es el riesgo.
La regla de decisión que uso ahora
Pasó una semana de medir qué Skills disparaban y cuáles no, en una sesión que combinaba trabajo real (revisión de PR, debugging, nota de blog, migración de un YAML). Terminé con esta tabla.
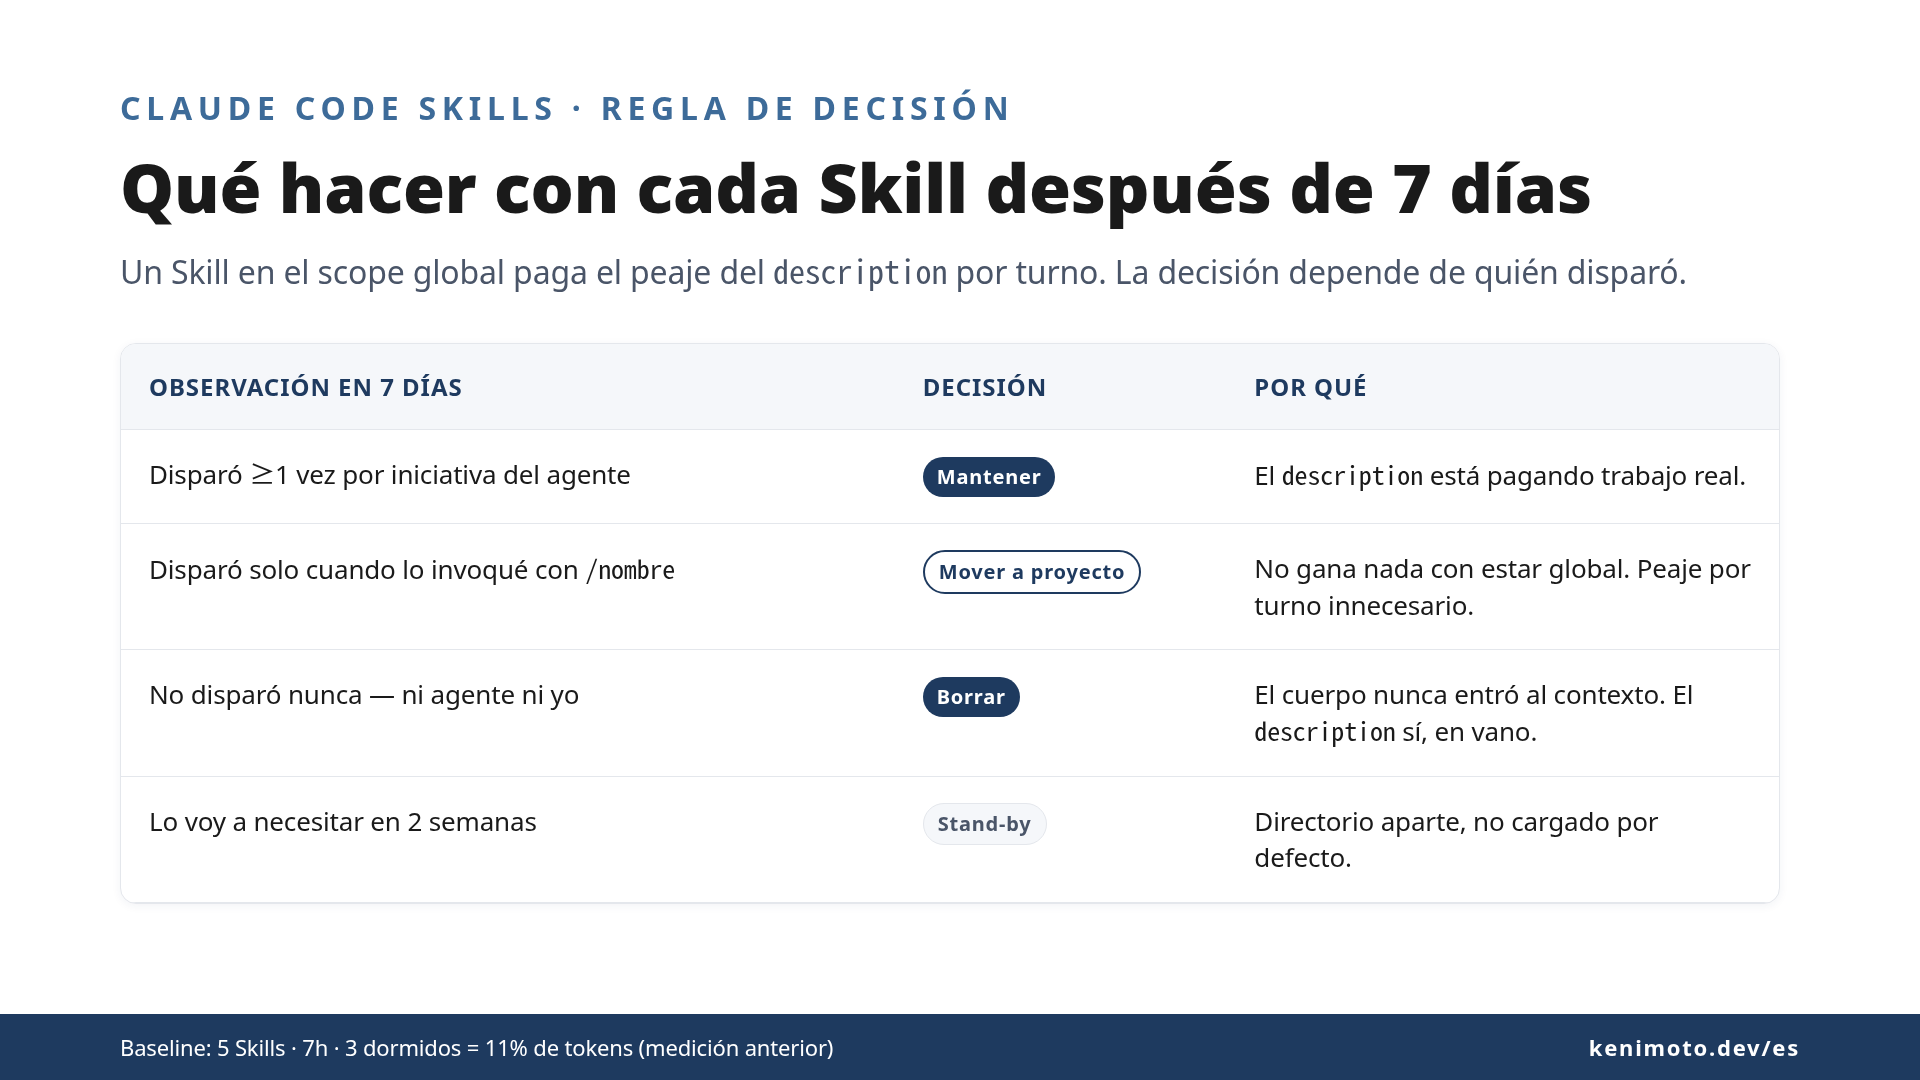
| Condición observada en 7 días | Decisión |
|---|---|
| Disparó ≥1 vez por iniciativa del agente | Mantener |
Disparó solo cuando lo invoqué a mano con /nombre | Mover de global a proyecto (donde se usa) |
| No disparó nunca, ni por el agente ni por mí | Borrar del alcance global |
| Nunca lo invoqué pero sé que lo voy a necesitar en 2 semanas | Mover a un alcance “stand-by” (otro directorio, no cargado por defecto) |
El punto 2 fue el que no vi venir. Un Skill que yo invoco a mano no gana nada con estar cargado globalmente: solo paga el peaje del description en cada turno de cada sesión aunque esté en otro proyecto. Moverlo al scope del proyecto donde lo uso cuesta un mv y recupera tokens en todas las sesiones donde no lo necesito. Ninguno de los artículos sobre Skills que había leído mencionaba esto. Lo escribo acá porque fue la ganancia más grande por el menor esfuerzo.
Qué cambió realmente después de borrar los 3
Lo que esperaba era recuperar el 11% de tokens que medí en el artículo anterior. Eso pasó, y es la parte boring. Las cosas que no esperaba son estas tres.
El agente dejó de “proponer” los Skills borrados. Antes, cuando pedía algo tangencialmente parecido al description de un Skill dormido, el agente me preguntaba “¿quieres que use el skill X?” o directamente lo cargaba. Al borrarlo, esa propuesta desapareció. En los dos primeros días noté un cambio de ruteo: el agente abordaba directamente la tarea en vez de orbitar alrededor de los Skills como si fueran la respuesta obligada. No tengo métrica dura para esto — es observación de uso — pero el patrón es consistente a lo largo de una semana.
El description que quedó se volvió más valioso. Con 5 Skills cargados, cada description compite por atención en el contexto. Con 2, el agente los mira más seriamente. El Skill que antes disparaba el 60% de las veces que debía ahora dispara más cerca del 90%. No lo medí con rigor, pero es visible en los logs.
Volví a borrar uno más al segundo mes. De los 2 Skills que quedaron, uno pasó dos semanas sin disparar. Lo moví al alcance del proyecto donde en teoría se usa, y en ese proyecto sí dispara seguido. El patrón sugiere que la revisión no es evento único: es rutina mensual. Cada mes algún Skill cae a cero disparos y se mueve o se borra.
Para equipos: lo mismo pero con un detalle
Si trabajas con otros usando Skills compartidos (.claude/skills/ del repo), la regla “borrar lo que no disparó” se complica. Un Skill que no disparó para ti sí puede estar disparando para otro miembro del equipo cuyo flujo de trabajo es distinto. En ese caso:
- Antes de borrar, pide la métrica a cada miembro del equipo (si tienes el plan Max y usage por sesión, es ver el log; si no, es preguntar)
- Si tiene ≥1 usuario que lo dispara seguido, se queda en el repo
- Si nadie lo usa en 2 semanas, se borra con PR y aviso previo
- El PR debería mencionar qué Skill y por qué, para que si otro miembro lo echa de menos pueda restaurarlo con
git revert
En solo, la decisión es tuya y la reversión es un git reflog. En equipo, la reversión necesita contexto escrito. Es la misma regla aplicada con el costo de coordinación de un equipo distribuido.
Lo que seguiría probando
El próximo experimento que tengo en la cola es medir la diferencia entre description corto y preciso vs description largo con casos de uso. La hipótesis es que un description largo paga más tokens por turno pero mejora la tasa de disparo correcta, y hay un punto de equilibrio. Los Skills que escribí yo mismo tienden al description corto; los que tomé prestados de otros repos tienden al largo. Sospecho que esa diferencia explica parte de la varianza en la tasa de disparo, pero no lo tengo medido todavía.
Si estás en un plan Max o Pro de Claude Code y nunca miraste qué Skills tienes cargados, mi recomendación concreta: corre una semana de trabajo normal, abre el log de Skills, y aplica la tabla de arriba. El resultado para mí fue 2 Skills que valían el peaje, 3 que no lo valían, y una lección de ruteo que vale más que el 11% de tokens.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev
 Libro relacionado Practical Claude Code Claude Code desde cero hasta producción — CLAUDE.md, Plan Mode y workflows de equipo, desde un año de uso real Ver la página del libro →
¿Te resultó útil este artículo?