AIエージェントのリトライが本番を落とす3つの罠
結論を先に書きます。リトライは単体では善でも悪でもなく、集団として破壊的になります。 1クライアントの「3回リトライ」は合理的でも、同じ判断を1,000クライアントが同時に取れば、依存先に通常の数千倍のスパイクが刺さります。AIエージェントの時代は、この集団行動の問題を前より踏みやすくなっています。公式SDKがデフォルトで静かにリトライするからです。
本記事は、Michael Nygardが Release It! (2007) で名前を付けた安定性アンチパターンを、2026年のAIエージェント運用の文脈に当てて3つの罠に整理します。そして、それぞれを止める保険の実装を1つずつ対応させます。
デフォルトが「静かにリトライする」時代
まず現状を確認しておきます。Anthropic公式SDKのエラーハンドリング仕様には、こう書かれています。
The official SDK automatically retries transient failures (such as connection errors, rate limits, and 5xx server errors) with exponential backoff, twice by default, honoring the
retry-afterheader when present.
接続エラー・429 rate limit・5xx を、デフォルトで2回、指数バックオフでリトライする。max_retries で変更も無効化も可能、という設計です。これ自体は妥当な初期値です。問題は、これが呼び出し元のアプリ側のリトライと 掛け算になる 点です。アプリ側で「3回まで試す」と書いたつもりでも、SDK層が各試行の裏でさらに2回走ります。デバッグ中、本番のメトリクスとアプリログの数が合わなくて不思議に思ったら、まずこの二層目を疑ってください。
AIエージェントは、ツール呼び出し・MCPサーバー経由のAPI呼び出し・LLM推論の3層にリトライが仕込まれやすい構造になっています。各層が「2回だけだから控えめ」と判断していても、重なると総試行回数は何倍にも膨らみます。
罠1: Dogpile — 同期した一斉リトライで下流を殺す
Nygardが Release It! の第4章 (Stability Antipatterns) で扱っているアンチパターンのひとつです。キャッシュの有効期限が切れた瞬間、全クライアントがオリジンに同時にリクエストを送る。あるいは、障害から復旧した瞬間、キューに溜まっていたリクエストが一斉に流れ込む。通常時は毎秒100リクエストを捌くサービスが、復旧の第1秒に数千リクエストを受けて、また倒れる。
AIエージェントでこれが怖いのは、「同期の軸」が見えにくいからです。cronで複数ジョブが同じ分で起動すれば同期軸はcrontabですが、プロンプトキャッシュの共有TTLで複数エージェントが同時刻にキャッシュミスする、というパターンは普通のタイムスタンプ監視では見つかりません。
保険: Full Jitter 付き指数バックオフ
AWSのMarc Brookerが2015年3月に書いたExponential Backoff And Jitterが、この問題への基準線です。Full Jitterの式はこれだけです。
import random

def full_jitter_backoff(attempt, base=1.0, cap=60.0):
    delay = min(cap, base * (2 ** attempt))
    return random.uniform(0, delay)
ポイントは random.uniform(0, delay) の下限が0であることです。Marc Brookerの実験では、Equal Jitter (下限 delay/2) は Full Jitter よりやや仕事量が多く完了も遅れる、と結論されています (Full Jitter と Decorrelated Jitter の優劣は保留扱い)。SDKによってはEqual Jitter相当がデフォルトのこともあるので、自前のアプリ層でリトライを書くときは Full Jitter 以上に寄せるのが安全です。
罠2: Thundering Herd — 遅いレスポンスで上流のスレッドが枯渇する
Nygardが「遅いレスポンスはエラーより悪い」と書いた理由がここにあります。依存先が完全に落ちているなら、呼び元は即座にエラーを受けてリソースを解放します。落ちていないが遅い、という状態が最悪で、呼び元のスレッドは30秒なり60秒なり占有され続け、スレッドプールが枯渇します。
LLM推論はこの性質を強く持っています。普段300msで返るMessages APIが、トラフィック急増時に8秒かかる。タイムアウトが30秒に設定されていると、各リクエストが8秒間スレッドを押さえる。並列数の設計がこの8秒を前提にしていないと、呼び出し元のアプリが先に倒れます。これが「上流から倒れていく」カスケーディング障害の典型形です。
保険: SLOから逆算したタイムアウト
タイムアウト設計は、依存先のSLOから引き算で決めます。Messages APIなら公開されているレイテンシSLOを調べ、そこから十分なマージンを取り、呼び出し元のリクエスト全体のSLAから逆算して許容できる最大値を切る。デフォルト値で済ませない。SDKの初期タイムアウトは「切れないため」の値であって、「守るため」の値ではないからです。
もう1点、長時間かかる可能性のあるMessages API呼び出しは、公式ドキュメントが推奨している通り ストリーミングAPIかBatch APIに逃がしてください。10分超のリクエストはSDK側で弾かれる仕様になっています。TCPのidleでコネクションが切れるネットワークに乗ると、タイムアウトを長くするほど壊れやすくなります。
罠3: 無制限リトライ — 完了判定が曖昧なまま副作用が増殖する
ここは Release It! の射程を越えて、金融業界が20年前に身銭を切った話です。2012年8月1日のKnight Capital事件は、SMARSという注文ルーティングシステムに古いPower Pegコードが残っていたことで、約45分間に数百万件の意図しない注文が実行され、Knight自身の開示では約4億6,000万ドルの取引損失を出しました (SEC Enforcement 70694)。
このときのループは、技術的には「リトライ」ではなく注文の再生成でしたが、構造は同じです。完了したことを示すフィードバックが帰ってこない状態で、同じ処理を繰り返した。 外から見ると、副作用のあるリクエストを無制限にリトライしたのと見分けがつきません。
AIエージェントで同じことが起きる場所は、副作用を伴うツール呼び出しです。メール送信・DB書き込み・外部APIへのPOST。504でタイムアウトしたとき、依存先が実際には成功している可能性がある曖昧なケースで、素朴にリトライするとレコードが重複します。
保険: べき等キー + Retry Budget + サーキットブレーカー
まず べき等キー を発行して、同じリクエストが二度処理されない保証を取る。これは呼ばれる側が持つ性質で、呼ぶ側は毎回同じキーを渡すだけです。
次に Retry Budget で、システム全体のリトライを上限で抑える。Google SRE BookのChapter 22 “Addressing Cascading Failures” でMike Ulrichが示している具体的な数字がこれです。
only allow 60 retries per minute in a process, and if the retry budget is exceeded, don’t retry; just fail the request
個別のリクエストが「俺の3回は合理的」と判断しても、プロセス全体で毎分60回の天井を打つ。超えたリトライは諦めて素のエラーを返す、という設計です。クライアントごとの判断を集団で制御するために、カウンターの位置が重要です。各リクエストに持たせない、呼び出し元のプロセスに持たせる。
最後に サーキットブレーカー で、依存先が壊れている間はそもそもリトライしない。Nygardが Release It! 第5章で提案し、Martin Fowlerが 2014年のbliki記事でClosed/Open/Half-Openの3状態モデルとして整理したものです。Open状態では即座に失敗を返して呼び元のリソースを守り、依存先の回復確認はHalf-Open状態で限定的に試す。壊れている依存先を叩き続けないことが、復旧を早める最大の貢献です。
まとめ
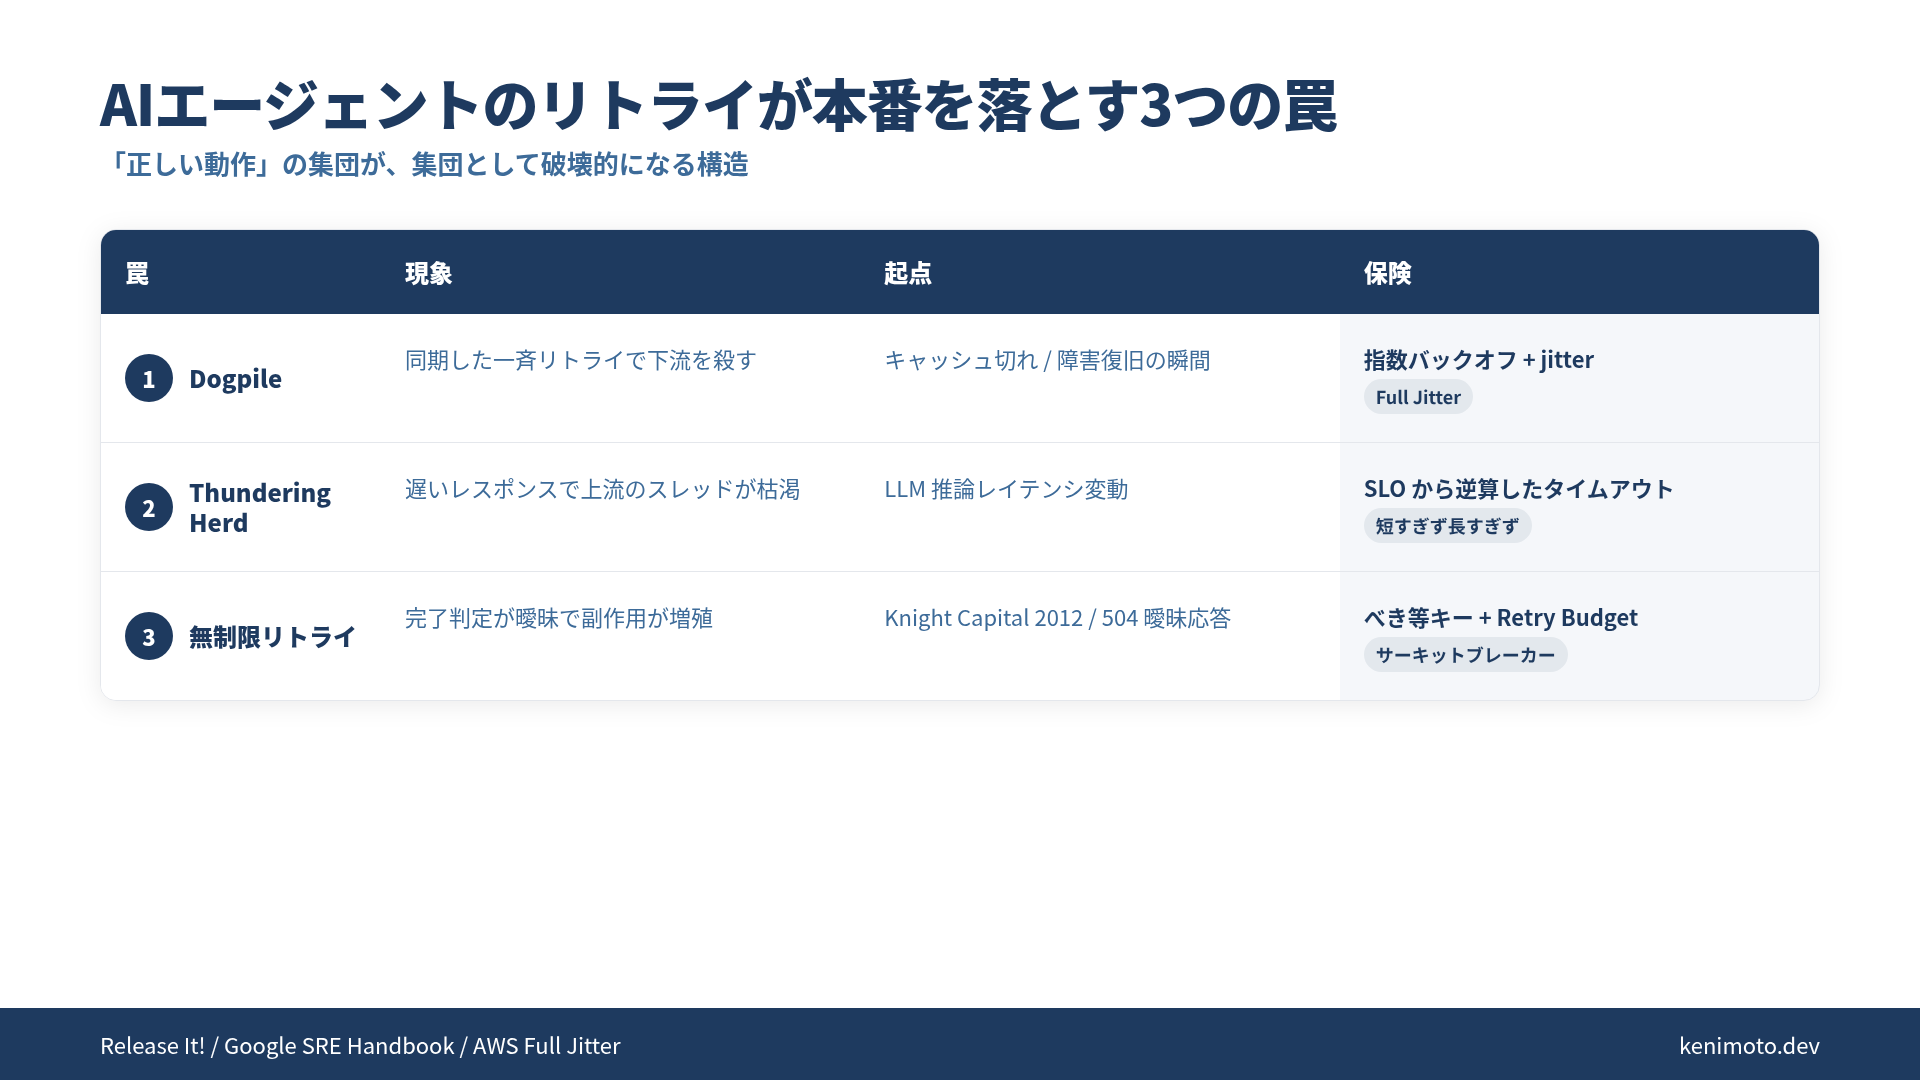
3つの罠と3つの保険を、1行ずつで並べ直します。
| 罠 | 現象の起点 | 保険 |
|---|---|---|
| 1. Dogpile | キャッシュ切れ / 障害復旧の同期 | Full Jitter 付き指数バックオフ |
| 2. Thundering Herd | 遅いレスポンス × スレッド占有 | SLOから逆算したタイムアウト |
| 3. 無制限リトライ | 完了判定の曖昧さ × 副作用 | べき等キー + Retry Budget + サーキットブレーカー |
AIエージェントが新しくしたのは「複数層がデフォルトでリトライする」ことで、根本の失敗パターンはNygardが2007年に名前を付けたときから変わっていません。設計の勘所も変わっていません。古い本に書いてあることが、2026年の自分のcron設計にそのまま効く、という話です。
ハーネス側で防御的な設計をどう置くかは、ハーネス・エンジニアリングの中で、CLAUDE.md / hooks / Agent SDK の層ごとに整理しています。Retry Budgetやサーキットブレーカーを、どのレイヤーに書くとAIエージェントの行動を一番安く縛れるか、という視点でまとめた章があります。
リトライを足すときは、1回だけ自問してください。「このリトライが全クライアントで同時に走ったら、下流は何倍の負荷を受けるか?」この質問の答えが怖いなら、保険が足りていません。
 関連書籍 ハーネス・エンジニアリング ハーネスエンジニアリング 入門 | AGENTS.md 設計・hooks 実装・AIエージェント運用の体系書 書籍ページを見る →
この記事は役に立ちましたか?