ハーネスエンジニアリング: 4社4定義の違い
「ハーネスエンジニアリング」で検索して、定義が4つ出てくる業界があるでしょうか。
私は3週間、OpenAIとAnthropicとLangChainとMartin Fowlerの説明を交互に読み、「結局どれが本物なのか」で止まっていました。先に答えを置いておくと、本物を選ぶ必要はありません。
4社とも違う側面を見ているだけで、どれかが間違っているわけではない。
ただし、違いを知らないまま使うと、設計の話をしているのに相手は組織論の話をしている、みたいなズレが起きます。
この記事では、4社の独自概念だけに絞って並べ、違いを3つのセクションで掘ります。全員が同意している5点や、意見が割れている3点の全体像は、書籍LP 側に置いています。ここでは独自概念の違いだけ。
4社の独自概念を一枚で見る
5項目の軸で比較表を作りました。4社の立ち位置の差が、一番濃く出るのは「独自概念」の行です。
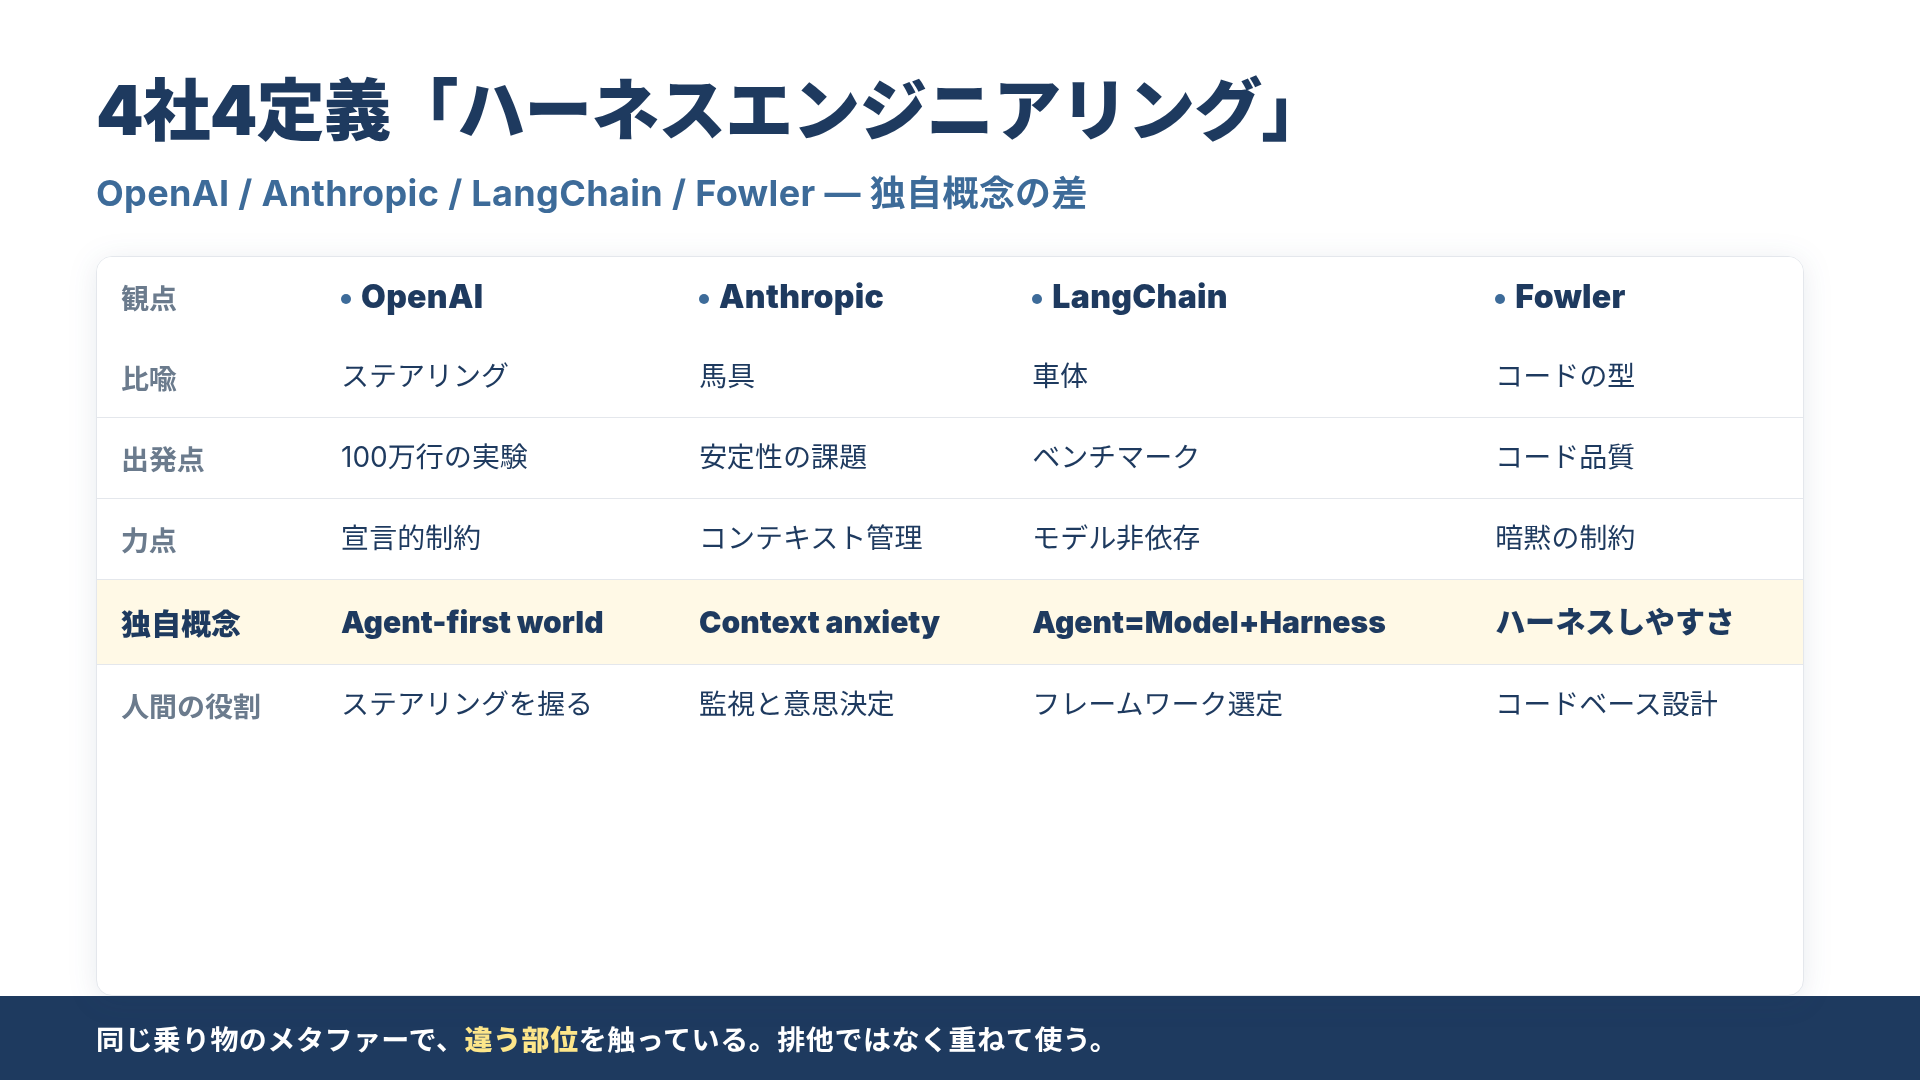
| 観点 | OpenAI | Anthropic | LangChain | Martin Fowler |
|---|---|---|---|---|
| 比喩 | ステアリング | 馬具 | 車体 | コードの型 |
| 出発点 | 100万行規模の実験 | 安定性の課題 | ベンチマーク | コード品質 |
| 力点 | 宣言的制約 | コンテキスト管理 | モデル非依存設計 | 暗黙の制約 |
| 独自概念 | Agent-first world | Context anxiety | Agent = Model + Harness | ハーネスしやすさ |
| 人間の役割 | ステアリングを握る | 監視と意思決定 | フレームワーク選定 | コードベース設計 |
比喩を見てください。4つ全部、乗り物か工作物の部品です。偶然ではありません。「モデル1個では完結しない何かを支える構造」を言葉にしようとすると、人間はこういうたとえに引っ張られるのだと思います。ただし部品のどこを見ているかは全然違います。OpenAIはハンドル、Anthropicは馬の装具、LangChainは車体、Fowlerは型枠。同じ乗り物の違う部位を触っている。
1. OpenAI の「Agent-first world」: 主語が人間からエージェントに移る
OpenAI の独自概念は、言葉の作りからして面白い。「Agent-first world」は、ハーネスの定義ではありません。世界観の定義です。Agent-first は mobile-first のパロディで、「エージェントを一等市民として扱う設計がデフォルトになった世界」を指します。モデルが能力を持った段階ではもう済んでいて、モデルが世界の中で主語になった。この移動が起きたのだ、と宣言しています。
OpenAIの出発点は「100万行規模の実験」でした。1プロンプト1タスクではなく、エージェントが並列で何千回も動く状況で、何が破綻するかを数えた。彼らが見たのは「人間が1つずつプロンプトを調整する時代は終わった」ことです。
結果、ハーネスの力点が「宣言的制約」になりました。手続き的な「こうしろ」を書く代わりに、「これは越えるな」という柵を置く。
並列で動く100個のエージェントに手続きを教えて回るのは不可能で、柵しか拡張性がない。
私の実務感覚で言うと、CLAUDE.md に「禁止事項」を書くときの気持ちに近い。「このコマンドを打つ時はこうしろ」と書く代わりに、「このディレクトリには触れるな」と書く。前者は1個のタスクにしか効かないけれど、後者は全タスクに効きます。
# OpenAI 的ハーネスの気分
constraints:
  forbidden_paths: ["/etc", "/var/log"]
  max_turns: 50
  must_write_tests: true
# 「どうやれ」ではなく「越えるな」
2. Anthropic の「Context anxiety」: 不安を名付けた唯一の視点
Anthropic の独自概念は、技術用語の中に心理学の語を持ち込みました。「Context anxiety」。コンテキスト不安。
対象はモデルではありません。モデルを運用する人間の話です。コンテキストが長くなるほど、どこで破綻するか分からなくなる。要約がどこで嘘を入れたか追えなくなる。開発者はその不安を抱えたまま走り続ける。この状態を Anthropic だけが名付けました。
出発点は「安定性の課題」です。賢いモデルほど、ハーネスを足すと逆効果になる場面がある(私は「賢いモデルほどハーネスは捨てる設計になる」 で別途書きました)。Claude Sonnet 4.5 では context anxiety が十分に強く、コンパクション(要約)だけでは長時間タスクの性能を保てずコンテキストリセットが必須になった、という Anthropic 自身の報告もある。したがって力点は「コンテキスト管理」に寄ります。モデルは何でも覚えてしまうけれど、何でも覚えると壊れる。
だから何を忘れさせるかを設計する。
Context anxiety という語を持つと、同じ現象を全く違う角度で見られます。「エージェントが途中でおかしくなった」ではない。「エージェントが抱える不安が閾値を超えた」。前者は原因が追えないけれど、後者は「不安を減らす = コンテキストを削る」という処方が出てきます。
私が最近 Claude Code で意識しているのは、タスクが長くなったら /clear を打つことです。これは Anthropic の「不安を減らす」設計思想を、ユーザー側で実行する行為に近い。Sonnet 4.5 のあのレポートを読んで以降、意図的にやるようになりました。
3. LangChain の「式」vs Fowler の「態度」: 同じ現象を定式化と設計姿勢で言う
残り2社は、組み合わせで見ると面白い。独自概念が正反対の表現方法を取っています。
LangChain は式を書きました。 Agent = Model + Harness。これは定義です。エージェントとは何か、を2項の足し算で言い切った。モデルを交換してもハーネスが残れば、エージェントは別物になる。ハーネスを剥がせばモデルだけが残る。式になっているので、議論の軸が「どちらの貢献度が大きいか」に収束します。LangChain が Terminal-Bench 2.0 で 52.8% → 66.5% まで押し上げた実験は、まさに「ハーネス側の貢献を数字で測った」です(英語記事)。
Fowler は式を書きませんでした。 代わりに設計の態度として「ハーネスしやすさ(harness-ability)」を持ってきた。コードベースがハーネスを受け入れやすい状態になっているか、を問うものです。式を書かず、品質の尺度を提示した。
| LangChain | Fowler | |
|---|---|---|
| 独自概念の形 | 式 (A = M + H) | 態度 (ハーネスしやすさ) |
| 答えを出す対象 | 「エージェントとは何か」 | 「このコードベースは良いか」 |
| 測り方 | ベンチマークスコアの差分 | コードレビュー的な審美 |
| 読者が得るもの | 設計の構造 | 設計の指針 |
この違いは、両方同時に成立します。LangChain はどう組み合わせるかを定式化して、Fowler は組み合わせる前提のコードがどうあるべきかを言った。式の中の Harness を実装するのに、Fowler のハーネスしやすさは必要です。逆に Fowler のハーネスしやすさを満たしても、LangChain 的な分離構造を知らないと、どこを切るべきか分からない。
Fowler の視点がどう効くかは、Fowler 本人の記事を 3 セクションで解剖した別記事 に書きました。
結局どれを採ればいいのか
採る必要はありません。4社とも使えます。実務での選び方だけ書いておきます。
- 並列エージェントを運用する時 → OpenAI 的に「越えるな」の柵を書く
- 長いセッションを安定させたい時 → Anthropic 的に「何を忘れさせるか」を設計する
- モデルを選ぶ時 → LangChain 的に「式のどの項が効くか」で測る
- コードベースをリファクタする時 → Fowler 的に「ハーネスしやすい形か」で見る
4つを「排他的な選択肢」として扱わなければいい。むしろ同じ現象の違う位相だと思っています。乗り物のたとえを4社が偶然選んだのも、ここに来て理由が分かる。それぞれが別の部位を触っているので、重ねて見ると部品の集合体として見える。
一つだけ譲れないのは、独自概念の名前を混ぜないこと。「Agent-first world でコンテキストを管理する」と書いても意味が通りそうに見えて、実は違う話を2つ合わせているだけです。設計の議論で言葉がぶれると、同じ会議の2人が別の話をしていることに気付けません。
4社4定義は、知って使い分けるためにあります。
4社の全体像(全員が同意する5点、意見が割れる3点、各社の原典への橋渡し)は、『ハーネスエンジニアリング実践ガイド』 に章立てで入れています。独自概念の違いだけ押さえておけば、業界の議論は追えるようになるはずです。
 関連書籍 ハーネス・エンジニアリング ハーネスエンジニアリング 入門 | AGENTS.md 設計・hooks 実装・AIエージェント運用の体系書 書籍ページを見る →
この記事は役に立ちましたか?