GraphRAGでコードレビューを7段階に分解
500行の差分を渡された金曜の夕方、私はまだgrepでimport文を追いかけていた。「多分これで全部の呼び出し元は追えたはず」と祈りながらApproveボタンを押す、あの気持ちを一度でも味わうと、コードレビューは実は「探す作業」だと気づいてしまう。「読む作業」ではない。探す作業は自動化できる。ソースコードは本質的にグラフ構造を持っていて、Knowledge Graph (KG) にすると「変更の影響範囲」が2秒で返ってくる。私はここ数ヶ月、コードKGとMCP (Model Context Protocol) を組み合わせてPRレビューを再設計した。
手順は7段階に分かれ、落とし穴は3つある。
なぜKGなのか、なぜファイル単位ではダメなのか
ファイルは人間が編集する単位で、影響が伝播する単位ではない。auth.py を1行変えたら、middleware.py が呼び出しに巻き込まれ、テストが3ファイル、間接依存で conftest.py まで届く。この波及は関数呼び出しグラフの「hop距離」で表現できる。コードをグラフに変換すると、「hop 0 = 変更ファイル自体」「hop 1 = 直接呼び出す先」「hop 2 = 間接呼び出し」というふうに、影響範囲が数字で降ってくる。
grepで30分かけていた作業が、Cypherクエリ1本で終わる。
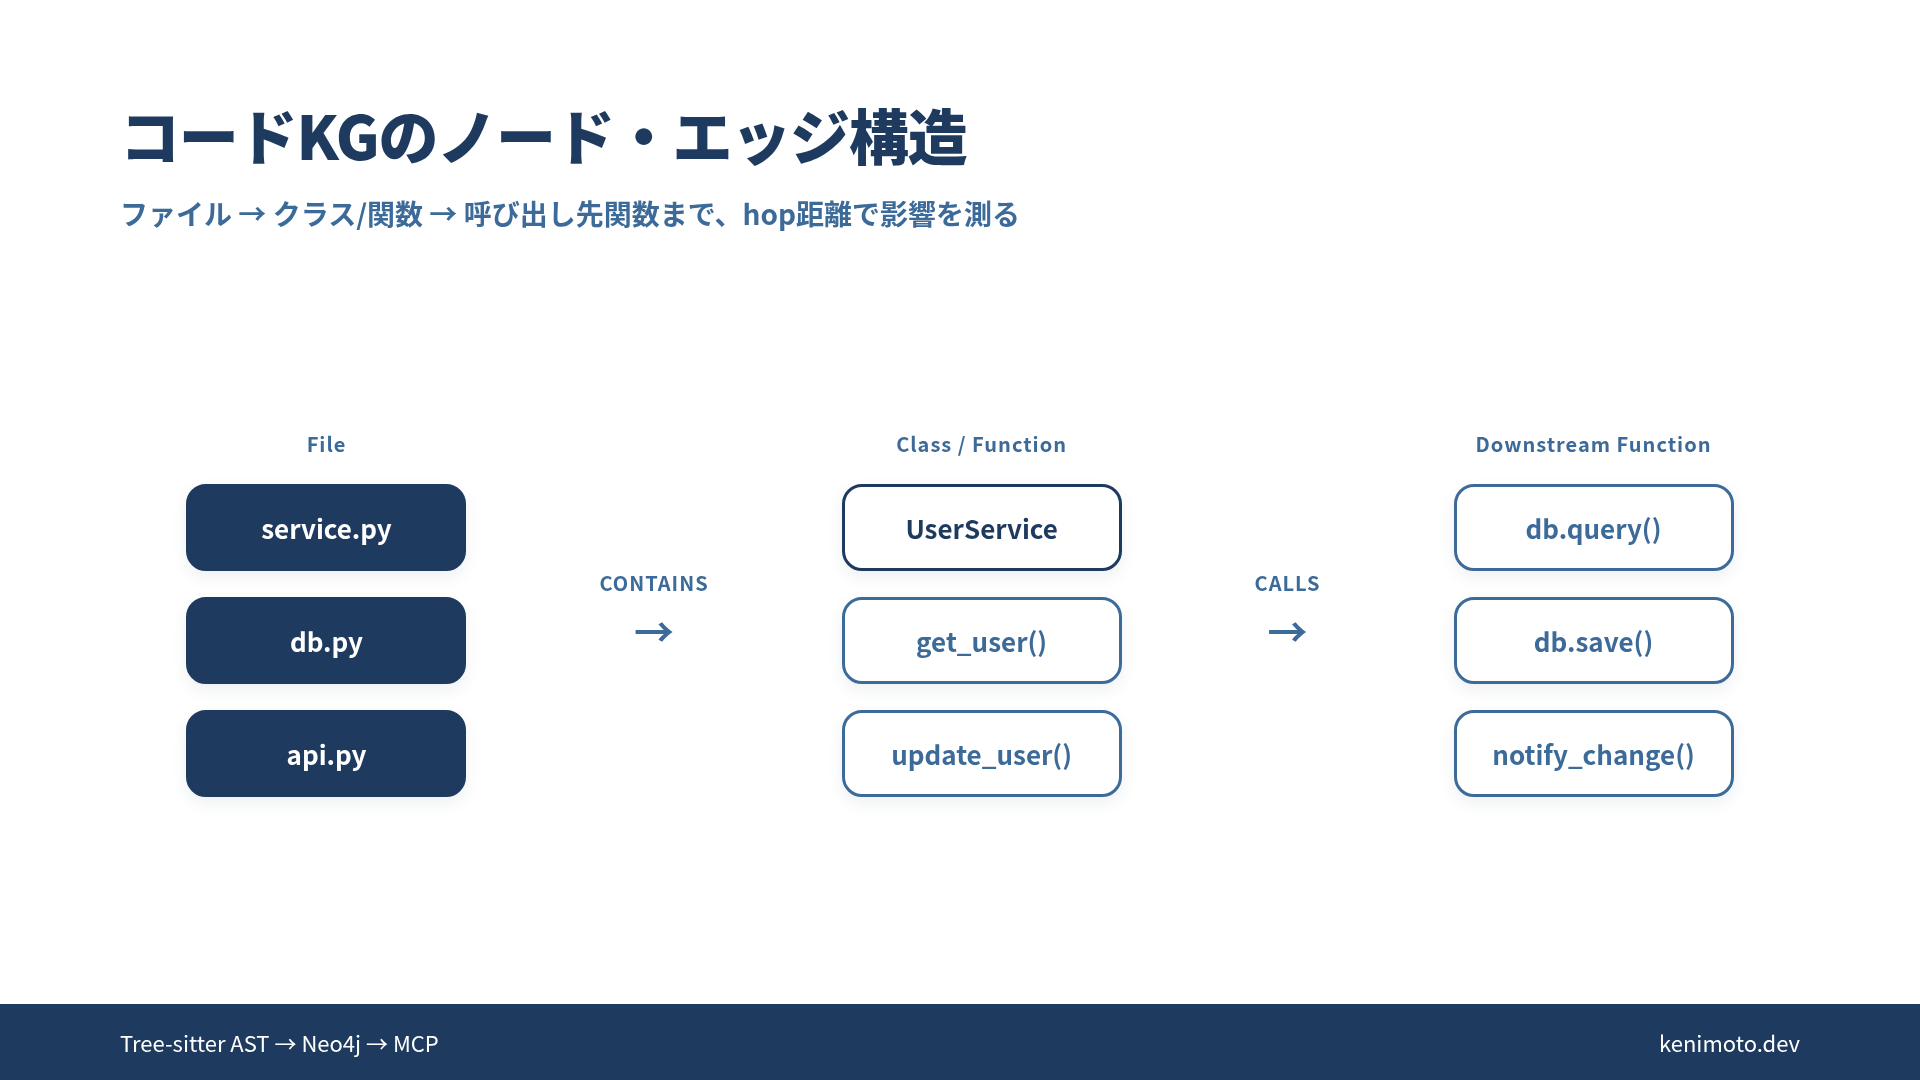
7ステップの分解
Step 1: Tree-sitterでASTを取る
コードKGの入口は決定論的AST解析だ。Tree-sitterは19以上のプログラミング言語に対応していて、LLMを使わずローカルで高速に走る。
import tree_sitter_python as tspython
from tree_sitter import Language, Parser

parser = Parser(Language(tspython.language()))
tree = parser.parse(open("service.py", "rb").read())
ここで得られるのは、関数・クラス・変数の位置情報を持った構文木。LLMに投げる前に、まず「機械的に確実にわかること」を抽出しきる。
この分離が後で効いてくる。
Step 2: ノードとエッジを設計する
ノードは File / Class / Function / Module。エッジは CALLS / IMPORTS / INHERITS / CONTAINS。
(:Function {name: "get_user", file: "service.py", line: 12})
  -[:CALLS]->
(:Function {name: "db.query", file: "db.py", line: 45})
粒度で迷ったら、まずは関数レベル。ステートメントまで落とすとノード数が爆発し、Neo4jのメモリが先に音を上げる。
Step 3: Neo4jに投入する
グラフDBの選択肢は3つ。組込型で試すならKuzuDB (pip install kuzu)、本番ならNeo4j、FalkorDBはRedis互換で使い勝手がいい。今回はNeo4jで進める。投入自体は UNWIND バッチで数万ノードなら数秒。ここで手を抜くと後段のクエリが遅くなるので、CREATE INDEX はノードラベルごとに必ず張っておく。
Step 4: MCPサーバーを立てる
ここが本題。
mcp-neo4j-cypher (v0.6.0、2026-04リリース) を使うと、Neo4jのグラフをMCPツールとしてClaude CodeやCursorから叩けるようになる。公開されているツールは3つだけ。
get_neo4j_schema— ノードラベル・属性・リレーションシップを一覧read_neo4j_cypher— 読み取りクエリを実行write_neo4j_cypher— 書き込みクエリを実行
Claude Code の設定ファイルにサーバーを登録すると、AIアシスタントは自然言語で受けた質問を裏でCypherに翻訳して投げてくれる。PRレビューの文脈だと、read_neo4j_cypher の1本があれば9割は回る。
Step 5: PR diff から blast radius を引く
変更ファイル auth.py の影響範囲を4 hop先まで取るCypher。
MATCH (start:File {path: "auth.py"})-[*1..4]-(affected)
RETURN DISTINCT affected.path AS file,
       length(shortestPath((start)-[*]-(affected))) AS hop
ORDER BY hop
LIMIT 50
初めて叩いたとき、7ファイルのリストが2秒で返ってきた。自分が30分かけてgrepしていたのとほぼ同じ結果だった。
あの30分は何だったのか、という気持ちになる。
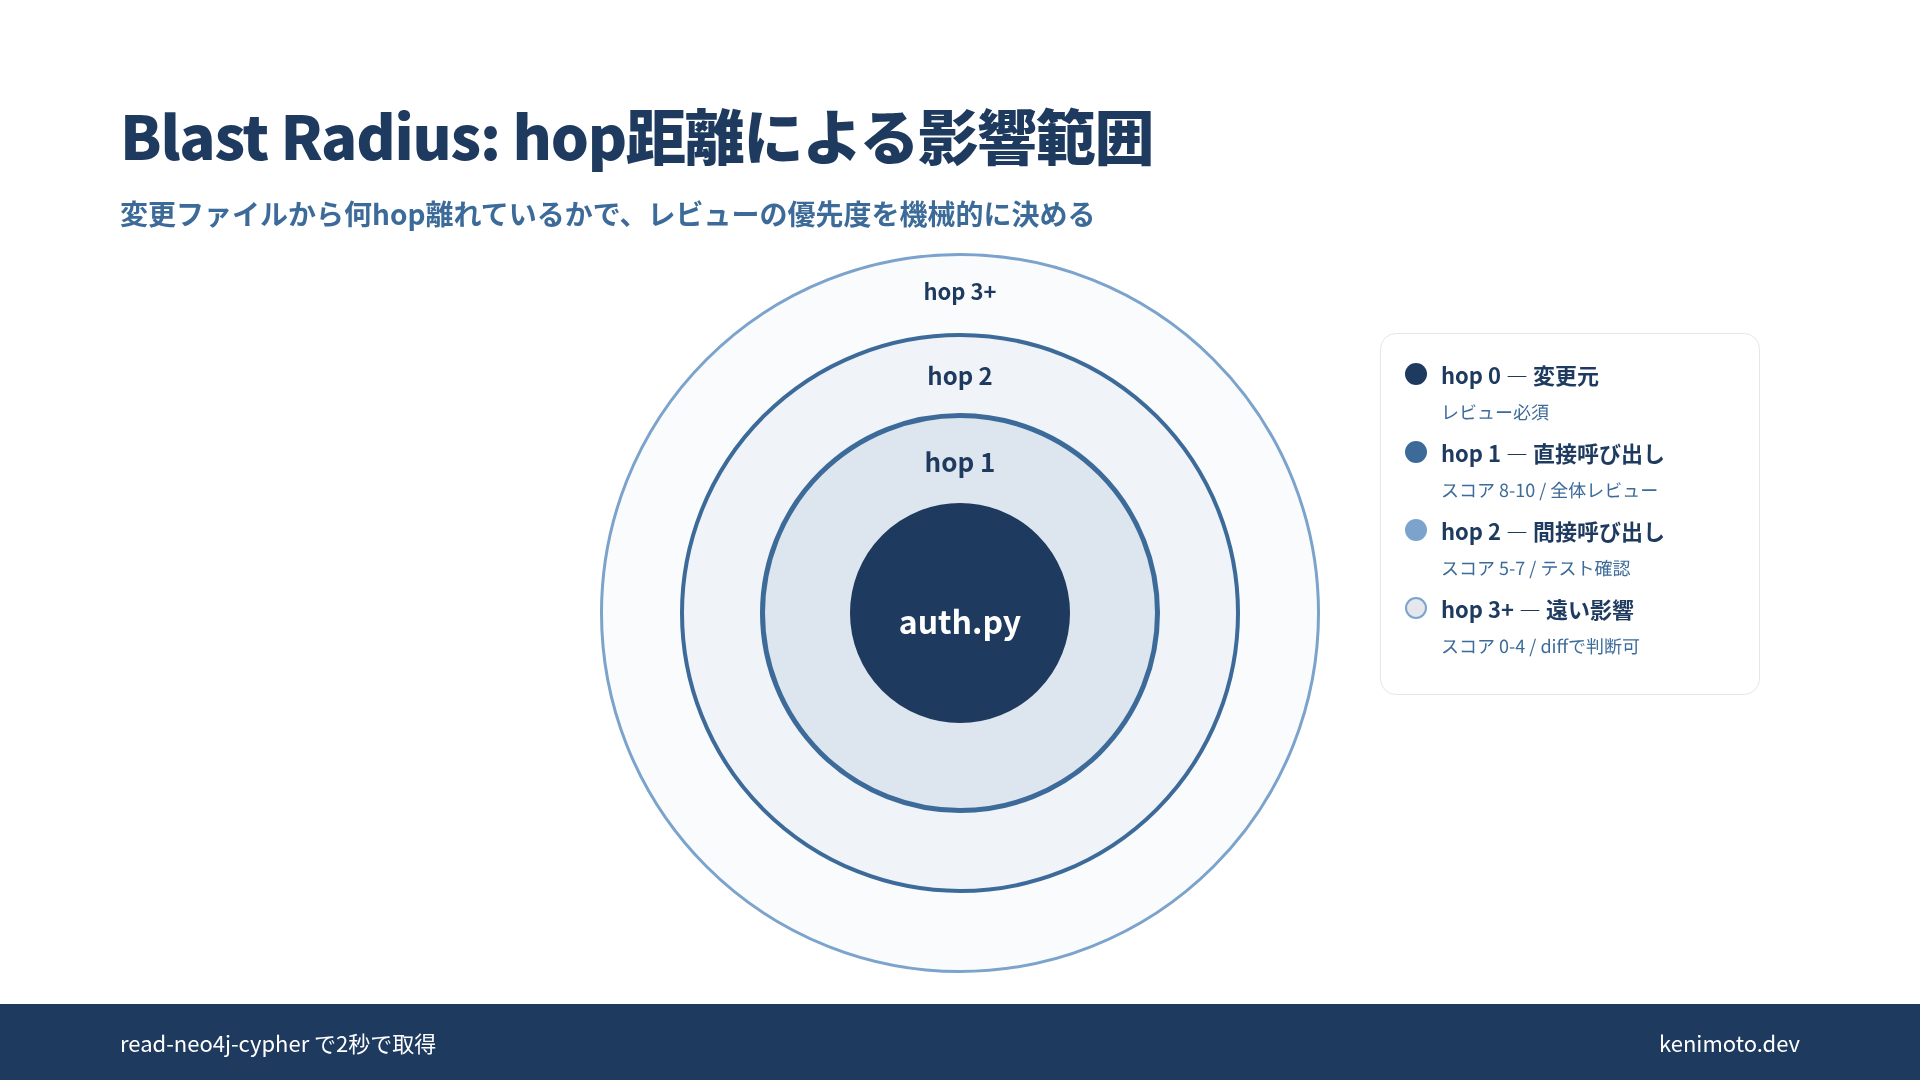
Step 6: リスクスコアで優先度を出す
hop 数と「影響ファイル数 × 変更行数」を掛けたスコアで、レビュー優先度を機械的に決める。
- スコア 8-10: 分散した影響、レビュー時に呼び出し元を全部見る
- スコア 5-7: 局所的、テスト側の変更で十分
- スコア 0-4: リスク低、diffだけで判断可
私は「hop 2以上まで届いたら追加レビュアーを呼ぶ」ルールを機械的に置いている。人間の目視では『多分大丈夫』で流していた領域が、数字で線が引けるようになる。
Step 7: AIレビュアーに渡すコンテキストを絞る
これがKGの最大の投資対効果ポイント。
従来のAIコードレビューは「念のため関連ファイル50個」を全部コンテキストに入れていた。blast radius で特定した7ファイルだけ渡すと、トークン消費が数倍から数十倍削減される。おまけに、レビュー品質は上がる。ノイズが減るのだから当然だ。
従来: 変更ファイル + 周辺50個 = 150,000 tokens
KG絞り込み: 変更ファイル + hop1-2の7個 = 18,000 tokens同じPRレビューで、3つのsub-agentに独立で見せて40%が食い違った実測を以前書いた。あの実験もコンテキストを絞ってからやると、食い違いパターンが変わる。「見ていないから食い違う」のと「見ているけど解釈が違う」のは切り分けたほうがいい。
3つの落とし穴
落とし穴1: 全関数をノードにする
初回で必ずやる。
10万行のリポジトリで関数レベルまで全部ノードにすると、Neo4jのメモリが飛ぶし、クエリも遅い。対策は「エントリポイントと公開APIだけノードにする」。privateなヘルパー関数はエッジの属性に押し込む。粒度は後から細かくできるが、粗くするのは大変だ。
落とし穴2: エッジの信頼度をフラットに扱う
Tree-sitterのAST解析は「確実にわかるエッジ」しか出さない。でも動的言語 (Python/JS) では、getattr() や **kwargs 経由の呼び出しは静的解析で追いきれない。
落とし穴3: グラフを更新しない
一度作ったKGは、リポジトリの変更に合わせて更新しないと3週間で嘘をつく。手動更新は続かない。CIに graph rebuild ステップを入れる。1万ファイル規模でも差分更新なら30秒程度。「グラフの新鮮さ」は運用の質の指標になる。ここで手を抜くと、レビュアーが「グラフはもう当てにならない」と言い出して、また grep に戻る。
まとめ
コードをKGにすると、PRレビューが「読む」から「クエリする」に変わる。7ステップは Tree-sitter → ノード/エッジ設計 → Neo4j投入 → mcp-neo4j-cypher → blast radius → リスクスコア → AI渡し。落とし穴は粒度・信頼度・更新の3つ。
「多分これで全部」でApproveを押す必要は、もうない。
References
- mcp-neo4j-cypher — PyPI
- Model Context Protocol (MCP) Integrations for the Neo4j Graph Database
- Tree-sitter — 決定論的AST解析
もっと深く知りたい方へ
本記事はコードKGの入口だけ。Neo4jスキーマ設計、Property Graph vs RDFの選択、code-review-graph・GitNexus・CodeGraphContextなどのツール比較、企業導入事例までを1冊にまとめたのが ナレッジグラフ活用大全 です。
 関連書籍 ナレッジグラフ活用大全 ナレッジグラフ 活用大全 | GraphRAG・Neo4j・RDF・Property Graph・Emotion AI の実践書 書籍ページを見る →
この記事は役に立ちましたか?