ハーネスエンジニアリング、Fowler実物の3節
「ハーネスエンジニアリング」を新語だと思っていた時期があります。AGENTS.md を書いたり、hooks を設定したり、新しい足場を組み上げていく仕事だと。Martin Fowler の Harness engineering for coding agent users (2026-04-02) を読み直したのは今週です。読み終えて、自分がこの3年で書いてきた pre-push や check-built-pages.mjs に、Fowler が名前を付けてくれただけだと気づきました。
この記事は、Fowler の原文にある3つの節を順番に読み、それぞれ自分の kenimoto-dev リポジトリで対応する装置を棚卸ししたログです。書いてみて分かったのは、ハーネスは「これから作るもの」ではなく、「既にあるものを見つけて、足りないところに 1 個ずつ足すもの」だということです。
Fowler の定義: Agent = Model + Harness
まず Fowler が Harness をどう定義しているかを、原文の言葉で確認します。
Agent = Model + Harness
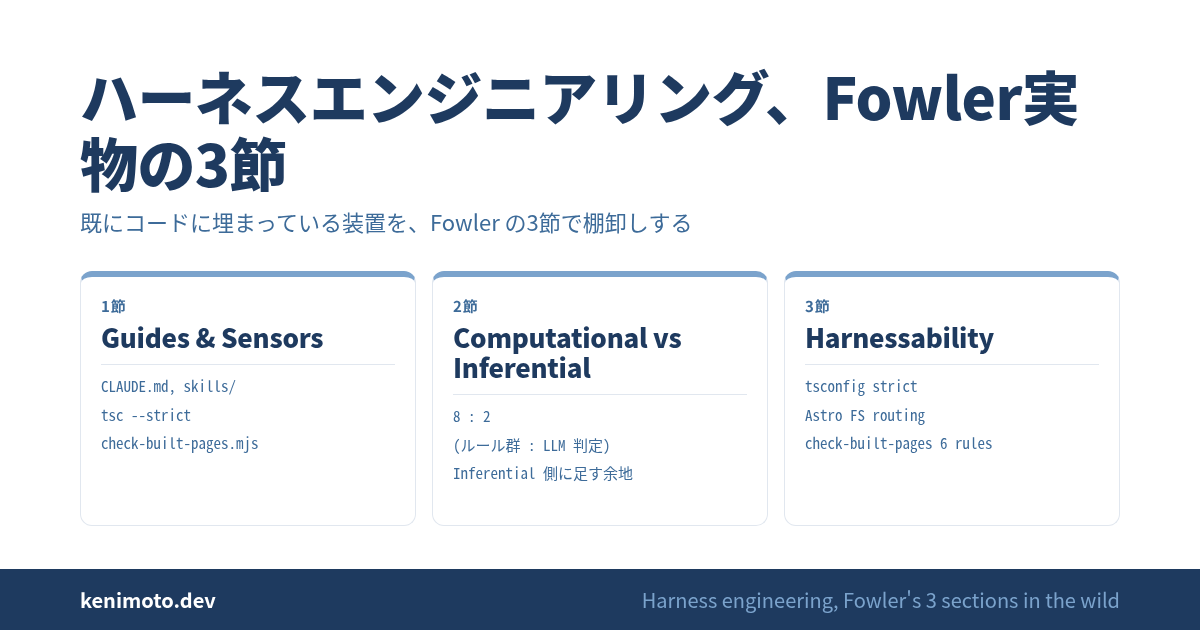
これだけです。エージェントを構成する要素のうち「モデルそのもの以外の全部」がハーネス、という広い定義です。定義が広いので、記事本体は「じゃあその全部を、どんな軸で分けて論じるか」の話に費やされます。Fowler は自分の記事の中で複数の切り口を提示していますが、私が読み直して「ここが実装者にとって効く」と感じた3節を選んで並べます。
- 1節目: Feedforward vs Feedback (Guides と Sensors)
- 2節目: Computational vs Inferential
- 3節目: Harnessability
3節目の Harnessability が、この記事の中心にある概念です。「ハーネスはコードベースに埋まっている」という主張の出どころはここです。ですが 3節目だけを読むと文脈が抜けるので、1節目と 2節目を先に置きます。
1節: Guides と Sensors (Feedforward vs Feedback)
Fowler は Harness を大きく 2 種類に分けます。原文の表現でいうと Guides は「anticipate the agent’s behaviour and aim to steer it before it acts」、Sensors は「observe after the agent acts and help it self-correct」です。前者はフィードフォワード制御、後者はフィードバック制御に対応します。
具体例に落とすと、AGENTS.md やスキル定義、コードのコメント、命名規約は Guides です。エージェントがコードを書き始める前に「こういう風に書け」と伝えるものはすべてここに入ります。一方、linter、型チェッカー、テスト、AI コードレビューは Sensors です。書いたあとで「そこはおかしい」と返してやり直させるものたち。
Fowler が強調しているのは、Guides だけでも Sensors だけでも足りない、両方が要る、という点です。Guides は事前に伝えられる情報の量に限界があるし、Sensors だけだと「間違えてから直す」の繰り返しでコストが膨らむ。両方を組み合わせて初めて steering loop が閉じます。
私の repo で対応する装置を並べてみます。
| Guides | 実装 |
|---|---|
| プロジェクト側の指針 | CLAUDE.md (デザインルールと記事の型の 2 節、絵文字禁止・裏の取れない一人称を禁じ手として明記) |
| 執筆スキル | .claude/skills/ (SKILL.md の description が発火条件) |
| 記事の型の正本 | docs/article-formats.md (解説型 vs 実測型の判定基準) |
| Sensors | 実装 |
|---|---|
| 型チェッカー | tsconfig.json は astro/tsconfigs/strict を extends して strict: true |
| ビルド時のページ検査 | scripts/check-built-pages.mjs (216 行、6 ルール、646 ページに実行) |
| push の直前検査 | scripts/git-hooks/pre-push (HEAD が main でなければ拒否) |
書き出してみると、Guides と Sensors がだいたい 1:1 で並んでいます。棚卸しをする前は「Guides ばかりで Sensors が薄い」と自己認識していたのですが、実際に数えたら思ったより Sensors 側が育っていました。過去の自分が痛い目に遭うたびに 1 本ずつ書いた check-built-pages.mjs のルール (後述) が、少しずつ積み上がっていたからです。
2節: Computational と Inferential
Sensors は 2 種類にさらに分けられます。Fowler の言い方は Computational (deterministic and fast, run by the CPU) と Inferential (LLM ベース、slower and more expensive; results are more non-deterministic) です。
Computational は linter、型チェック、テスト、正規表現、diff。ミリ秒〜秒で結果が返り、再実行すれば同じ結果が出ます。Inferential は AI コードレビュー、意味的な妥当性判定、命名の一貫性チェック。時間もコストもかかり、同じ入力でも結果が揺れます。
Fowler の主張は、両方が要るです。Computational は速くて確実だが、機械的なパターンでしか動けない。Inferential は遅くて不確実だが、意味を理解する必要のある判断ができる。片方だけでは覆えない領域があります。
私の repo に置いてある Sensors を Computational / Inferential 軸で分類し直します。
| 種類 | 実装 | どういう指摘を返すか |
|---|---|---|
| Computational | tsc --strict | 型の不整合をコンパイル時に検出 |
| Computational | check-built-pages.mjs ルール A | 本文 .prose が 300 字未満なら fail |
| Computational | check-built-pages.mjs ルール B | rel=canonical の行き先が dist に存在しないと fail |
| Computational | check-built-pages.mjs ルール C | <aside> の開閉タグと Markdown 空行の関係が壊れていたら fail |
| Computational | check-built-pages.mjs ルール D | remark-directive に食われた : の残骸を検出 |
| Computational | check-built-pages.mjs ルール E | UNVERIFIABLE_CLAIMS 正規表現群 (例: \d+社を(支援|見てき|伴走)) |
| Computational | check-built-pages.mjs ルール F | 箇条書き項目が前項依存の接続詞で始まっていたら fail |
| Computational | pre-push | HEAD が main でなければ push 拒否 |
| Inferential | /zenn-review スキル | AI Slop / Wit / 導線 / 字数のセルフレビュー |
| Inferential | /avoid-ai-writing-ja-detect | 「〜だけ」「〜こそ」「〜のみならず」等の AI 文体パターン検出 |
書いてみて発見だったのは、私の repo の Sensors は 8 対 2 で Computational に偏っている という事実です。Inferential 側はスキル化されているものが 2 個しかない。過去 3 年、私は「まず正規表現で書けるルールから入れる」という選び方をしてきたわけです。Fowler の分類で眺め直すと、Inferential をもう少し増やす余地があると分かります。
Fowler の記事のもう一つの示唆は、Inferential を Computational の代わりに使わないことです。「機械的なパターンで書けるチェックを LLM に任せる」のは、遅くて高くて不安定な選択になる。逆に「意味の一貫性」を正規表現で書こうとすると、書けても保守できないルールの塊になる。適材適所です。
3節: Harnessability — codebase 自体がハーネスを持つ
ここが Fowler の記事で一番味のある節です。原文からの直接引用です。
A codebase written in a strongly typed language naturally has type-checking as a sensor; clearly definable module boundaries afford architectural constraint rules; frameworks like Spring abstract away details the agent doesn’t even have to worry about.
強い型付き言語で書かれたコードベースは、型チェックが Sensor になる。明確なモジュール境界はアーキテクチャ制約のルールを支える。Spring のようなフレームワークは、そもそもエージェントが気にしなくていい詳細を抽象化してくれる。
Fowler がここで言っているのは、ハーネスを「後付けする」だけではなく、コードベースの性質そのものがハーネスを支える (Harnessable にする) ということです。同じ AGENTS.md を書いたとしても、TypeScript strict 相手と JavaScript の any 祭り相手では、エージェントの成功確率がまるで違う。
私の kenimoto-dev はどれくらい Harnessable か、を測ってみます。
| 観点 | 実測 | Harnessability への寄与 |
|---|---|---|
| 型付き言語か | tsconfig.json が astro/tsconfigs/strict を extends、strict: true | 型不整合を Sensor が拾う |
| モジュール境界 | 25 本の .ts と 118 本の .astro。src/ 配下のディレクトリ分割 (content/, layouts/, pages/, lib/) | エージェントが「どこに書くか」で迷いにくい |
| フレームワーク規約 | Astro のファイルシステムルーティング。src/pages/**/*.astro がそのままURL | ルーティング設定を書かせない |
| ビルド時の閉じ込め | astro build の後段に check-built-pages.mjs (646 ページを検査) を配置 | 壊れた成果物は本番へ出ない |
このうち、私自身が最近になって効いていると感じているのが check-built-pages.mjs の 6 ルールです。書いた経緯を並べると、次の性質が見えてきます。
- A (本文短すぎ): 2026-08-30、remark プラグインが CI で例外を投げた結果、本文ゼロの記事が「デプロイ成功」として本番に出た事故のあと足した
- B (canonical の行き先不在): 同日、frontmatter の canonical_url を手書きで維持していて、slug を変えた記事が 404 を正規 URL として Google に申告し続けていたのを見つけたあと足した
- C (囲みの壊れ方 3 種): 2026-09-03、sudoers 記事で
<aside>の開閉タグ前後の空行を入れ忘れて、生の**と###が読者の画面に出ていた事故のあと足した - D (:の残骸): 同日、
17:11のような時刻表記が remark-directive の textDirective として解釈され、.md644 本中 75 本 192 箇所で空の<div></div>が発生していたのを見つけたあと足した - E (裏の取れない一人称): 同日、「12 社の GraphRAG を見てきました」で始まる受託記録ゼロの記事 2 本を発見して削除し、正規表現化した
- F (前項依存の接続詞): 2026-09-09、自分のまとめの箇条書きで踏んだ
6 ルール全部が、私が過去に踏んだ地雷の跡地です。 事故のあとに検査を 1 本ずつ足していったら、6 ルール、216 行のスクリプトになっていました。これは「後付けのハーネス」なのですが、astro build のパイプラインに組み込まれたあとは、コードベース側の性質として振る舞います。次に私が同じ地雷を踏もうとすると、Cloudflare のビルドが exit 1 で止まる。私 (と、私のリポジトリで作業するエージェント) は、その事故に「気づく」機会すら奪われる。これが Fowler の言う「codebase に埋まっているハーネス」だと思います。
棚卸しの結果、次に足すべきもの
3節を順に読んで自分の repo に対応させた結果、次に足すべきものが 2 つ見えました。
- Inferential 側の Sensor をあと 2〜3 本追加する。現状は AI Slop 検出とレビュー通し1本しかない。「記事全体のロジックの飛躍を LLM が拾う」種類のセンサーがまだ弱い
- Guides 側の「執筆前に AGENTS.md 相当を読ませる導線」を明示化する。
docs/article-formats.mdは正本として置いてあるが、エージェントが記事を書き始める前に必ず読む導線にはなっていない
これは私の repo の話ですが、この棚卸しの手順は他のリポジトリにもそのまま使えます。Fowler の 3節 (Guides/Sensors、Computational/Inferential、Harnessability) を軸にして、既に置いてある装置を分類し、偏りを見つけ、足りない側に 1〜2 本足す。作るのではなく数える作業から入る、ということです。
反論と限界
正直に書いておくべきこと。
Fowler の記事は 2026-04 のもので、モデルとエージェントの前提はこの半年で動いています。特に Inferential Sensors のコスト構造は Sonnet / Haiku の値下げでかなり変わりました。今後 Inferential の比重は上がる方向に振れると思います。
3節を選んだのは私の選び方です。Fowler は他にも Regulation categories (Maintainability / Architecture fitness / Behaviour の 3 分類) や、Timing (「品質は左に寄せる」の議論) など、実装者にとって役立つ節を並べています。私が「3節」に絞ったのは字数の都合と、「棚卸しの軸」として最小限の 3 個を選ぶためです。原文は 8〜9 節あります。
「codebase に埋まっている」は魔法ではない。type-checking がある = 全部の失敗を Sensor が拾ってくれる、ではありません。型は「型の不整合」しか拾わない。ロジックの誤り、命名の一貫性、可読性はすべて別の Sensor が要ります。Fowler も原文で「strongly typed language naturally has type-checking as a sensor」と書いていて、あくまで一種類の Sensor として位置づけています。
まとめ
- Fowler の定義は「Agent = Model + Harness」。モデル以外の全部がハーネス
- Fowler が置いた軸は主に 3 つ: Guides vs Sensors、Computational vs Inferential、Harnessability
- Harnessability = コードベース自体の性質 (型付き、モジュール境界、フレームワーク規約) が Sensor と Guide を支える
- 私の kenimoto-dev で棚卸ししたら、Sensor は 8:2 で Computational に偏っていて、Inferential 側に足す余地があった
- 6 ルールの
check-built-pages.mjsは全部、事故のあとに 1 本ずつ足した「後付け」だが、ビルドパイプラインに置いた瞬間から「コードベースの性質」に変わる - 「新しいハーネスを作る」より、既にあるものを Fowler の 3節で分類し、偏りを 1 本ずつ埋める方が、たぶん近道
check-built-pages.mjs に 6 ルール足すのに 3 週間かかりました。3節で分類するのは今週 15 分で済みました。同じ量の設計を、私は事故 6 件を経てから書いていた。分類軸を先に持っていれば、たぶん 3 件目あたりで「Sensor 側が偏っている」に気づけていたはずです。
関連
- 内部リンク: AIエージェントのハーネスを構成する6要素 — 10分でCLAUDE.mdを棚卸しするチェックリスト (実装者側から見た 6 分類。Fowler の Guides/Sensors 軸と直交する棚卸し軸として併用できる)
- 一次資料: Harness engineering for coding agent users - Martin Fowler (2026-04-02)
 関連書籍 ハーネス・エンジニアリング ハーネスエンジニアリング 入門 | AGENTS.md 設計・hooks 実装・AIエージェント運用の体系書 書籍ページを見る →
この記事は役に立ちましたか?