日本語Realtime APIが800msに寄る訳
OpenAI の Realtime API を触ると、応答レイテンシは 300ms のときもあれば 800ms を越えるときもあります。この 500ms の幅がどこから来るのか、日本語のときに上限側に寄る理由は何か、公式ドキュメントを起点に読み解いた解説記事です。
私が最初にこの幅を「たまたま」と思ったのが失敗でした。実際にはパラメータのデフォルト値と、日本語という言語の構造が、遅い側に寄せています。両方とも公式ドキュメントの範囲で直せます。
「typical 300-800ms」は公式の言葉
OpenAI のリアルタイム翻訳ブログには、こう書かれています。
“End-to-end latency (from when a speaker finishes a sentence to when translated audio starts playing) is typically 300–800 milliseconds under normal conditions.”
end-to-end で 300ms から 800ms。500ms の幅を公式が容認している時点で、「レイテンシは実装で決まる」というメッセージです。手を入れないと 800ms 側に寄ります。
書籍 voice AI 300msのUX設計 第5章では、カスケード構成で最速 525ms、通常 1,300ms という積み上げを扱いました。Realtime API は統合モデルなのでカスケードの積み上げは消えますが、代わりに VAD と言語構造が別の遅延源として出てきます。
日本語で上限側に寄る3つの構造
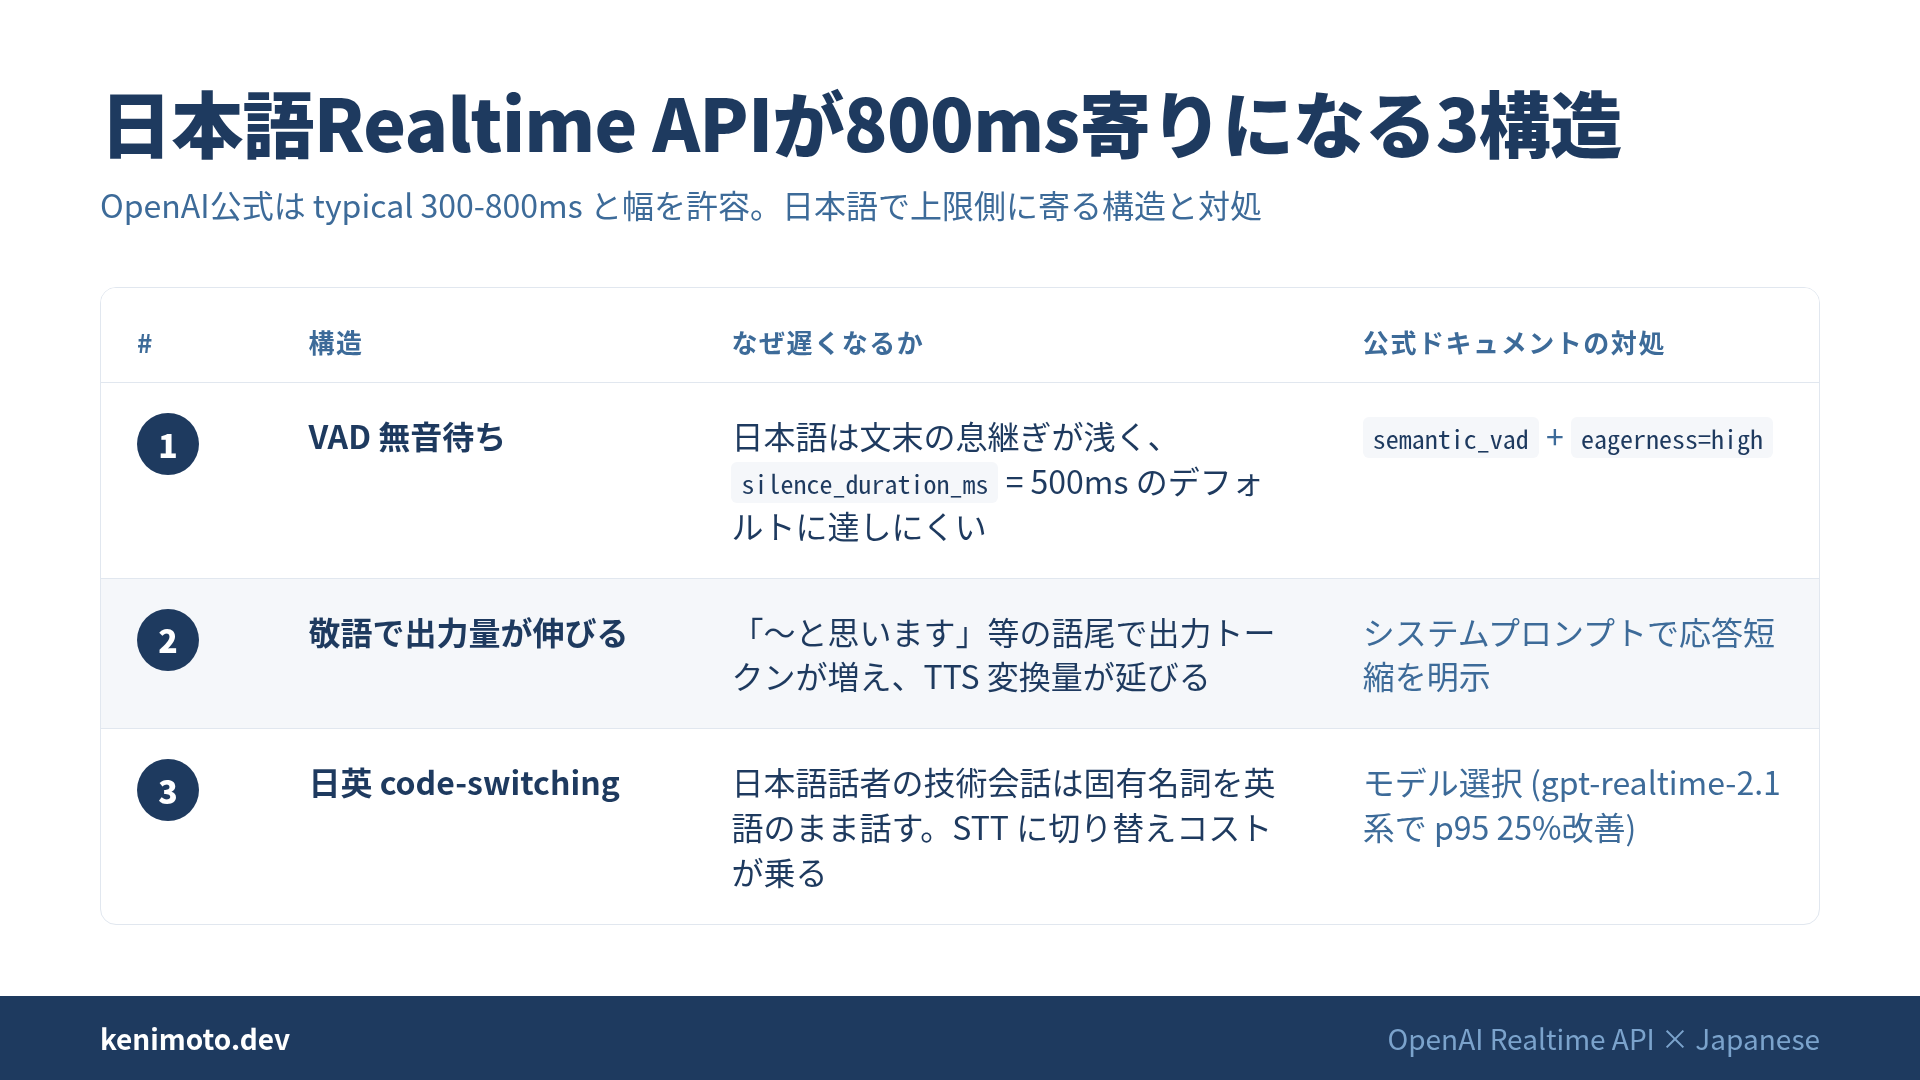
構造1: 発話終端の検出待ち
Realtime API の server_vad のデフォルトは公式ドキュメント上、silence_duration_ms が 500ms、prefix_padding_ms が 300ms です。ユーザーが話し終わってから 500ms の沈黙を検出して初めて応答生成に入ります。
日本語は文末で息継ぎのようなポーズが出にくい言語です。「〜と思います」まで一気に発話が続くので、無音が 500ms に達するまでの時間が英語より長く出ます。ここで発話終端の検出そのものが後ろに寄る、というのが構造として直感的です。数値の再現実験は公開データに乏しく、私も独自ベンチマークは持ちません。ただし言語構造の違いに起因する差はゼロにはなりません。
構造2: 敬語で出力トークンが増える
日本語の丁寧体は語尾が長くなります。「そうです」より「そのように認識しております」のほうを LLM が選びがちです。出力トークン数が増えれば、first token 以降の TTS 変換量も比例して増えます。
TTFB (最初の1バイトが返るまで) は影響を受けませんが、「ユーザーが AI の発話終端を聞くまで」の体感は延びます。300ms で最初の音が返っても、続きの音声が長く伸びると次のターンが遅れる。会話のテンポ全体が沈みます。
構造3: 日本語+英語のcode-switching
日本語話者が話す技術会話は、固有名詞を英語のままにする場面が多い言語です。「Realtime API を叩くと」「WebRTC で繋いだ」「gpt-realtime-2.1-mini が」— この混在は STT にとって切り替えコストを伴います。
Deepgram の Nova-3 が「Multilingual Keyterm Prompting」を打ち出したのは、この混在に対する明示的な対策です。Realtime API 内部の STT は非公開ですが、日本語+英語のコード切替が精度と遅延の両方に効くのは STT 一般の課題として広く知られています。
公式ドキュメントに存在する対処3つ
設計として直せる順に3つ書きます。数字はいずれも OpenAI 公式ドキュメントに書かれているパラメータで、私の独自実験の主張ではありません。
対処1: semantic_vad + eagerness
server_vad を semantic_vad に切り替えると、eagerness パラメータで割り込みの積極性を “low” / “medium” / “high” / “auto” から選べます。日本語で語尾の沈黙が出にくい問題には “high” が刺さります。
セマンティック VAD は音声だけでなく発話内容から終端を推測するため、「〜と思います」の後に「。」が来ることを認識して待たずに応答に入ります。ただし早すぎる割り込みで会話が壊れやすい副作用があるので、interrupt_response の設計は別途詰めます。
対処2: silence_duration_ms を短くする
server_vad を維持したまま silence_duration_ms を 500ms から 300ms 前後に落とす方法もあります。ドキュメントには次のように書かれています。
“With shorter values the model will respond more quickly, but may jump in on short pauses from the user.”
短いと反応が速いが、ユーザーの息継ぎに割り込む。日本語では特にこのリスクが大きいので、下げるなら 300-400ms までが穏当な範囲です。ゼロにはできません。私が最初に触ろうとした「post_padding」というパラメータは、実は Realtime API には存在しませんでした。ドキュメントを読み直して気付いた失敗です。server_vad の検出パラメータは threshold / prefix_padding_ms / silence_duration_ms の3つ (これに応答制御用の create_response / interrupt_response が加わる)。
対処3: システムプロンプトで応答短縮を明示
構造2 (敬語で出力が伸びる) には、システムプロンプトで「短く答えて」を明示するのが素直な対処です。
あなたは音声アシスタントです。応答は1文40字以内、
最大2文で完結させてください。
「〜と思います」「〜となります」等の冗長な語尾を避け、
「〜です」「〜します」で切ってください。
これで出力トークン数が減り、TTS の生成量が下がり、次のターンまでの待ち時間が縮みます。gpt-realtime-2.1 系は 2.1-mini を含めて p95 レイテンシが 25% 改善したと公式アナウンスに書かれているので、モデル選択で戻せる余地もあります。音声は marin か cedar が公式推奨です。
300ms 側に寄せた設計の考え方
3つを同時に打ち込むと、日本語でも Realtime API の応答は 300ms 側に近づきます。ただし 200ms を切ることは Realtime API のアーキテクチャ上、期待できません。人間の会話ターン中央値は 200ms (Stivers et al. 2009, PNAS) なので、統合モデルでも「人間より遅い」領域からは出られない構造です。
書籍で扱った voice AI の3つの崖 200/300/800ms の記事では、300ms を「AI が機械っぽい/自然の境界」に位置付けました。日本語 Realtime API の設計目標としては、800ms → 400ms が現実的な着地点です。300ms 未満はカスケードを刻んでエッジで動かす別戦略が必要になります。
まとめ
- OpenAI Realtime API のレイテンシは公式が typical 300-800ms と幅を持たせている。800ms 側は「デフォルトのままの結果」
- 日本語で上限側に寄る構造は3つ: 語尾の無音が出にくい / 敬語で出力が長い / 日英 code-switching
- 対処は公式ドキュメントに揃っている: semantic_vad + eagerness=high / silence_duration_ms を 300-400ms に / システムプロンプトで短縮指示
post_paddingというパラメータは存在しない。server_vadの検出パラメータはthreshold/prefix_padding_ms/silence_duration_msの3つ (これに応答制御用のcreate_response/interrupt_responseが加わる)
Realtime API を日本語で叩く場合、まず何もしないと 800ms 側に着地しやすい構造がある、と理解した上でパラメータを触るのが早道です。実装しながら barge-in 実装で認識精度が 22% 落ちる話 と組で読むと、VAD の閾値を触ることの副作用まで含めて設計できます。
本記事の設計視点は書籍 voice AI 300msのUX設計 第5章「レイテンシの解剖」と第6章「TTFB」の考え方を、日本語 Realtime API の場合に絞って書き出したものです。
参考文献
- OpenAI. “Realtime API — Voice activity detection (VAD).” developers.openai.com. 2026年9月参照
- OpenAI. “Realtime API — Managing conversations.” developers.openai.com. 2026年9月参照
- OpenAI Developers Blog. “How to Build a Live Translation Voice Agent with OpenAI’s GPT Realtime API.” 2026
- Deepgram. “Nova-3 Multilingual Keyterm Prompting.” deepgram.com/learn. 2026
- Cartesia. “Sonic 3.6 documentation.” docs.cartesia.ai. 2026年9月参照
 関連書籍 音声AIの300ms 音声AI レイテンシ 設計 | Pipecat・LiveKit・Deepgram で525msの壁を突破 書籍ページを見る →
この記事は役に立ちましたか?