Jevとは?話題の理由5つとLLM判定との差
9月15日に公開されたJevというAIモデルが、開発者のあいだで話題になっています。文章を一文字も書かず、「バグ報告: 92%」のような判定と確率だけを返すモデルです。
最初に紹介記事を読んだとき、私は「それはLLM as a judgeで前からやっていたのでは」と思いました。選択肢を決めてLLMに選ばせ、確率も取る。評価パイプラインでは珍しくない構成です。何が新しくて何が新しくないのか。新しくないなら、なぜこれほど話題になったのか。公開情報を集めて確かめました。
Jevとは: 文章を書かず、型と確率を返すモデル
Jevは、米サンフランシスコのTypeSafe AIが2026年9月15日にearly accessで公開したモデルです (Wikipedia)。TypeSafe自身は「System One model」と呼んでいます。Kahnemanの「速い思考(System 1)」から取った名前です。LLMを置き換えるものとは説明されておらず、LLMの周りで大量に発生する小さな判断を、速く安く片付ける層という位置づけです。
使い方は、判断材料 (state) と質問のセット (questions) を渡すだけです。質問の型は3つあります (flaviocopes.com)。
| 型 | 返すもの | 例 |
|---|---|---|
noul | yes/noの確率 (0〜1) | このメールはフィッシングか |
choice | 最大255個の選択肢から1つと、各選択肢の確率 | 問い合わせは バグ / 要望 / 請求 のどれか |
score | 段階評価の確率分布と、その加重平均 | 深刻度は 軽微 / 回避策あり / ブロッキング のどこか |
公式が示している数字は次のとおりです (TypeSafe AI公式ブログ)。
- 料金: 入力 $0.042 / 100万トークン、出力は無料 (“too cheap to meter”)
- 応答: 70〜500ミリ秒
- 自社ワークフロー評価で、GPT-6 Astra と Claude Fable 5.1 に対して「193.6倍速く、444.6倍安い」
ただし、公式ブログはこの比較の条件も自分で書いています。比較に使ったワークフローは社内チームが作ったもので、LLM側は推論(reasoning)モードを切った状態です。ハルシネーション率「0%」の根拠は、出力が必ず決めた型に収まることです。判定が当たっているかどうかは、この数字に含まれていません。
「LLM as a judgeで前からやっていた」は半分正しい
仕組みを分解すると、Jevの3つの型はどれも既存の手法で作れます。
choice と noul は、LLMに選択肢だけを答えさせ、そのトークンの確率(logprobs)を読めば近いものが出ます。OpenAIのCookbookには、分類タスクでlogprobsを使い「分類や信頼度の閾値を設定できる」と書いた例がずっと前から載っています (OpenAI Cookbook: Using logprobs)。
score の「確率分布の加重平均」は、2023年のG-Evalとほぼ同じ発想です。G-Evalは、LLMが出した1〜5点のようなスコアをそのまま使わず、「出力スコアの確率で重み付けした和を最終スコアにする」方式を提案しています (Liu et al., 2023, arXiv:2303.16634)。
もっと遡れば、決まったラベルから選ぶだけならBERT系の分類器がずっと担ってきた仕事です。Towards Data Scienceの解説もこの点に触れ、違いは「ラベルが学習時に固定されず、プロンプトで自由に決められること」だと整理しています (Towards Data Science)。
では何が違うのか。公開情報から言える違いは2つです。
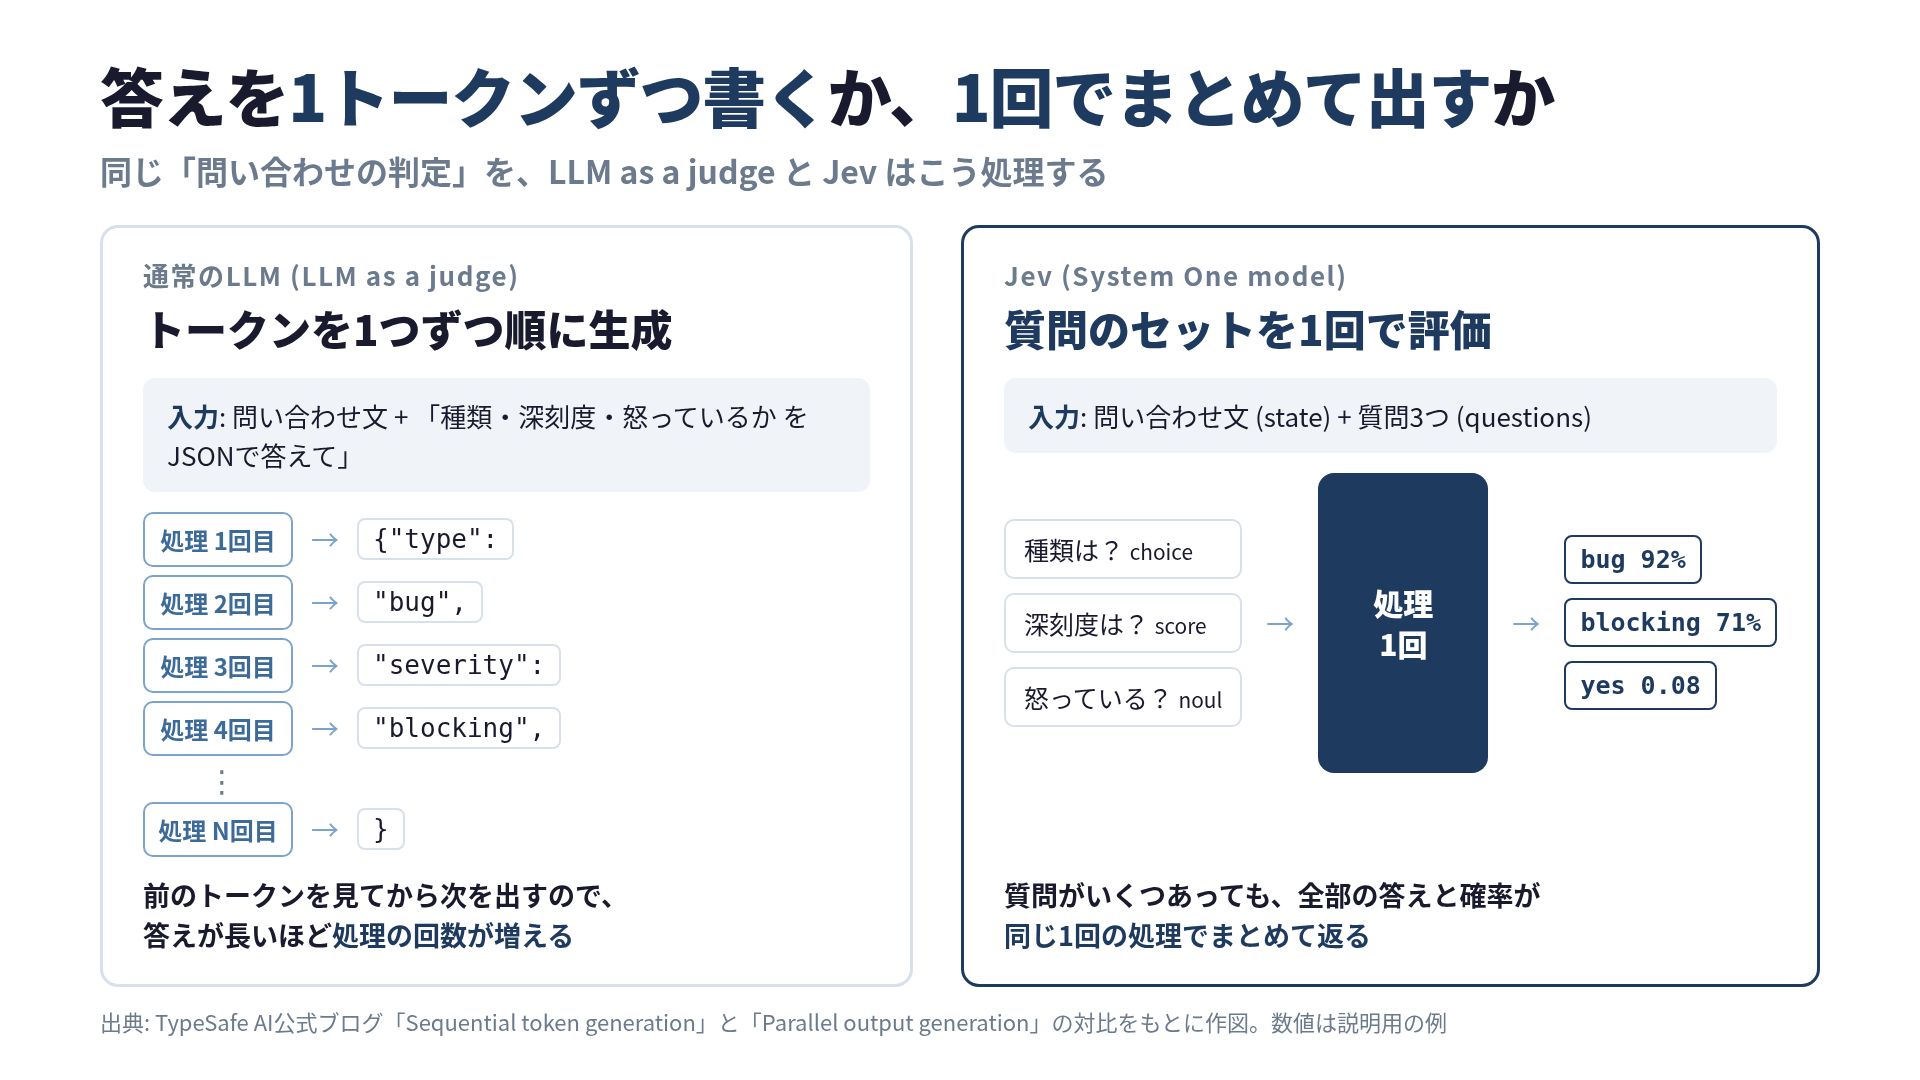
1つ目は処理の形です。LLMは答えをトークン単位で順に生成します。質問を3つまとめてJSONで答えさせても、{"type": "bug", と1トークン書くたびに処理を1回回すので、答えが長いほど処理の回数が増えます。Jevは質問のセットを1回の処理で並列に評価し、全部の答えと確率をまとめて返します (TypeSafe AI公式ブログ)。
2つ目は学習の目的です。TypeSafeはRLCD (Reinforcement Learning for Calibrated Decisions) と呼ぶ方法で、「90%と答えたら9割当たる」ように確率を合わせることを目的に学習させたと説明しています。学習データは合成データだけだそうです (Wikipedia)。LLMのlogprobsは、確率の当たり具合を目的に調整されたものではありません。
つまり、やっていることは「LLM as a judge」を判定専用に削ったもので、新しい種類のAIというほどの飛躍ではありません。ただし、2つ目の「確率が当たるように作った」という主張が本当なら、それは実用上かなり大きな差になります。次の節で、そこを検証した人たちの結果を見ます。
独立検証が示した弱点
公開から1週間で、Jevを外から検証した結果がいくつか出ています。
1問で聞くとHaikuに負ける
Rajesh Beri氏は、2,000件のメール(半分がフィッシング)でJevとClaude Haiku 4.5を比べています (BERI, 2026-09-20)。
| 条件 | Jev | Haiku 4.5 |
|---|---|---|
| 「フィッシングか」を1問で聞く | 62.6% | 81.3% |
| 5つの狭い質問に分け、1,000件のラベルで重みを学習し、残り1,000件で評価 | 95.0% | 93.2% |
1問で聞くと、Jevはフィッシングの43.2%を見逃しています。質問を分解して重みを合わせると逆転しますが、差は統計的に有意ではありません (p = 0.063)。Beri氏の結論は短く、「95%はJevの成績ではない。Jevと、あなたのラベル付きデータと、あなたが保守する回帰モデルの合計だ」と書いています。
知らないルールでは確率が外れる
もう1つは、確率の当たり具合を測ったリポジトリです (scienthoon/jev-ood-calibration)。学習データに入っていそうな公開ベンチマーク3つと、ルールから自動生成したサポートチケット900件を比べています。
| データ | 正解率 | ECE (確率のズレ。0に近いほど良い) |
|---|---|---|
| OpenBookQA | 94.2% | 0.024 |
| CommonsenseQA | 88.1% | 0.032 |
| HellaSwag | 86.1% | 0.029 |
| 自作チケット900件 (全体) | 75.1% | 0.107 |
公開ベンチマークでは、確率はほとんど補正がいらないほど当たっています。ところが自作ルールのチケットではECEが偶然のばらつき(0.024)の4.4倍に広がり、しかも型によってズレの向きが逆でした。choice と score は自信過剰、noul は自信不足です。優先度を当てる score 型は正解率44.7%で、しかも強く自信過剰でした。
2つの検証を合わせると、Jevの弱点はこうまとめられます。一般常識で判断できる問題では強い。一方、「自社のルールでは優先度をどう付けるか」のように、学習データから知りようがない判定では、知らないことを知らないまま高い確率を返します。現場で任せたい判定は、ほとんどが後者です。
公開価格で1件あたりの費用を計算した
速度と精度は自分で測っていませんが、費用は公開価格から計算できます。公式の「444.6倍安い」はフロンティアモデルとの比較なので、判定に実際に使われがちな安いモデルと比べ直しました。
条件は、サポートチケット1件を約300トークンとし、両方に同じ300トークンを入力するものとします。Haikuにはラベルだけを返させ、出力を5トークンと仮定します。Haiku 4.5の価格は入力$1、出力$5 (100万トークンあたり) です (Claude pricing)。
| 入力 | 出力 | 1件 | 100万件 | |
|---|---|---|---|---|
| Jev | 300 × $0.042/M = $0.0000126 | 無料 | $0.0000126 | 約$12.6 |
| Claude Haiku 4.5 | 300 × $1/M = $0.0003 | 5 × $5/M = $0.000025 | $0.000325 | 約$325 |
差は約26倍です。
公式の444.6倍から1桁以上縮みます。それでも100万件で$325と$12.6の差は小さくありません。
この差が効くのはエージェントです。エージェントのループでは、1回のタスクの中で「このツールを呼ぶべきか」「この出力は完了条件を満たすか」「この操作は危険か」を何度も判定します。1ステップごとに判定を挟めば、呼び出し回数はタスク数の何倍にも膨らみます。LLM as a judgeは「重要なところで1回呼ぶ」ものでしたが、この価格なら「全ステップに挟む」設計が現実的になります。
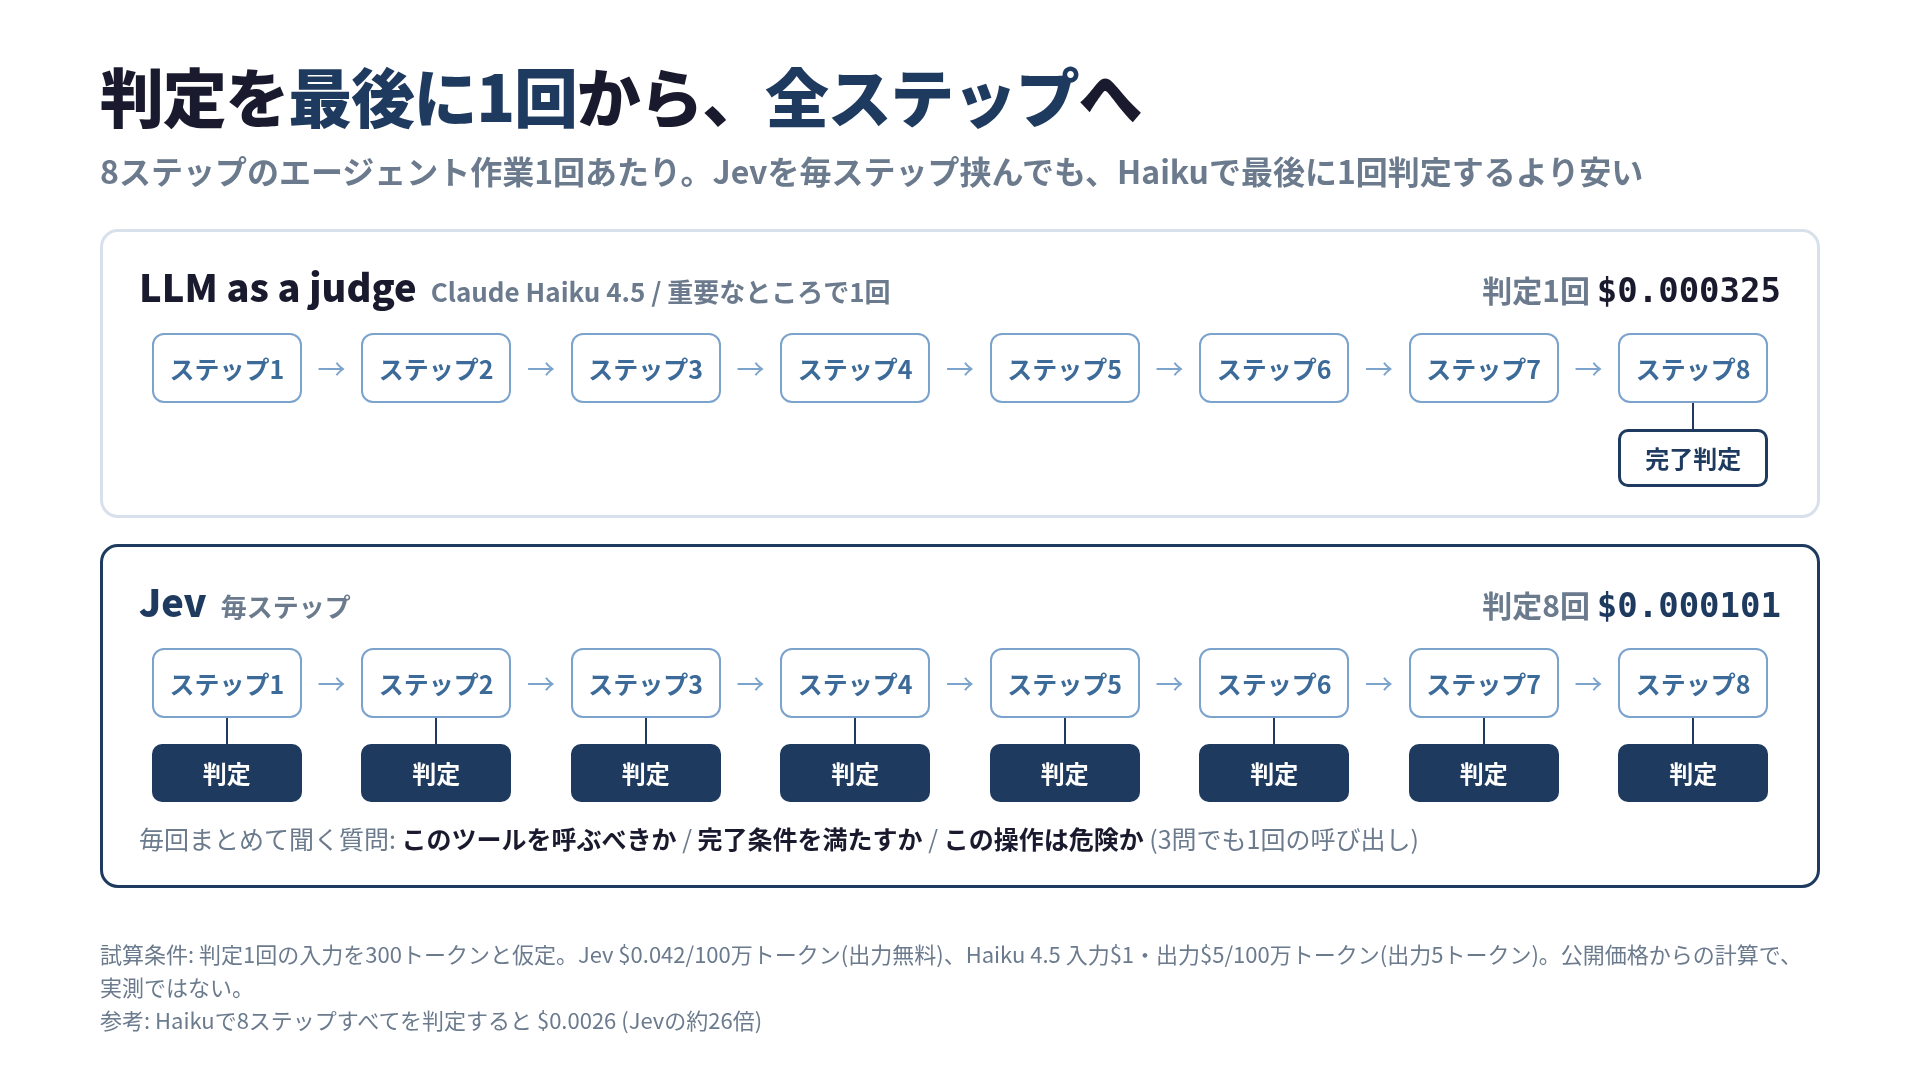
8ステップの作業で考えると、Jevを毎ステップ挟んだ8回分 ($0.000101) のほうが、Haikuで最後に1回だけ判定する費用 ($0.000325) より安くなります。どちらも入力300トークンと仮定した計算です。
なぜ話題になったのか: 5つの理由
ここからは私の推測です。技術の新しさは前の節までで見たとおり限定的です。それでも話題になった理由を、公開情報から5つ挙げます。
1. 価格と速度の桁が変わった
前の節の計算のとおり、安いLLMと比べても1桁以上安くなります。同じことをするにしても、桁が変わると使える場面が変わります。技術としては同じでも、使う側にとっては新しいものに見えます。
2. エージェントブームと重なった
判定を大量に呼ぶ需要は、公開の時点ですでにありました。コミュニティの作例をまとめた一覧 awesome-jev (33件収録) やからあげ氏のまとめ (Zenn) を見ると、エージェントの評価役、ゲームの手の選択、会話の振り分けなど、ループの中で何度も呼ぶ使い方が目立ちます。
3. 分類器を「新しい種類のAI」として命名した
「System One model」という名前と、「文章を書かないAI」「スマートなif文」という言い方が効いています。中身は確率つきの分類なのに、名前を付けたことで既存のLLMとは別カテゴリのものとして語られるようになりました。ITmediaの見出しも「“文章を書かないAI”がなぜ話題に?」です (ITmedia AI+)。
4. 創業者の経歴と資金調達
CEOのDiogo Almeida氏は、ChatGPTの前身となったInstructGPT論文の共著者です (arXiv:2203.02155)。公開と同じ日に、DCVCがリードする4,000万ドルのシード調達も発表されています (Wikipedia)。発表投稿は初日に2,500万回表示され、Hacker Newsでは1,900ポイントを集めたと報じられています (AI新聞)。
5. 初日から配信網に乗り、作例を募集された
私がいちばん大きいと思うのはこれです。Jevは公開当日から、VercelのAI GatewayとOpenRouterで呼べました。Vercelは3日後のブログで、Jevが公開から24時間で「過去のどのモデルの公開よりも2倍以上多い有料チーム」に使われ、24時間目には有料チームの約13%が使っていたと書いています (Vercel blog, 2026-09-18)。
OpenRouterは9月21日に、コミュニティに「速くて安い判定を使った、いちばん面白いプロジェクト」を募集し、Jev自身に5件の受賞作を選ばせたと投稿しています (OpenRouter on X)。
公開直後に作例が一気に出た背景には、少なくとも一部、配信プラットフォームが作例を募った事情があります。開発者が自然に群がったように見える現象の一部は、ローンチの設計で作られたものです。
これを批判するつもりはありません。$5分の無料クレジット(ITmedia AI+によれば9月19日時点でウェイトリスト登録から半日ほどで付与)、初日から使える2つのゲートウェイ、そして作例コンテストという組み合わせは、開発者向けプロダクトのローンチとしてかなりよくできていて、私が同じ立場でも真似したいと思う設計です。
使いどころ: Jevで足りる判定、LLMに残す判定
公開情報から線を引くと、こうなります。
Jevに向く判定
- 一般常識で答えが決まる判定 (この文は怒っているか、この問い合わせはどの窓口か)
- 呼び出し回数が多く、1件の費用と遅延が効く場所 (エージェントの毎ステップ、全件スキャン)
- ラベル付きの過去データがあり、質問ごとに確率を補正できる判定
LLMに残す判定
- 自社固有のルールに依存し、正解データがまだ無い判定
- 理由の説明が必要な判定 (Jevは理由を書けません)
- 数を数える、日付を比べる、否定を含む判定 (公式ドキュメントを基にした解説で苦手な領域として挙げられています。flaviocopes.com)
私が検討している使い方: どのLLMに回すかの振り分け
私はJevを、タスクをどのモデルに回すかの振り分けに使えないか検討しています。フロンティアモデルに回すか、手元のローカルLLM(Qwen系など)で済ませるか、という判断です。振り分けは全リクエストの前に毎回挟むので、振り分け役自体が遅かったり高かったりすると、節約した分を食ってしまいます。そこでJevの速さと安さが効きます。強いモデルと弱いモデルを小さなルーターで振り分ける発想自体は、RouteLLM (2024) などで研究されてきたものです (Ong et al., arXiv:2406.18665)。
ただし、「どのモデルに回すべきか」をJevにそのまま聞くつもりはありません。手元のローカルモデルが日本語の要約をどこまでこなせるかは、Jevの学習データからは知りようがないからです。独立検証で確率が外れたのは、まさにこの種類の判定でした。
そこで、判定を2段に分けて考えています。
- 1段目 (Jev): タスクの性質を聞く。コードを書く必要があるか (
noul)、推論はどのくらい難しいか (score)、長い文脈が要るか - 2段目 (自分の表): 性質からモデルへの対応は、手元で測った結果をもとに自分で決める
一般常識で決まる部分はJevに任せて、自分の環境の事情はルールとデータで持つ、という分け方です。
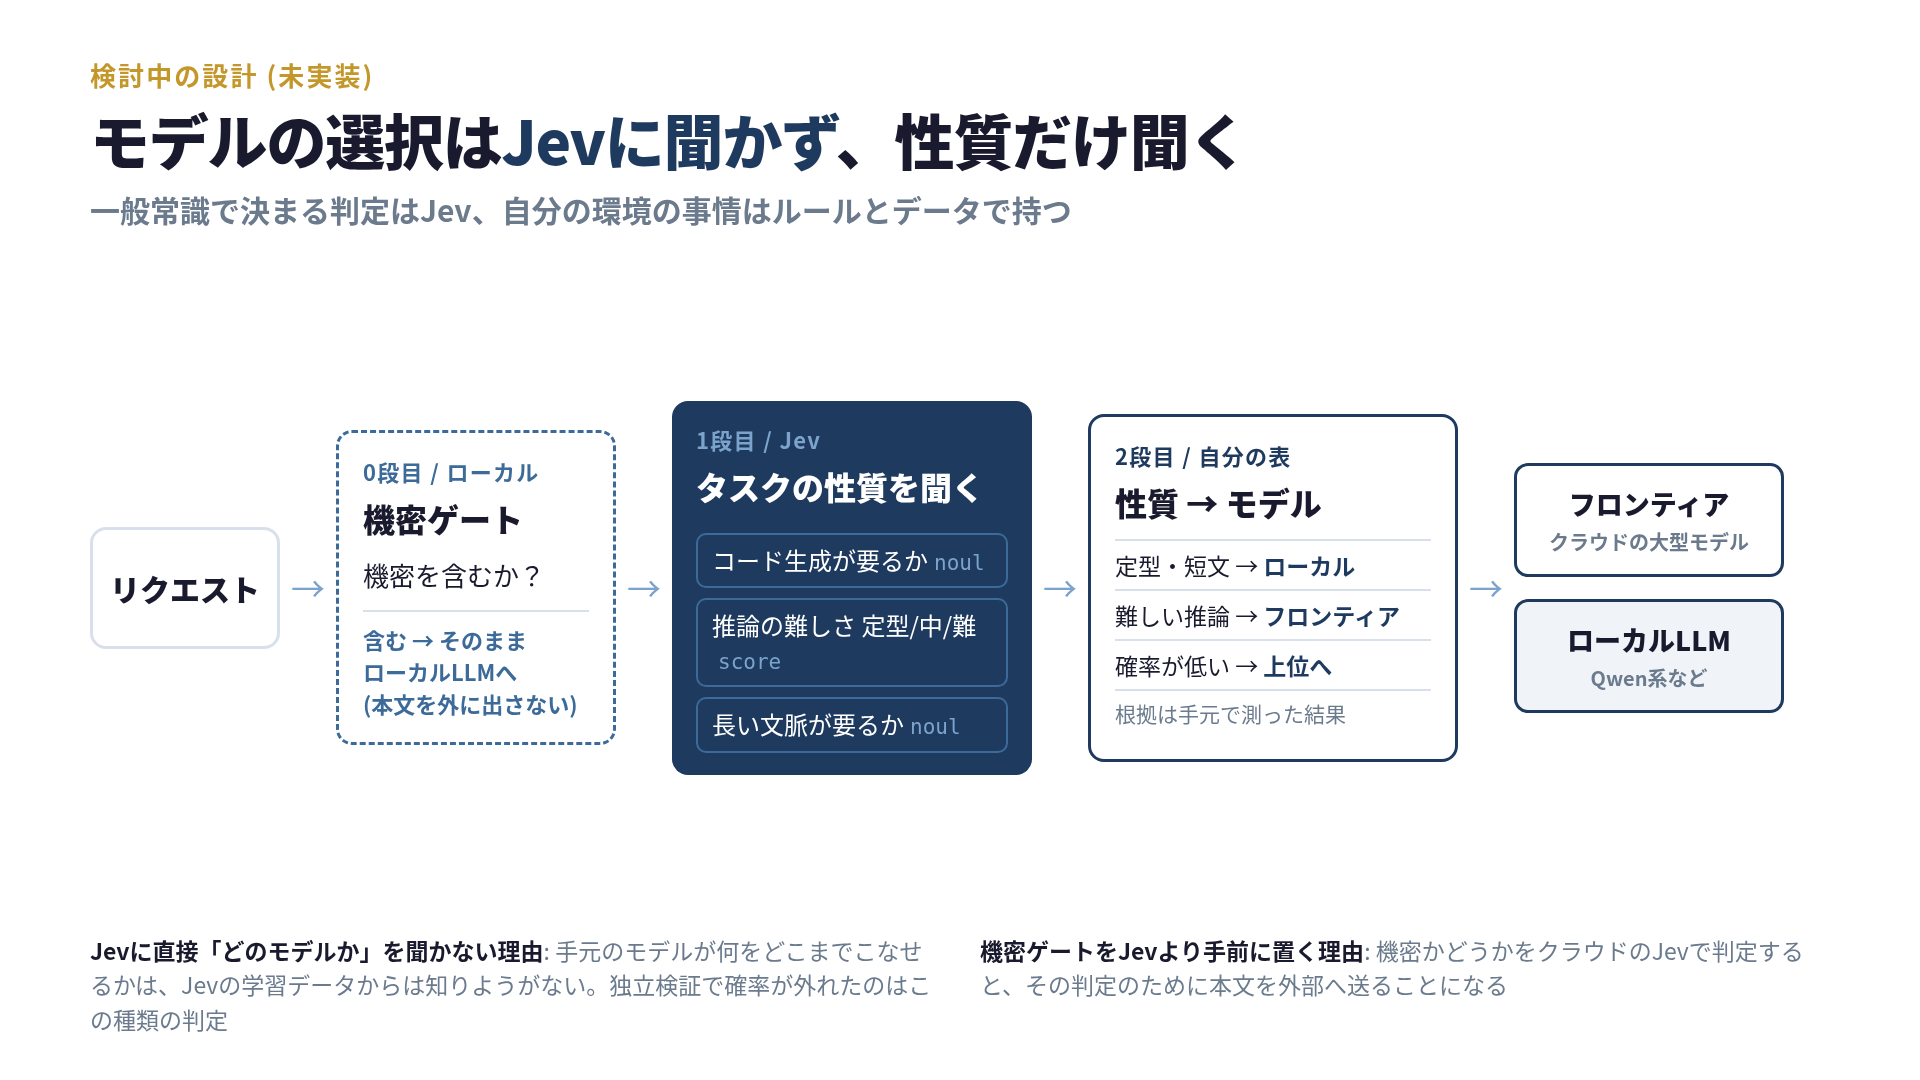
1つだけ、Jevを使えない振り分けがあります。「機密を含むのでローカルに回す」という判定をクラウドのJevに任せると、判定のために機密の本文を外部に送ることになります。機密かどうかの判定だけは、Jevより手前にローカルで置く必要があります。
Beri氏の検証が示すとおり、Jevの本当の性能は「質問をどう分けるか」と「自分のデータで確率を補正するか」で決まります。導入するなら、まずはLLM判定の横でJevを並走させ、ログを貯めて、質問ごとに当たり具合を見てから置き換えるのが安全です。
まとめ
- Jevは、文章を書かずに型と確率だけを返す判定専用のモデル
- やっていることはLLM as a judge、G-Eval、分類器の延長で、仕組みとしての飛躍は小さい
- 違いは「確率が当たるように学習した」という主張と、価格・速度の桁。公開価格で計算すると、Haiku 4.5より約26倍安い
- 独立検証では、1問で聞くとHaikuに負け、知らないルールでは確率が外れる。95%は「Jev+ラベル付きデータ+補正」の成績
- 話題になった理由は、価格の桁、エージェントブーム、命名、創業者の経歴、そして初日からの配信網と作例募集というローンチ設計の組み合わせ
「前からやっていた」という最初の感想は、技術としては正しかったと思います。ただ、判定1件の費用が1桁下がったことで、エージェントの全ステップに判定を挟む設計が現実的になりました。そこは本当に変わった点です。
参考資料
- Introducing System One Models & Jev - TypeSafe AI Blog
- Jev (AI model) - Wikipedia
- A deep dive into Jev, TypeSafe’s System One model - flaviocopes.com
- TypeSafe’s Jev Scores 62.6% Asked Once and 95% Split Five Ways - BERI
- scienthoon/jev-ood-calibration - GitHub
- Liu et al. (2023) G-Eval: NLG Evaluation using GPT-4 with Better Human Alignment - arXiv:2303.16634
- Ong et al. (2024) RouteLLM: Learning to Route LLMs with Preference Data - arXiv:2406.18665
- Ouyang et al. (2022) Training language models to follow instructions with human feedback - arXiv:2203.02155
- Using logprobs - OpenAI Cookbook
- Jev vs. LLMs - Towards Data Science
- Jev launch on AI Gateway - Vercel
- OpenRouter on X (2026-09-21)
- 「Jev」とは “文章を書かないAI”がなぜ話題に? - ITmedia AI+
- 「しゃべらないAI」に開発者が殺到 - AI新聞
- 高速判断AI Jevのユースケースとオープン実装を雑にまとめる - Zenn
関連
- Claude Code・Cursor・Codex併用で1日の判断を400回から40回にした、ハーネス3層設計の実測 (Hooksで自動承認を入れた話。Jevのような安い判定器を差し込む候補の場所です)
 関連書籍 ローカルLLMで足りる仕事、Claude Codeに任せる仕事 依頼の96%はローカルに回せなかった。1ステップずつに下ろすと、半分が回せた 書籍ページを見る →
この記事は役に立ちましたか?