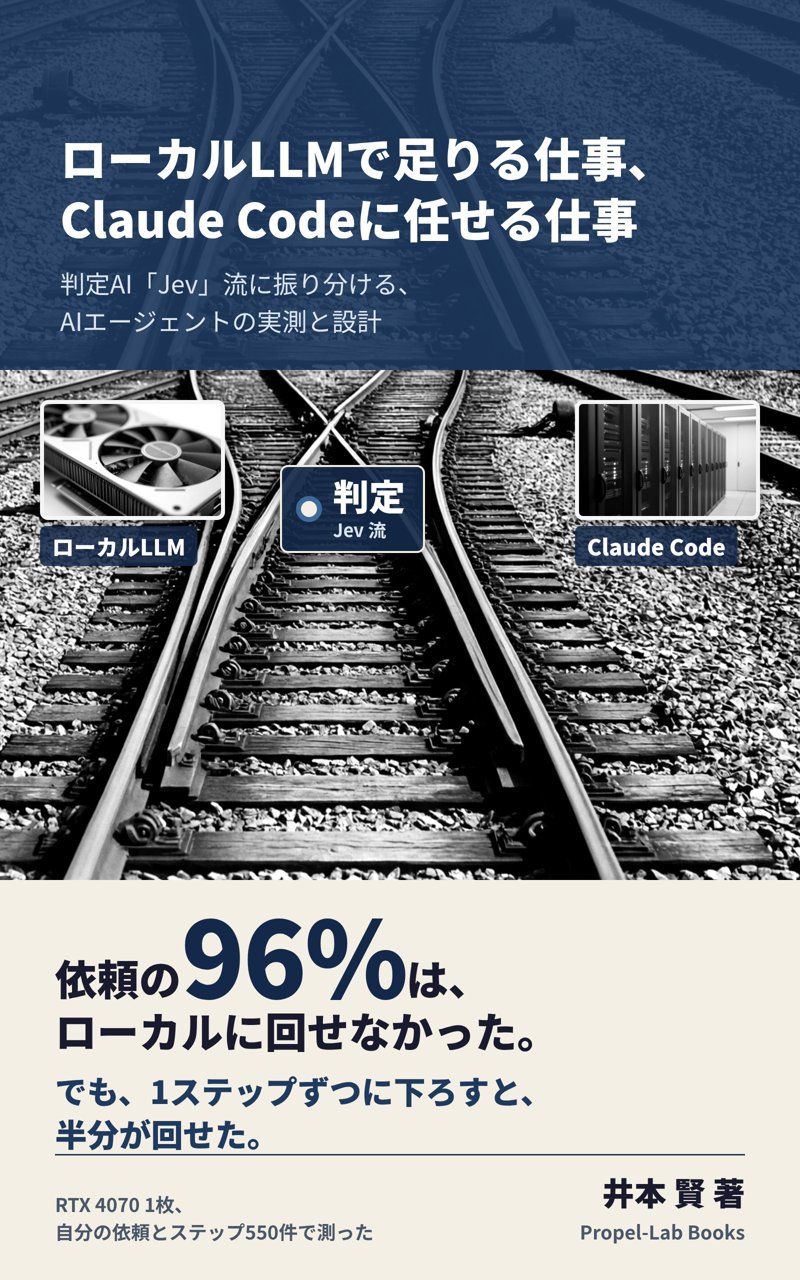
ローカルLLMで足りる仕事、Claude Codeに任せる仕事
判定AI「Jev」流に振り分ける、AIエージェントの実測と設計
依頼の96%はローカルに回せなかった。1ステップずつに下ろすと、半分が回せた
ローカルLLMシリーズの【振り分け・設計編】何を手元に任せるかを決める側
Zenn累計32,000+ views · 4言語で30冊以上出版 · Kindle 6カ国で販売中
他の言語版: English
本書の概要
Claude CodeとローカルLLMの併用を実測。依頼単位では96%回せず、1ステップずつなら半分。Ollamaの振り分け・機密の門番・しきい値を扱う本。
この本でできるようになること
- 自分の依頼とステップを数え、どこまでローカルLLMに回せるかを見積もれる
- 「WebFetch ならローカル」のような種類のルールで大半を振り分け、確率の判定は残りだけに使える
- Ollama の logprobs で判定の確率を取り出し、黙って確率が消える3つの罠を避けられる
- 0.5 ではなく自分のデータでしきい値を引き、機密の見逃しを20件から2件に減らせる
- 作業役の戻り値を型で返し、段取り役の読み直しで費用が膨らむのを防げる
対象読者
- 【Claude Code ユーザー】AIエージェントの費用を、ローカルLLMに回して下げたい人
- 【セキュリティ担当】社外に出せない情報を扱うため、ローカルLLMを門番に置きたい人
- 【ローカルLLM派】Ollama や qwen を動かしたあと、何に使うかで止まっている人
- 【エージェント開発者】段取り役と作業役に分けた構成の費用を、実測で判断したい人
- 【計測に慎重な人】LLMの判定を確率で扱い、しきい値を自分で決めたい人
この本で解決できる悩み
- ローカルLLMを動かしたが、Claude Code の作業のどこを任せればいいか分からない
- 依頼ごとに振り分けようとすると、ほとんどがクラウド行きになってしまう
- ローカルLLMの判定を 0.5 で切ると、機密を平気で通してしまう
- 社外に出せない情報を、クラウドのエージェントに渡す前に止めたい
- 無料のローカルモデルを足したのに、クラウドの請求が増えた
- Jev が話題だが、手元で同じことができるのか分からない
この本の立ち位置
- 実測寄り (著者の依頼・ステップ550件と、架空の値の評価セット324件で測った)
- 振り分け特化 (ローカルLLMの速度や導入手順ではなく、何を任せるかを扱う)
- 中級者向け (Claude Code と Ollama を使ったことがある前提)
- 設計まで通し (数える→決める→止める→戻す→最後の設計図)
なぜこの本か
- 依頼単位で96%が回せなかった失敗から始め、ステップ単位に下ろす理由を数字で示す
- 9Bの確率より1行のルールが正確だった結果から、「決まる部分はルールで、残りだけ確率で」を組み立てる
- 0.5 ではなく自分のデータで線を引く手順を、ワークシートとして持ち帰れる
- 日本の個人情報 (マイナンバーの検算、口座、住所) を拾う正規表現を掲載
- 無料のローカルLLMを作業役にしたら一番高くついた実験と、戻り値の設計での直し方
- 付属コードを GitHub で公開 (MIT)
他のAI本との違い
| 比較対象 | 本書の違い |
|---|---|
| ローカルLLMの入門書・環境構築書 | 入門書は動かすところまで。本書は動かしたあと、Claude Code の作業のどこをローカルに任せるかを実測で決める |
| Jev の公式ドキュメント・紹介記事 | 公式は Jev の API の使い方。本書は同じ型と確率の判定をローカルLLMで作り、公式の数字とその留保を読み直す |
| LLMルーティングの論文 (RouteLLM など) | 論文は公開ベンチマークでの依頼単位の振り分け。本書は自分の依頼とステップで測り、ステップ単位のルールと確率を組み合わせる |
目次
導入: 門番がパスワードを通した
ローカルLLMの判定を、確率として読み、そのまま信じない
- はじめに
- この本が扱うこと
- この本が扱わないこと
- 対象読者
- 測った環境
- 読み方
- 賞味期限について
- 序章 本番DBのパスワード入りのメモを、AIは69%の自信で「問題なし」と判定した
- 機密を外に出さないための門番だったはずが
- 並び順は完璧だった
- 確率をそのまま信じない
- この本で測ったもの
- 本書の地図
第1部 何をローカルに任せるか
依頼単位ではほぼ回せず、ステップ単位なら半分が回せる
- 01 第1章 私の依頼の96%はローカルに回せなかった
- 1-1 何を測ろうとしていたか
- 1-2 100件の作り方
- 1-3 結果
- 1-4 生の指示でも同じだった
- 1-5 なぜこうなったのか
- 1-6 機密の4件はどうだったか
- 1-7 依頼単位の振り分けは、材料を持っていない
- 02 第2章 ステップに下ろすと半分が回せる
- 2-1 ステップを数える
- 2-2 結果: 200件中97件がローカルで足りる
- 2-3 定型プロンプトは例外だった
- 2-4 Claude Code は、すでにステップを振り分けている
- 2-5 LLMが要らないステップもある
- 2-6 あなたのログを数える
- 03 第3章 決まる部分はルールで、残りだけ確率で
- 3-1 確率で聞いた振り分け器
- 3-2 結果
- 3-3 確率は何を当てていたのか
- 3-4 決まる部分はルールで
- 3-5 機密の門番も同じ形になる
- 3-6 私の3層
第2部 判定だけを返すAI
型と確率で答える Jev の考え方と、そのオープン実装
- 04 第4章 Jevは何を変えたのか: 型と確率で答える
- 4-1 文章を返さず、型と確率を返す
- 4-2 公式の数字と、公式自身の留保
- 4-3 安いモデルと比べ直すと
- 4-4 LLMでも同じことはできる
- 4-5 Jev の公式パターンも「決まる部分はルールで」だった
- 4-6 本書での Jev の位置
- 05 第5章 公開2週間で24実装: オープン実装と独立検証の読み方
- 5-1 Jev の中身は公開されていない
- 5-2 24本は、3つの作り方に分かれる
- 5-3 rizzo-flow を RTX 4070 で動かす
- 5-4 独立検証の数字を読む
- 5-5 独立検証から持ち帰るもの
第3部 ローカルで確率を取り出す
logprobs、モデルの大きさ、しきい値の決め方
- 06 第6章 logprobsの取り出し方と、黙って消える3つの罠
- 6-1 logprobs とは何か
- 6-2 1文字で答えさせ、その1文字の確率を読む
- 6-3 罠1: OpenAI 互換の API では、確率が黙って消える
- 6-4 罠2: 考えるモデルは、最初のトークンで答えない
- 6-5 罠3: 候補が上位20件に入らないと、確率は0に見える
- 6-6 ほかのランタイムでも考え方は同じ
- 6-7 確率は確信の度合いで、正しさではない
- 6-8 最初の1問で確かめること
- 07 第7章 何Bあれば足りるか
- 7-1 同じ60件、同じ質問で、モデルだけを替える
- 7-2 読み取れること
- 7-3 判定の中身が変わると、順位も変わる
- 7-4 私の選び方
- 08 第8章 しきい値は0.5とは限らない
- 8-1 並び順と目盛りは、別の性質
- 8-2 線の位置は、何を一番避けたいかで決まる
- 8-3 線の引き方: 見逃しを0にする一番高い線
- 8-4 見逃し0の線でも、新しい機密は漏れる
- 8-5 余裕を持たせる
- 8-6 集めるべきは、件数より機密の数
- 8-7 ワークシート: 線を引く
第4部 機密を外に出さない
正規表現とモデルの分担、そして自分にとっての機密
- 09 第9章 名札を付けて歩いてくる秘密は正規表現で止める
- 9-1 形の決まった秘密は、名札を付けて歩いてくる
- 9-2 最初の実験では、名札が読めなかった
- 9-3 gitleaks が止めたもの、止めなかったもの
- 9-4 日本の個人情報を、形と検算で拾う
- 9-5 誤検知は、名札の偽物から来る
- 9-6 この章で持ち帰るもの
- 10 第10章 モデルは定義に書いたものしか止めない
- 10-1 正規表現の漏れを、モデルで拾う
- 10-2 モデル単体で見逃し0を狙うと
- 10-3 本物の機密は、評価セットの機密と違った
- 10-4 定義を、自分の機密に書き換える
- 10-5 名札のない機密は、モデル単体では守れない
- 10-6 あなたの機密を書き出す
第5部 振り分けた後、どう戻すか
戻り値の設計と運用、そして最後に残った設計図
- 11 第11章 無料のexecutorが一番高くついた
- 11-1 実験: 強いモデルが段取り、安いモデルが手を動かす
- 11-2 結果: 無料の作業役を足した構成が、どのタスクでも一番高い
- 11-3 なぜ無料が一番高いのか
- 11-4 Claude Code で追試する
- 11-5 戻り値は、振り分けの一部
- 12 第12章 戻り値を型で返す
- 12-1 3つの返し方を比べる
- 12-2 結果: 短いタスクでは効き、長いタスクでは効かない
- 12-3 型には「何をしたか」が入っていなかった
- 12-4 何を返させるか
- 13 第13章 運用: 同居と待ち時間と、線の引き直し
- 13-1 GPU は1枚しかない
- 13-2 タイムアウトは起きるものとして書く
- 13-3 後片付けをしないローカルの作業者
- 13-4 定義を変えたら、線を引き直す
- 13-5 記録しておくもの
- 13-6 運用のチェックリスト
- 14 第14章 最後に残った設計図
- 14-1 最初の設計図と、最後の設計図
- 14-2 流れ
- 14-3 入口の門番
- 14-4 分ける
- 14-5 種類のルール
- 14-6 確率の判定
- 14-7 実行
- 14-8 戻り値
- 14-9 設定ファイルにすると
- 14-10 あなたの環境に移す順番
依頼を丸ごとローカルLLMに回そうとすると、ほとんど何も回せません。私の依頼を100件数えたら、96件がフロンティア行きでした。ところが Claude Code の作業を1ステップずつに下ろして数え直すと、200件のうち97件がローカルで足りました。
本書は、その振り分けを RTX 4070 1枚で組み立てた記録です。ステップの種類で決まる部分はルールで決め、残りだけローカルLLMの確率で決めます。機密は依頼を渡す前の入口で止め、ローカルに回した作業の結果は型で返させます。最後の第14章に、そのまま持ち帰れる設計図と設定ファイルの例をまとめました。
まとめ読み
ローカルLLMの本は、いま3冊あります。
シリーズ・関連書籍


関連記事で深掘りする
よくある質問
- 「ローカルLLMで足りる仕事、Claude Codeに任せる仕事」はどんな本ですか?
- Claude Code に頼む作業を、手元のローカルLLMとクラウドのフロンティアモデルにどう振り分けるかを、自分の依頼とステップ550件、RTX 4070 1枚で測った本です。依頼を丸ごと振り分けると96%がフロンティア行きでしたが、1ステップずつに下ろすと半分がローカルで足りました。ルールで決まる部分はルールで、残りだけローカルLLMの確率で決め、機密は入口で止め、戻り値は型で返す設計を、全14章と序章・終章でまとめています。
- Jev を使う本ですか?
- Jev (TypeSafe の判定AI) の API は使いません。Jev と同じく「文章を返さず、型と確率で答える」判定を、Ollama の logprobs を使って手元のローカルLLMで作ります。Jev そのものの考え方と、公式の数字の読み方、24本のオープン実装は第2部で扱います。
- どんな環境が必要ですか?
- 著者の環境は RTX 4070 (12GB) 1枚と Ollama です。判定役は qwen3.5:4b で足り、12GB あれば動きます。数字は著者の依頼から出たものなので、各章の手順で自分のデータに合わせて測り直す前提で書いています。
- コードは公開されていますか?
- 入口の門番 (正規表現と日本の個人情報ルール)、ローカルLLMの判定、しきい値を引く道具、ステップの振り分け、戻り値の型、架空の値で作った評価セットを、GitHub の local-step-router (MIT ライセンス) で公開しています。
- どこで購入できますか?
- Kindle 版 (Amazon、1,500円) のみです。KDP セレクトに登録しているので、Kindle Unlimited の読み放題対象です。
Kindleで読む
Kindle Unlimited 対象
Kindleで読む (¥1,500) トピック: ローカルLLMClaude CodeAIエージェントOllamaJev